AI 인프라
환경변수 하나로 Jev를 로컬로 옮기는 Ollaya, 정확도는 모델 따라 0.361과 0.722
9월 23일 공개된 Apache-2.0 런타임 Ollaya가 TypeSafe Jev의 API를 그대로 받습니다. 공식 SDK는 환경변수 한 줄로 로컬 서버에 연결되고, 오픈 결정 모델의 정확도는 laya:en 0.361에서 kev:9b 0.722까지 벌어집니다.
9월 23일 공개된 Apache-2.0 런타임 Ollaya가 TypeSafe Jev의 API를 그대로 받습니다. 공식 SDK는 환경변수 한 줄로 로컬 서버에 연결되고, 오픈 결정 모델의 정확도는 laya:en 0.361에서 kev:9b 0.722까지 벌어집니다.
AWS가 9월 21일 에이전트 하네스 Strands harness를 Apache 2.0으로 공개했습니다. 같은 Claude·GPT 모델을 쓰고도 벤치마크 6종 평균 토큰 비용이 28% 낮았고, 차이를 만든 건 도구 결과 절단과 85% 압축 같은 기본값입니다.
OpenAI가 9월 22일 GPT-6 Sol과 Luna를 공개했습니다. 입력 100만 토큰이 Sol 2달러, Luna 0.10달러로 전작의 절반이고, DeepSWE 최고 점수는 전작 72.7%보다 낮은 68.8%입니다.
Anthropic이 9월 22일 Claude Opus 5.5를 공개했습니다. 입력 100만 토큰 4달러로 Fable 5.1의 10달러보다 60% 싸고, Terminal-Bench 4.0은 Opus 5의 52.3%에서 66.4%로 올랐습니다.
PrismML이 9월 17일 Qwen3.8 27B를 5.9GB로 줄인 Ternary Bonsai 2 27B를 Apache 2.0으로 공개했습니다. 벤치마크 20종 평균은 98.2%를 유지하지만 장시간 코딩 과제 점수는 4분의 3으로 내려갑니다.
구글이 9월 15일 음성 모델 두 종을 냈습니다. 값싼 gemini-3.8-live는 종합 지수가 71.5%에서 76.0%로 올랐지만 도구를 쓰는 과제 완료율은 전작보다 낮습니다.
TypeSafe가 글 대신 선택지와 확률만 돌려주는 모델 Jev를 공개했습니다. 입력 100만 토큰 0.042달러에 출력은 무료지만, 자사 평가 정확도는 GPT-5.6 Luna와 비슷한 67%대로 Sol보다 약 6점 낮고 대기자 명단으로만 열립니다.
OpenRouter 자체 32일 벤치마크에서 DeepSeek V4 Flash 0731의 TAU-Bench 점수가 호스트별로 76.8%부터 46.4%까지 갈렸습니다. 운영자 실측 글이 HN 1위에 오르자 OpenRouter는 QoS 등급 도입을 예고했습니다.
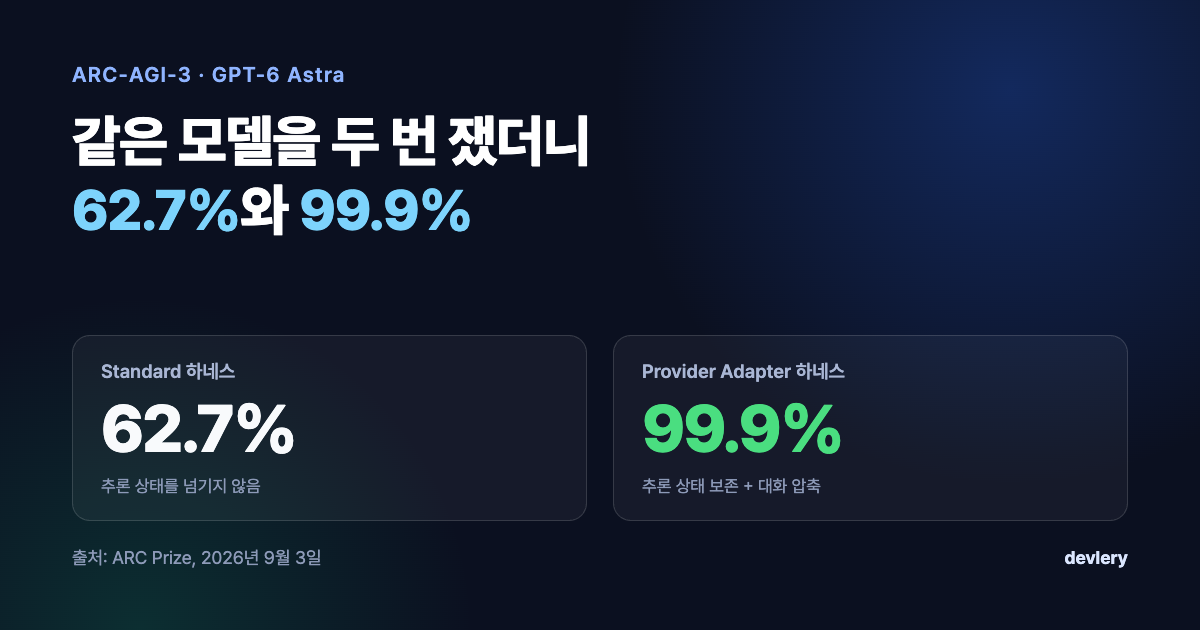
ARC Prize가 ARC-AGI-3에서 GPT-6 Astra를 두 조건으로 측정해 62.7%와 99.9%를 얻었습니다. 모델은 같고, 추론 상태를 다음 호출로 넘겼는지만 달랐습니다. 리더보드는 앞으로 두 점수를 함께 싣습니다.
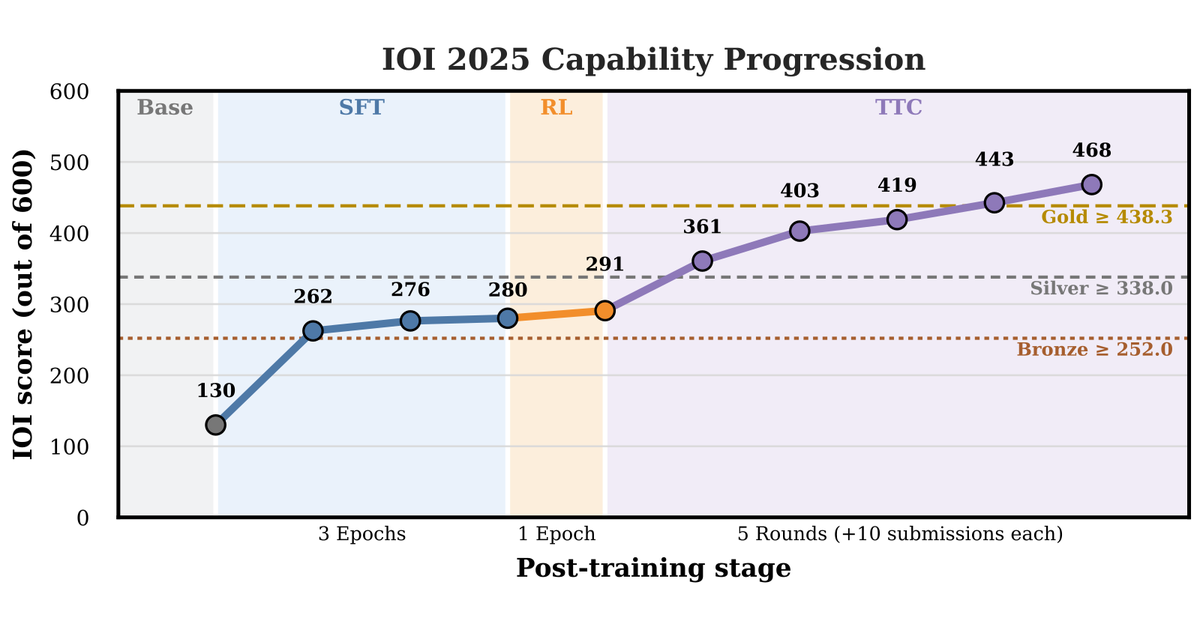
Nvidia Nemotron-3-Ultra-CC가 IOI 2026에서 535.4점을 받아 인간 최고 득점 498.27점을 넘었습니다. 논문 수치를 보면 점수의 대부분은 사후학습이 아니라 후보를 200개씩 다시 뽑는 테스트타임 루프에서 나왔습니다.
Armature가 Claude Code, Codex, Cursor에 실제 저장소 16,893회로 서드파티 서비스를 고르고 설치하게 했습니다. 세 에이전트가 같은 도구를 고른 비율은 42%였고, 저장소 언어가 바뀌면 이메일 제공자 승자도 바뀌었습니다.
MBZUAI 산하 IFM이 9월 3일 K2 Horizon 6종을 Apache 2.0으로 공개했습니다. 7B가 SWE-bench Verified 70.6%로 Qwen3.5-9B를 앞섰지만 훈련 코드 저장소와 데이터셋 링크는 아직 닫혀 있습니다.