GPT-6 Astra의 99.9%는 OpenAI 방식으로 잰 점수, 중립 조건에서는 62.7%
ARC Prize가 ARC-AGI-3에서 GPT-6 Astra를 두 조건으로 측정해 62.7%와 99.9%를 얻었습니다. 모델은 같고, 추론 상태를 다음 호출로 넘겼는지만 달랐습니다. 리더보드는 앞으로 두 점수를 함께 싣습니다.
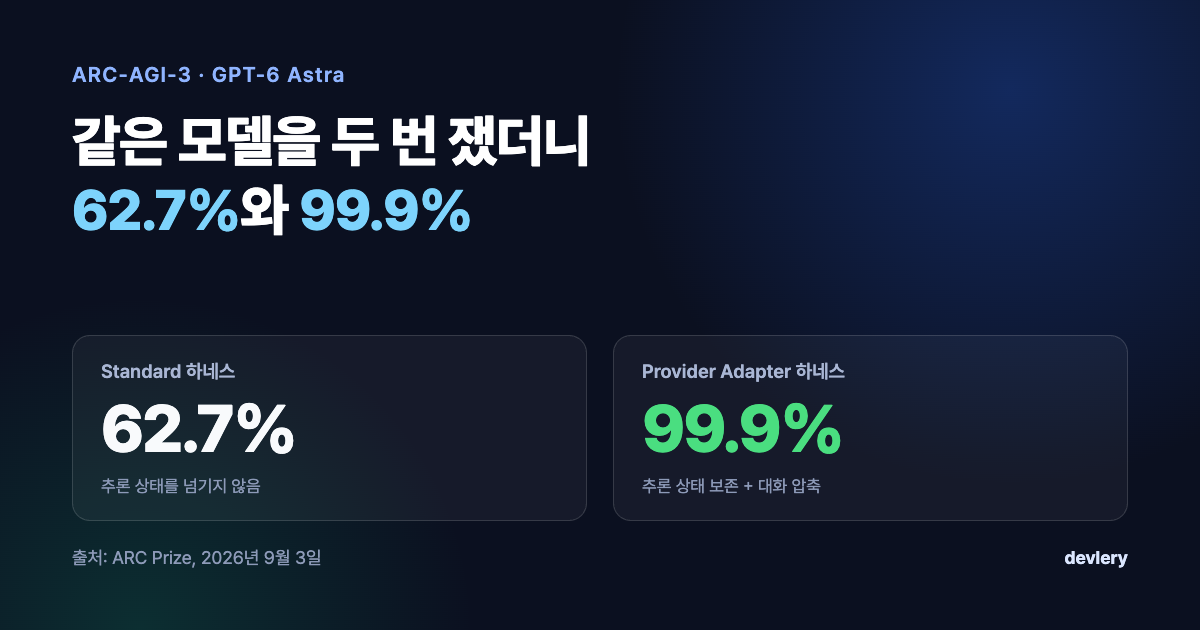
- 같은 GPT-6 Astra가 ARC-AGI-3에서 62.7%와 99.9%를 받았습니다.
- 차이는 모델이 아니라 추론 상태를 다음 호출로 넘겼는지였습니다.
- ARC Prize는 앞으로 두 조건의 점수를 함께 싣습니다.
ARC Prize가 9월 3일 GPT-6 Astra의 ARC-AGI-3 측정 결과를 올렸습니다. 같은 모델, 같은 문제 세트인데 점수가 두 개입니다. 62.7%와 99.9%입니다. 바뀐 것은 모델도 문제도 아니고 모델을 호출하는 바깥쪽 코드였습니다.
여기서 바깥쪽 코드를 ARC Prize는 하네스(harness)라고 부릅니다. 모델이 쓸 수 있는 도구, 호출과 호출 사이에 남겨두는 기억, 대화가 길어질 때 무엇을 버릴지를 정하는 프로그램입니다. 코딩 에이전트를 직접 만들어 본 독자라면 이미 하나 갖고 있습니다. 모델에 프롬프트를 보내고 응답을 받아 다음 요청을 조립하는 그 루프가 하네스입니다.
두 하네스가 실제로 다르게 한 것
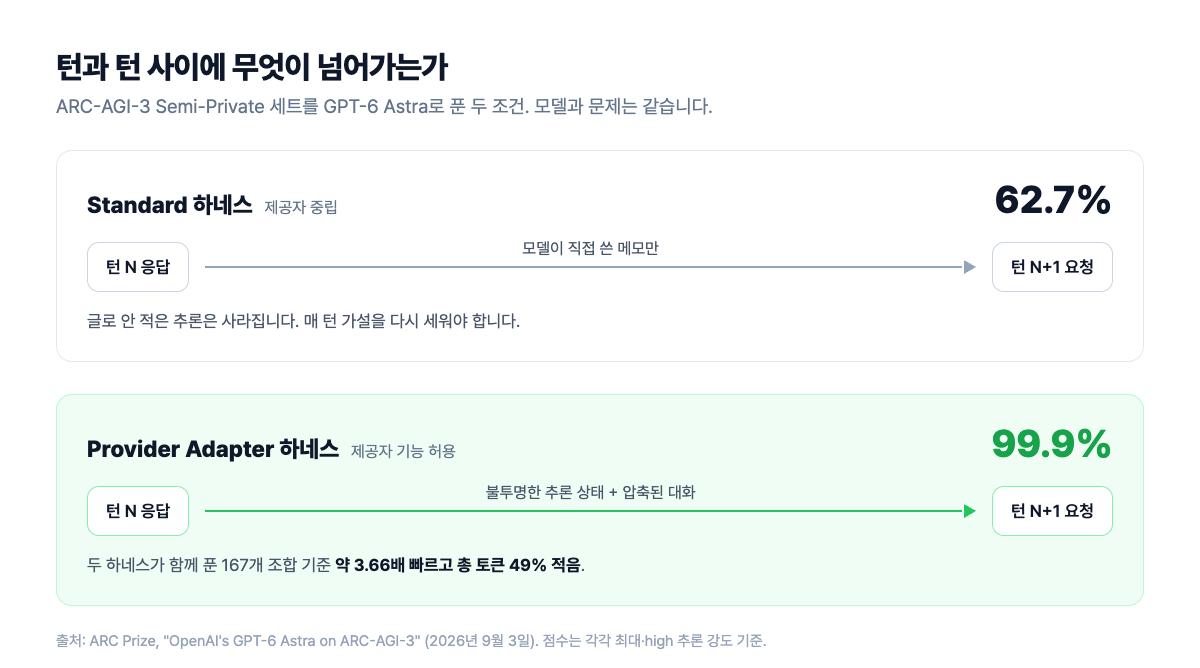
ARC Prize는 조건이 다른 두 하네스로 같은 모델을 각각 돌렸습니다. Standard 하네스는 제공자 중립입니다. "게임을 푸는 데 필요한 정보는 전부 주되, 무엇을 남길지는 모델이 결정하게" 둡니다. 모델이 남기는 것은 사람이 읽을 수 있는 메모뿐입니다. OpenAI든 Anthropic이든 Google이든 같은 조건에서 비교하려고 만든 장치입니다.
Provider Adapter 하네스는 제공자가 자기 모델용으로 만든 기능을 쓰게 허용합니다. Astra의 경우 ARC Prize는 이렇게 적었습니다. "요청과 요청 사이에 (우리가 볼 수 없는) 불투명한 추론 상태를 보존하고, 긴 대화를 관리하는 데 압축을 사용한다."
쉽게 말하면 Standard 쪽에서는 모델이 매 턴 자기가 무슨 생각을 했는지 글로 적어 남겨야 하고 안 적은 것은 사라집니다. Provider Adapter 쪽에서는 내부 추론이 글로 옮겨지지 않은 채로 다음 호출까지 살아남습니다. 이 차이가 왜 36%p까지 벌어지는지는 ARC-AGI-3가 어떤 시험인지를 봐야 이해됩니다.
ARC-AGI-3는 규칙을 알려주지 않는 턴제 게임입니다. 에이전트가 직접 움직여 보며 무엇이 목표인지 추측하고 환경의 규칙을 스스로 세워 계획을 짭니다. 사람은 100% 풉니다. ARC Prize가 모집한 일반인 약 500명 기준으로 게임 한 판 시도에 약 12.78달러가 들었습니다. 매 턴 세운 가설을 잃어버리면 처음부터 다시 추측해야 하는 종류의 과제입니다.
추론 강도별 결과는 이렇습니다. 오른쪽이 Provider Adapter입니다.
| 추론 강도 | Standard | 비용 | Provider Adapter | 비용 |
|---|---|---|---|---|
| max | 62.7% | $26,098 | 98.6% | $17,332 |
| xhigh | 59.3% | $37,317 | 98.4% | $18,147 |
| high | 54.8% | $40,705 | 99.9% | $18,817 |
| medium | 38.6% | $48,090 | 98.4% | $19,285 |
| low | 17.5% | $38,166 | 98.0% | $21,298 |
| none | 35.2% | $49,791 | 96.7% | $23,457 |
ARC-AGI-3 Semi-Private 세트, GPT-6 Astra. 비용은 세트 전체를 도는 데 든 총액입니다. 출처: ARC Prize (2026-09-03)
격차는 최대 추론 강도에서 36%p 가까이 벌어집니다. 더 눈에 띄는 것은 Provider Adapter 쪽은 추론을 아예 끈 상태(none)에서도 96.7%라는 점입니다. 추론을 최대로 올린 Standard 하네스의 62.7%보다 34%p 높습니다.
비용도 반대 방향입니다. 두 하네스가 함께 푼 167개 조합을 비교하니 Provider Adapter 쪽이 누적 경과 시간 기준 약 3.66배 빨랐고 총 토큰을 49% 적게 썼습니다. 점수가 높은 쪽이 돈도 덜 들었습니다. 같은 모델이 같은 문제를 풀 때 앞서 한 추론을 다시 만들지 않아도 되니 토큰이 줄어듭니다.
왜 Astra에서 이만큼 벌어졌나
Astra의 추론 방식이 이 격차를 키웠을 가능성이 있습니다. 다만 이건 공식 문서가 아니라 보도에 근거한 이야기라 그대로 확정할 수는 없습니다.
The Information은 Astra가 recurrent depth, 다른 이름으로 opaque recurrence라 불리는 방식을 쓴다고 보도했습니다. 같은 질의를 신경망 루프에 여러 번 통과시켜 푸는 방식으로, 생각의 과정이 사람이 읽을 수 있는 문장으로 옮겨지는 양이 줄어듭니다. OpenAI의 시스템 카드는 이 구조를 명시하지 않았습니다. 다만 Astra의 서술된 추론이 전작 GPT-5.6 Sol보다 감시하기 어렵다는 자체 평가 결과는 공개했습니다. 안전 연구자들이 9월 2일 TechCrunch 보도에서 문제를 제기한 지점도 여기입니다.
이 보도가 맞다면 Standard 하네스는 Astra에게 특히 불리합니다. 글로 안 적힌 추론이 많은 모델일수록, 매 턴 글로 적은 것만 남기는 조건에서 잃는 것이 큽니다. 반대로 같은 세트를 Standard 하네스로 돈 다른 모델들의 점수는 이렇습니다. Claude Opus 5가 30.2%, GPT-5.6 Sol이 7.8%입니다. 널리 인용된 99.9% 대 7.8%는 조건이 다른 두 숫자를 나란히 놓은 것이고, 같은 조건 비교는 62.7% 대 7.8%입니다.
내 에이전트 루프에서 같은 것을 켜려면
Provider Adapter가 한 일은 특별한 내부 기능이 아니라 두 회사가 문서로 공개한 API 옵션입니다. 직접 에이전트 루프를 만드는 개발자에게 해당하는 이야기입니다. 남이 만든 에이전트를 쓰기만 한다면 그 도구가 이미 켜뒀는지 확인하는 쪽입니다.
OpenAI Responses API에서는 요청에 include=["reasoning.encrypted_content"]를 넣으면 암호화된 추론 토큰을 받아 다음 요청에 그대로 되돌려 보낼 수 있습니다. 암호화된 내용은 클라이언트가 보관하고 OpenAI는 저장하지 않습니다. 요청에 들어오면 메모리에서만 복호화합니다. 대화 상태를 서버에 맡기는 쪽이면 previous_response_id를 넘기는 것만으로 이전 추론 아이템에 모델이 접근합니다.
Anthropic Messages API에서는 extended thinking을 켠 채 도구를 쓸 때 thinking 블록을 마지막 assistant 턴에 원본 그대로 전부 되돌려 보내야 합니다. 순서를 바꾸거나 내용을 손대면 안 됩니다. 문서는 항상 모든 thinking 블록을 되돌려 보내라고 권고합니다.
여기서 기대치를 낮춰 잡아야 하는 이유가 하나 있습니다. OpenAI 자체 측정에서 추론 아이템을 되돌려 보냈을 때의 향상은 SWE-bench 기준 약 3%입니다. ARC-AGI-3에서 본 36%p는 일반적인 코딩 과제에서 기대할 수 있는 숫자가 아닙니다. ARC-AGI-3는 매 턴 세운 가설을 다음 턴으로 넘겨야만 풀립니다. 그렇게 설계된 과제라 상태 보존의 효과가 극단적으로 드러납니다. 코드 한 파일을 고치는 작업은 그렇지 않습니다.
그래도 확인할 값어치는 있습니다. 3%든 36%p든 켜는 비용이 요청 파라미터 한 줄이고 토큰이 줄어드는 방향이라 요금이 오르지도 않습니다.
리더보드가 둘로 나뉩니다
ARC Prize는 앞으로 리더보드에 Standard 하네스와 Provider Adapter 하네스 결과를 조건 라벨과 함께 나란히 싣겠다고 밝혔습니다. 하나의 모델에 하나의 점수를 매기던 방식이 바뀝니다.
이 변경이 왜 필요했는지는 같은 주에 있었던 수치 수정 소동에서 드러납니다. TNW 정리에 따르면 9월 4일 Astra 출시 발표 몇 시간 안에 환각률이 4.2%에서 2%로 바뀌었다가 다시 4.2%로 돌아왔습니다. GPT-5.6 Sol의 ExploitBench 점수는 5.5%에서 11.5%로 두 배가 됐습니다. ARC-AGI-3 수치도 사전 초안의 98.6%가 게시본에서 99.99%로 바뀌었습니다. OpenAI는 Fortune에 "대부분의 평가는 체크포인트와 평가 조건에 따라 몇 퍼센트포인트의 잡음을 갖는다"고 밝혔습니다. 격차 자체를 설명하지는 않았습니다.
ARC Prize 공동창업자 Mike Knoop은 이 결과를 AGI라 부를 근거는 아직 없다고 선을 그었습니다. ARC Prize 본문도 벤치마크를 포화시키는 것이 "AGI 달성의 증거"는 아니며 ARC-AGI-3의 범위와 형식이 좁게 한정돼 있다고 적었습니다.
지금 쓸 수 있나
| 항목 | 조건 |
|---|---|
| ARC-AGI-3 Semi-Private 세트 | 비공개. 이 점수를 직접 재현할 수는 없습니다 |
| ARC-AGI-3-Agents 하네스 코드 | 공개. github.com/arcprize/ARC-AGI-3-Agents에서 받아 사이트에서 발급한 API 키로 무료 실행 |
| 하네스가 지원하는 제공자 | Anthropic, OpenAI, Google, xAI, DeepSeek, Groq, OpenRouter, Fireworks. 각자의 API 키 필요 |
| OpenAI 추론 아이템 재전달 | 모든 Responses API 사용자. 별도 요금제·승인·추가 과금 없음 |
| Anthropic thinking 블록 재전달 | extended thinking을 지원하는 모델을 쓰는 모든 Messages API 사용자 |
| 한국 사용 가능 여부 | 셋 다 가능합니다. ARC-AGI-3 키 발급과 두 API 모두 지역 제한이 없습니다 |
에이전트 루프를 직접 짜서 돌리는 팀이라면 지금 보내는 요청에 이전 턴의 추론이 실려 있는지부터 확인합니다. OpenAI 쪽은 응답에 reasoning 아이템이 들어오는지와 그것을 다음 요청에 다시 넣는지, Anthropic 쪽은 thinking 블록을 잘라내고 있지 않은지를 봅니다. 도구를 여러 번 부르는 긴 작업 하나를 골라 켠 채로 한 번, 끈 채로 한 번 돌려 성공 여부와 총 토큰을 비교하면 자기 작업에서 실제로 얼마나 벌어지는지 나옵니다. 벤치마크 표를 읽을 때는 GPT-6 Astra 출시 때 지적된 것과 같은 질문을 하나 더 하면 됩니다. 이 숫자는 누구의 하네스에서 나왔는지입니다.