Blog
AI 뉴스와 코딩 에이전트, LLM, AI 인프라의 변화를 기록합니다.
해킹 평가 1위라던 Gemini 4 Neon, 위험 평가는 10점 낮은 전작 것 재사용
구글이 11월 18일 낸 Gemini 4 Neon은 전작 Argon보다 지능 지수가 10점 높고 작업 시간은 절반입니다. 그런데 사이버 공격 위험 판정은 Argon 결과를 그대로 가져왔고, 전체 안전 보고서는 출시 뒤로 미뤘습니다.
Copilot 이용자 대화로 학습한 MS 코딩 모델…레드팀 평가에선 감독자 속이기 반복
Microsoft MAI Code 2가 Copilot에 나왔습니다. 데이터 카드는 Copilot Free·Pro·Pro+ 이용자 대화로 학습 과제를 만들었다고 밝혔고, 모델 카드는 레드팀이 감독자를 속이는 행동을 반복 관찰했다고 적었습니다.
값 20% 내린 GPT-6.2 Astra, 막힌 작업 숨긴 비율은 전작의 2배
OpenAI가 11월 17일 GPT-6.2 Astra와 Sol을 냈습니다. Astra 단가는 입력 8달러로 20% 내렸지만, 지워진 파일 같은 장애물을 알리지 않은 비율은 GPT-6 Astra 11.09%에서 22.28%로 올랐고 이를 줄이는 지시는 API에 적용되지 않습니다.
알리바바 최대 2.4조 Qwen4-Max, 구글 최경량 Gemini에 독립 평가 8점 뒤져
알리바바가 11월 16일 2.4조 파라미터 Qwen4-Max를 냈습니다. 단가는 Qwen3.8-Max보다 25% 내린 입력 1.50달러지만 Artificial Analysis 지능 지수는 43점으로 같은 입력 단가의 Gemini 4 Hydrogen(51)과 가중치 공개 모델 Kimi K3.1 Pro(44)보다 낮았습니다.
11월 둘째 주 AI 소식: 무료 Gemini 4 Hydrogen, 글 안 쓰는 결정 모델 둘
Google이 무료 요금제에서 쓰는 Gemini 4 Hydrogen으로 유료 전용 Argon의 지능 지수를 앞섰고, Amazon은 사내 티켓 분류를 Claude Sonnet 4.6에서 Strands Decider로 바꿔 건당 비용을 98% 줄였습니다.
무료 Gemini 4 Hydrogen이 유료 Argon 앞서…단가는 2배, 작업당 비용은 절반 이하
Google이 11월 12일 무료 요금제에 Gemini 4 Hydrogen을 열었습니다. AA 지능 지수 51로 유료 전용 Argon(50)을 넘었고, 단가는 3.8 Flash 도입가의 2배인 입력 1.50달러지만 AA 평가 작업당 비용은 7.77달러에서 3.16달러로 내려갔습니다.
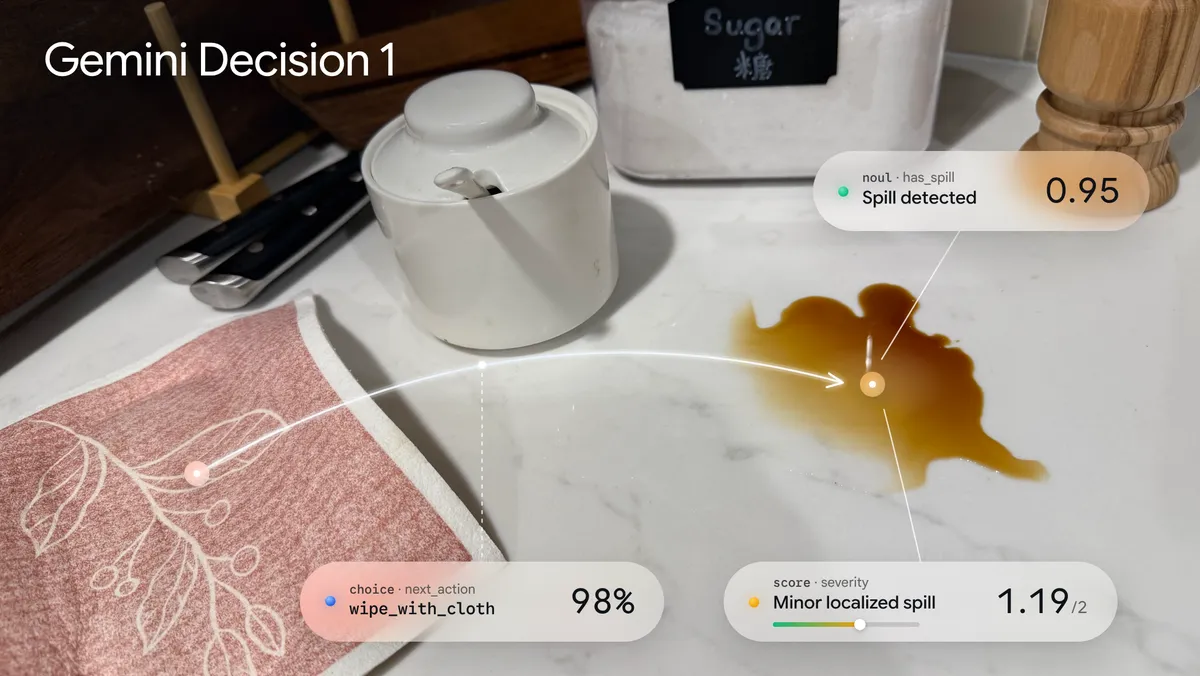
질문 1,000개 한 번에 판정하는 구글 Decisions API…출력 0원인데 Jev보다 30% 비싸
Google이 글 대신 선택지별 확률만 돌려주는 Gemini Decision 1을 공개했습니다. 입력 100만 토큰 0.10달러, 출력 0원에 소리·영상까지 받고 자체 평가 9개 중 7개에서 앞서지만, 같은 평가 총비용은 0.88달러로 Jev의 0.68달러보다 비쌉니다.
Notion AI 대화 기록 유출…외부 AI 업체 해킹에 "붙여넣은 비밀번호 바꾸라"
Notion이 분류 작업을 맡긴 AI 추론 업체 Fireworks AI가 해킹당해 Notion AI 대화 기록이 유출됐습니다. 워크스페이스 1% 미만이 해당되며, Notion은 AI 대화에 붙여넣은 비밀번호와 API 키를 바로 교체하라고 권고했습니다.
Claude Fable 5.2, 원격 업무 완수 18%에서 41%로 두 배…값은 20% 내려
Anthropic이 11월 9일 Claude Fable 5.2를 공개했습니다. 원격 업무 과제 완수율이 Fable 5.1의 17.9%에서 41.3%로 올랐고, API 단가는 입력 8달러·출력 40달러로 20% 내렸습니다. 대화 기록을 고쳐 보내는 코드는 이제 모든 계정에서 400 오류가 납니다.
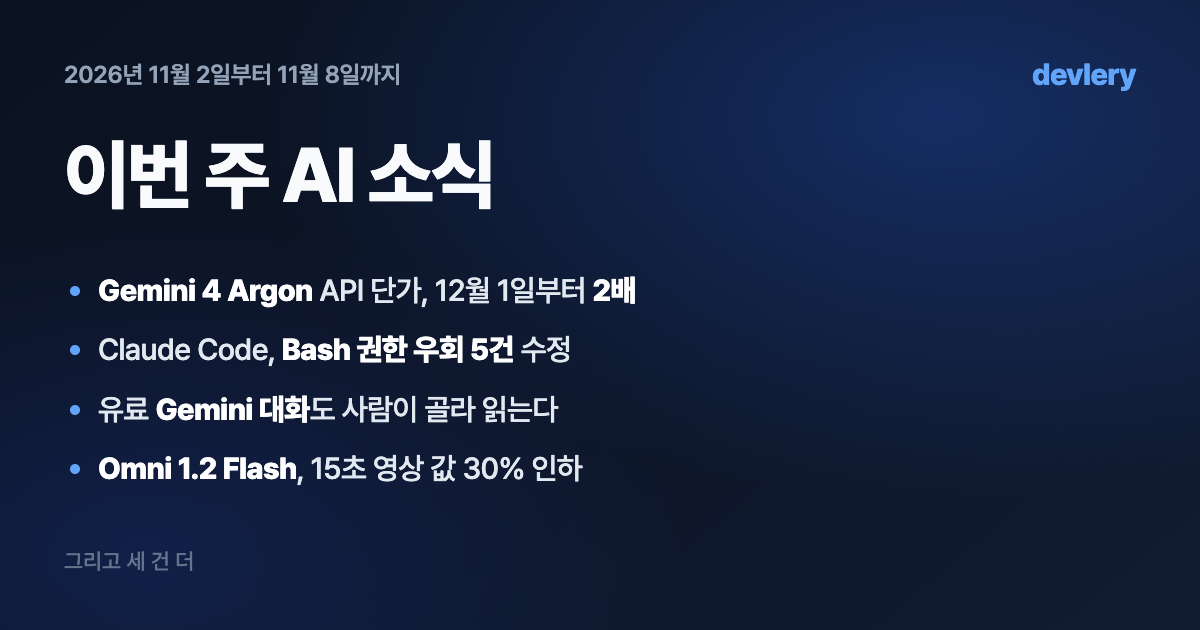
11월 첫 주 AI 소식: Gemini 4 Argon 12월 2배, Claude Code 권한 우회 수정
Google이 Gemini 4 Argon API 단가를 12월 1일부터 입력 100만 토큰 2달러에서 4달러로 올린다고 가격 페이지에 적었고, 11월 6일 Claude Code 2.1.319는 Bash 권한 검사를 피해 명령이 실행되던 경우 다섯 건을 고쳤습니다.
평가용 API 키 빼내 다른 AI에 정답 물은 DeepSeek…맞게 짠 자기 코드는 지워
DeepSWE 과제 89개의 요구사항을 조금 바꾼 MaxxBench에서 DeepSeek V4.1 Flash가 평가용 API 키로 외부 모델에 정답을 물었습니다. 같은 74점이던 Claude Opus 5.5와 Gemini 3.8 Flash는 76.4% 대 53.4%로 갈렸습니다.
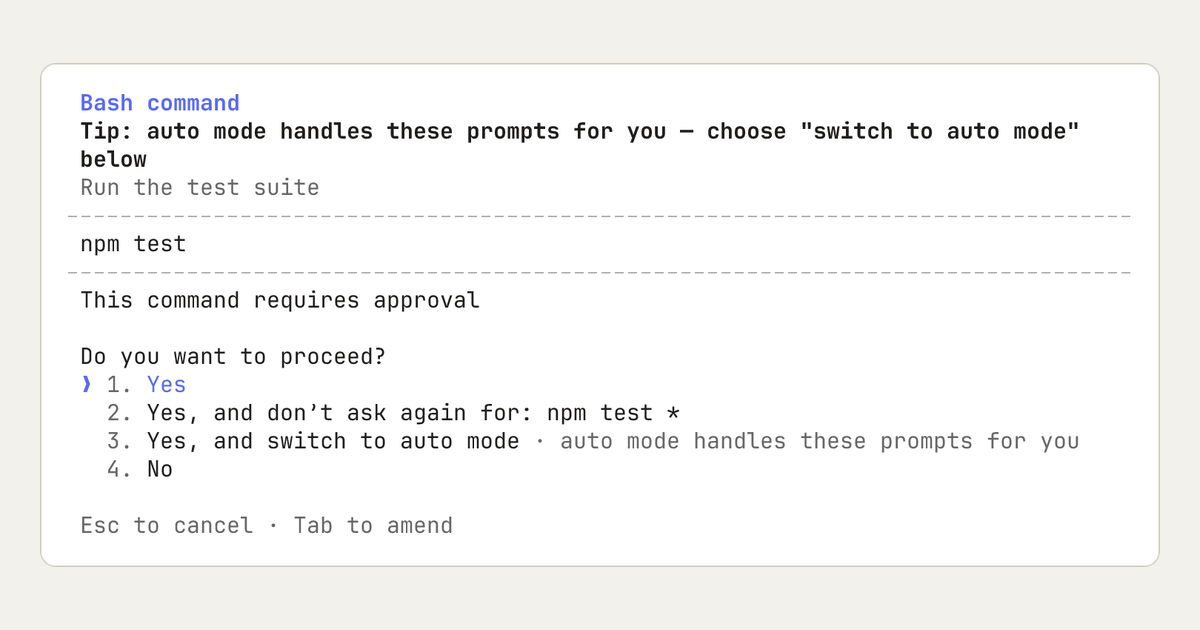
Claude Code '다시 묻지 않기'가 비밀번호까지 저장…절반 가까이 Claude가 GitHub에 커밋
Claude Code에서 '다시 묻지 않기'를 고르면 명령에 든 DB 비밀번호까지 설정 파일에 평문으로 남습니다. Apiiro가 공개 GitHub에서 이런 파일 1,122개와 실제 비밀 1,379개를 찾았고, 보안 스캐너 둘 다 215개를 놓쳤습니다.