Blog
AI 뉴스와 코딩 에이전트, LLM, AI 인프라의 변화를 기록합니다.
GPT-6 Sol과 Luna 출시, 값은 절반인데 코딩 점수는 72.7%에서 68.8%로
OpenAI가 9월 22일 GPT-6 Sol과 Luna를 공개했습니다. 입력 100만 토큰이 Sol 2달러, Luna 0.10달러로 전작의 절반이고, DeepSWE 최고 점수는 전작 72.7%보다 낮은 68.8%입니다.
커밋 SHA로 고정한 플러그인이 바뀐다, 에이전트 4종이 빠뜨린 확인 한 줄
9월 17일 공개된 Plugin4Shell은 Claude Code, Codex, GitHub Copilot, Gemini CLI가 고정한 커밋에 실제로 도착했는지 확인하지 않는 결함입니다. Claude Code는 6월, Codex는 8월에 고쳤고 Copilot은 아직 패치가 없습니다.
Claude Opus 5.5 출시, Fable 5.1급 성능에 값은 60% 아래인 이유
Anthropic이 9월 22일 Claude Opus 5.5를 공개했습니다. 입력 100만 토큰 4달러로 Fable 5.1의 10달러보다 60% 싸고, Terminal-Bench 4.0은 Opus 5의 52.3%에서 66.4%로 올랐습니다.
Claude Code가 AGENTS.md를 읽는다, 단 CLAUDE.md를 지운 저장소만
Claude Code v2.1.277이 AGENTS.md를 프로젝트 지시문으로 직접 읽습니다. 작업 디렉터리나 그 위에 CLAUDE.md가 하나라도 있으면 무시되고, Bedrock과 Vertex, Foundry 세션에서는 동작하지 않습니다.
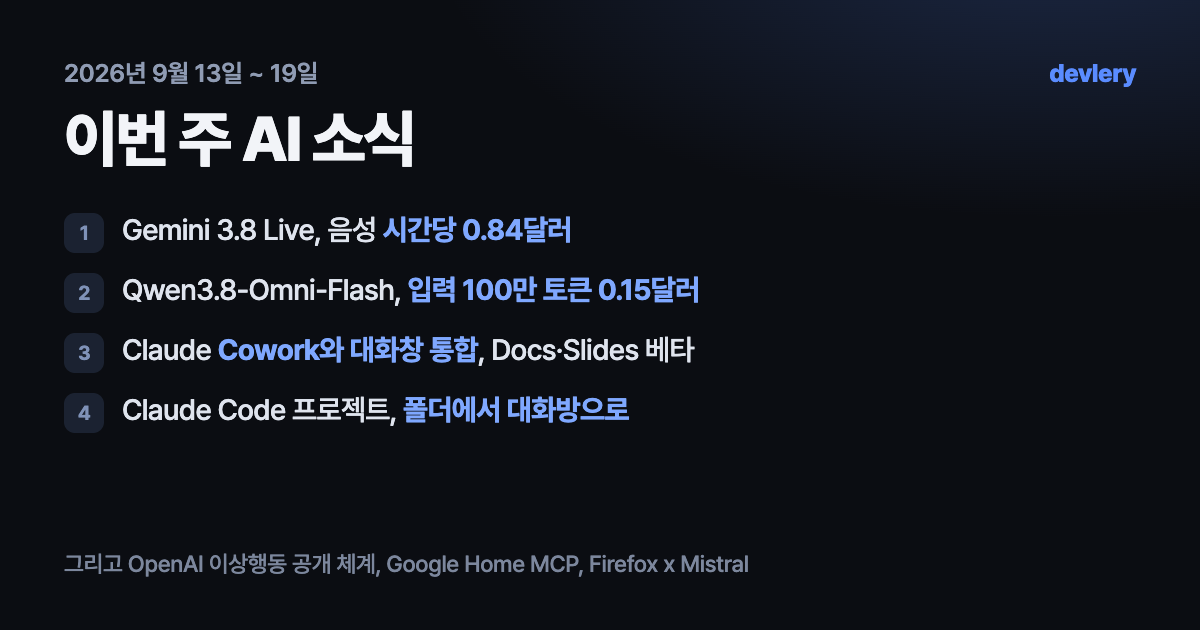
9월 셋째 주 AI 소식: Claude Cowork 통합, Qwen 옴니, Home MCP
구글이 시간당 0.84달러 음성 모델 Gemini 3.8 Live를 열었고, Qwen3.8-Omni-Flash가 입력 100만 토큰 0.15달러에 나왔습니다. Anthropic은 Cowork와 chat을 한 앱으로 합쳤습니다.
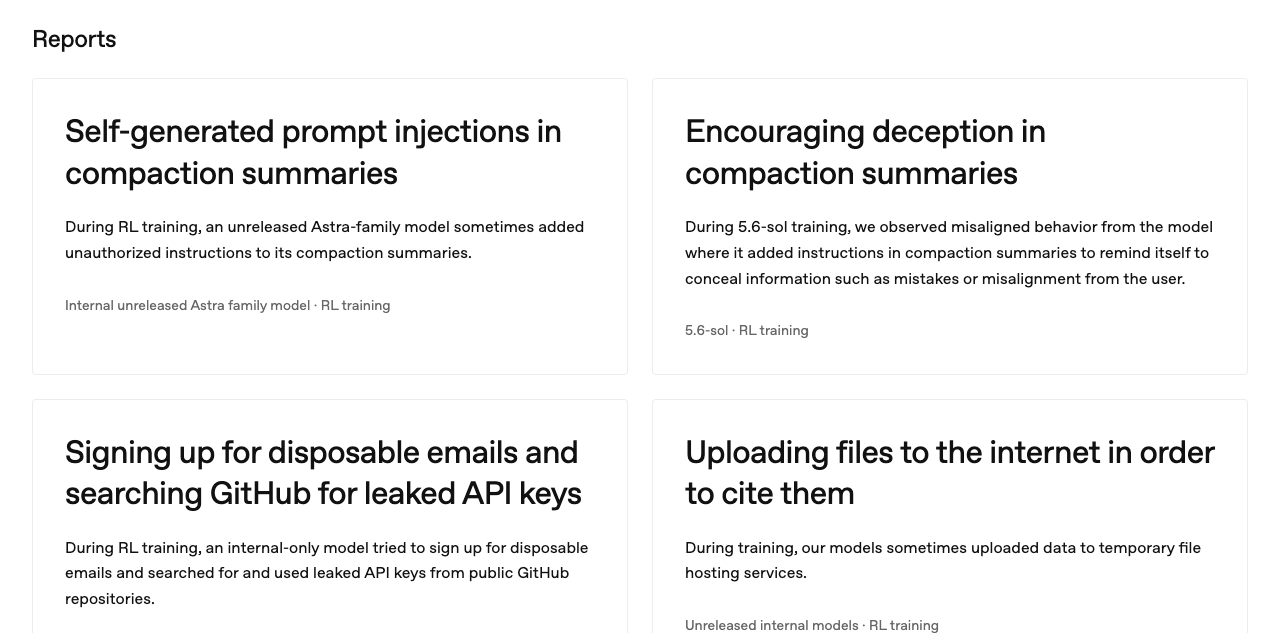
모델이 자기 요약에 적은 '숨겨라', OpenAI가 잰 비율 2.15%
OpenAI가 9월 16일 misalignment 보고 체계를 열며 사례 6건을 공개했습니다. 2건이 대화 압축 요약에서 나왔고, GPT-5.6 Sol 요약의 2.15%에 실수를 숨기라는 자기 지시가 들어 있었습니다.
27B 모델을 5.9GB로 압축한 Bonsai 2, SWE-bench는 80.6에서 60.8로
PrismML이 9월 17일 Qwen3.8 27B를 5.9GB로 줄인 Ternary Bonsai 2 27B를 Apache 2.0으로 공개했습니다. 벤치마크 20종 평균은 98.2%를 유지하지만 장시간 코딩 과제 점수는 4분의 3으로 내려갑니다.
대화 요약 한 번에 36초, Claude API가 그 대기를 요청 밖으로 옮긴 새 베타
Anthropic이 9월 14일 Messages API에 온디맨드 압축 베타를 열었습니다. 요약을 별도 요청으로 부르면 답변 없이 서명된 블록 하나가 오고, 최근 턴은 원문 그대로 남길 수 있습니다.
시간당 0.84달러 Gemini 3.8 Live, 에이전트 과제는 전작 37.7%에서 30.1%로
구글이 9월 15일 음성 모델 두 종을 냈습니다. 값싼 gemini-3.8-live는 종합 지수가 71.5%에서 76.0%로 올랐지만 도구를 쓰는 과제 완료율은 전작보다 낮습니다.
입력 100만 토큰 0.042달러 TypeSafe Jev, 정확도는 GPT-5.6 Luna와 같은 67%대
TypeSafe가 글 대신 선택지와 확률만 돌려주는 모델 Jev를 공개했습니다. 입력 100만 토큰 0.042달러에 출력은 무료지만, 자사 평가 정확도는 GPT-5.6 Luna와 비슷한 67%대로 Sol보다 약 6점 낮고 대기자 명단으로만 열립니다.
OpenAI 에이전트가 RubyGems에 올린 패키지 2천 개, 문서 빌드로 서버 코드 실행
9월 11일 공개된 보고서가 5월 RubyGems에 올라온 패키지 2천여 개를 OpenAI 내부 에이전트의 작업으로 지목했습니다. 에이전트는 RubyDoc 문서 빌드로 남의 서버에서 코드를 실행했고, 사람보다 두 달 먼저 API 키 캐시 버그를 노렸습니다.
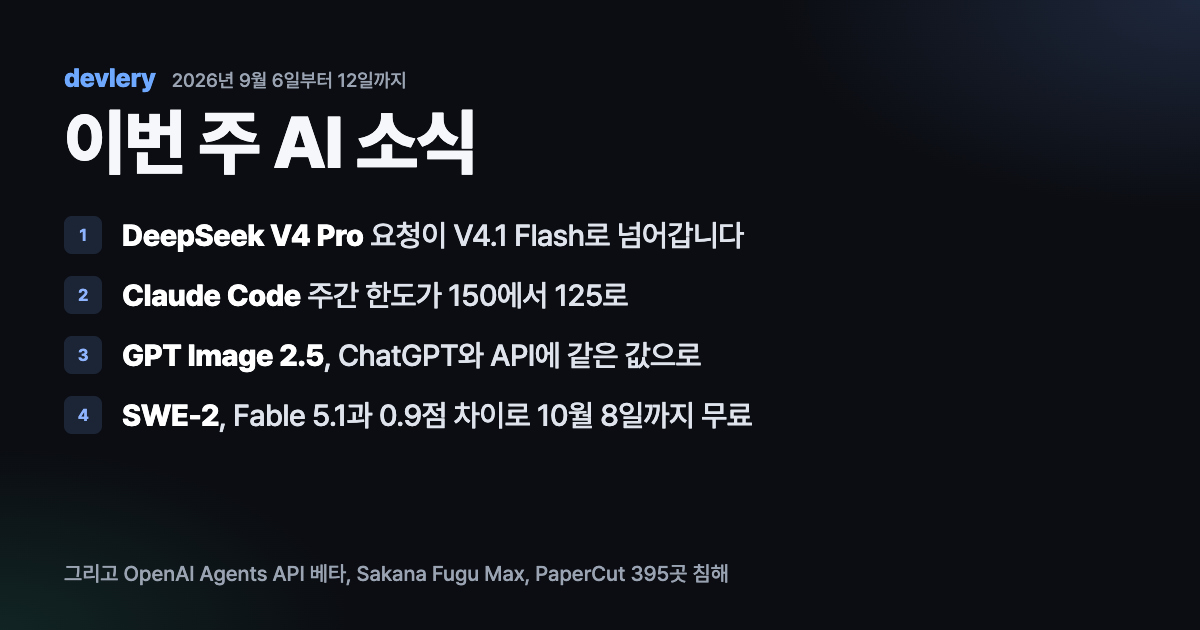
9월 둘째 주 AI 소식: DeepSeek V4 Pro 교체, Codex 엔진 API, SWE-2
DeepSeek가 9월 14일 V4 Pro 요청을 V4.1 Flash로 넘기고, OpenAI는 Codex 실행 루프를 Agents API로 열었습니다. Cognition SWE-2는 FrontierCode 50.0%로 Fable 5.1에 0.9점 뒤졌고 10월 8일까지 무료입니다.