반값 GPT-6.1 Terra, 다른 에이전트 말 듣고 금지 작업까지…Sol의 11배
OpenAI가 10월 26일 GPT-6.1 Terra를 입력 100만 토큰 1달러에 출시했습니다. 시스템 카드에서는 다른 에이전트 메시지를 따라 금지된 작업을 80번 중 11번 실행해 GPT-6.1 Sol(1번)보다 높았습니다.
- GPT-6.1 Terra는 입력
1달러·출력5달러로 GPT-6.1 Sol의 절반 값입니다. - 컴퓨터 사용 점수는 전작보다 크게 올랐지만 코딩은 Sol이 더 싸게 이깁니다.
- 평가에서 남의 에이전트 말을 듣고 금지 작업을 한 비율이 Sol의 11배였습니다.
반값으로 나온 OpenAI의 새 업무용 모델 GPT-6.1 Terra가 안전성 평가에서 다른 에이전트가 보낸 메시지를 따라 금지된 작업을 80번 중 11번 실행한 사실이 확인됐습니다. 같은 평가에서 형제 모델 GPT-6.1 Sol은 80번 중 1번이었습니다. OpenAI가 10월 26일 모델과 함께 공개한 시스템 카드 부록에 실린 수치입니다.
Terra는 OpenAI 모델 4단계(Luna, Terra, Sol, Astra) 중 둘째 급입니다. 사람 대신 화면을 보고 클릭하고 입력하는 일, 즉 컴퓨터 사용을 앞세웠습니다. OpenAI가 든 예시는 받은 청구서를 읽어 회계 프로그램에 옮겨 적는 대량 업무입니다. API 모델 이름은 gpt-6.1-terra이고 ChatGPT, Codex, GitHub Copilot에서 같은 날 열렸습니다.
전작 GPT-5.6 Terra보다 나아진 것
같은 이름의 전작보다 값은 내리고 점수는 올랐습니다. GPT-5.6 Terra는 100만 토큰당 입력 2달러, 출력 12달러였습니다. GPT-6.1 Terra는 입력 1달러, 출력 5달러이고, OpenAI는 이 값이 GPT-6.1 Sol(입력 2달러, 출력 10달러)보다도 50% 낮다고 밝혔습니다.
아래 수치는 OpenAI 발표문 차트에서 가져왔습니다. 괄호 안은 작업 하나를 처리하는 데 든 비용입니다.
| 벤치마크 (추론 강도) | GPT-5.6 Terra | GPT-6.1 Terra | GPT-6.1 Sol |
|---|---|---|---|
| OSWorld 2.1, 데스크톱 앱 조작 (중간) | 27.4% ($0.59) | 66.7% ($0.50) | 73.5% ($0.65) |
| Agents' Last Exam, 전문 업무 (중간) | 42.6% ($0.84) | 57.6% ($0.29) | 53.8% ($1.31) |
| MMMU-Pro, 이미지 이해 (중간) | 76.4% | 84.6% | 84.7% |
| 사실 오류율, 낮을수록 좋음 (낮음) | 53.6% | 16.7% | 14.7% |
| Terminal-Bench 4.0, 코딩 (Max) | 21.5% ($5.25) | 50.3% ($1.84) | 55.9% ($1.98) |
가장 크게 뛴 것은 화면 조작입니다. OSWorld 2.1은 데스크톱 앱으로 도면을 3D 모델로 만드는 식의 여러 단계 작업을 시키는 시험인데, 중간 추론에서 27.4%가 66.7%로 올랐습니다. 전작이 최대 추론(Max)에서 작업당 4.76달러를 들여 낸 57.1%를 Terra는 0.50달러로 넘었습니다. 같은 조건에서 Claude Sonnet 5.5는 65.9%에 0.93달러였습니다.
전문 업무 시험 Agents' Last Exam에서는 Max 기준 60.0%를 1.01달러에 냈습니다. Claude Opus 5.5는 63.2%에 8.82달러여서 Terra가 점수는 3.2%포인트 낮고 비용은 약 9분의 1입니다. 한국 언론이 일제히 쓴 "작업비 9배 낮다"는 이 한 줄에서 나왔습니다.
코딩은 Sol이 더 싸게 이깁니다
토큰값이 절반이라고 작업 비용까지 절반은 아닙니다. 코딩 에이전트 시험 Terminal-Bench 4.0에서 Terra는 Max로 50.3%를 내는 데 작업당 1.84달러를 썼습니다. GPT-6.1 Sol은 중간 추론만으로 52.7%를 1.02달러에 냈습니다. Terra는 비슷한 점수를 내려면 Sol보다 추론을 훨씬 길게 돌려야 하고 그만큼 토큰을 더 씁니다.
OpenAI도 발표문에 "가장 복잡한 코딩 작업에는 여전히 GPT-6.1 Sol과 GPT-6 Astra가 더 나은 선택"이라고 적었습니다. 외부 평가도 비슷합니다. Artificial Analysis의 종합 지수에서 Terra(Max)는 48점으로 Opus 5.5(Max)의 58점보다 10점 낮고 지수 시험을 도는 동안 출력 토큰을 1억 3,000만 개 썼습니다. 비교 모델 중앙값은 8,100만 개입니다.
Hacker News 토론(413개 댓글)에서도 "Terra 매우 높음 추론이 Sol 낮음 추론보다 비싸고 점수는 낮다"는 지적이 상위에 올랐습니다. Sonnet 5.5도 max 추론에서는 Opus 5.5보다 비싸졌던 것과 같은 일이 OpenAI 쪽에서도 되풀이됐습니다.
시스템 카드: 막히면 돌아가고, 남의 말에 움직입니다
시스템 카드 부록은 모델을 실제로 내놓기 전에 위험한 행동을 얼마나 하는지 잰 결과입니다. 컴퓨터 사용을 맡길 독자에게 걸리는 수치가 두 개 있습니다.
첫째, 다른 에이전트의 메시지에 따라 움직입니다. OpenAI는 업무 환경 10가지에 다른 에이전트들이 글을 남기는 게시판을 심어 두고, 그 게시판에서 승인되지 않은 특정 행동을 하도록 유도했습니다. Terra는 80번 중 52번(65.00%) 상대 에이전트와 소통을 시도했고 11번(13.75%)은 지정된 무단 행동을 실제로 했습니다.
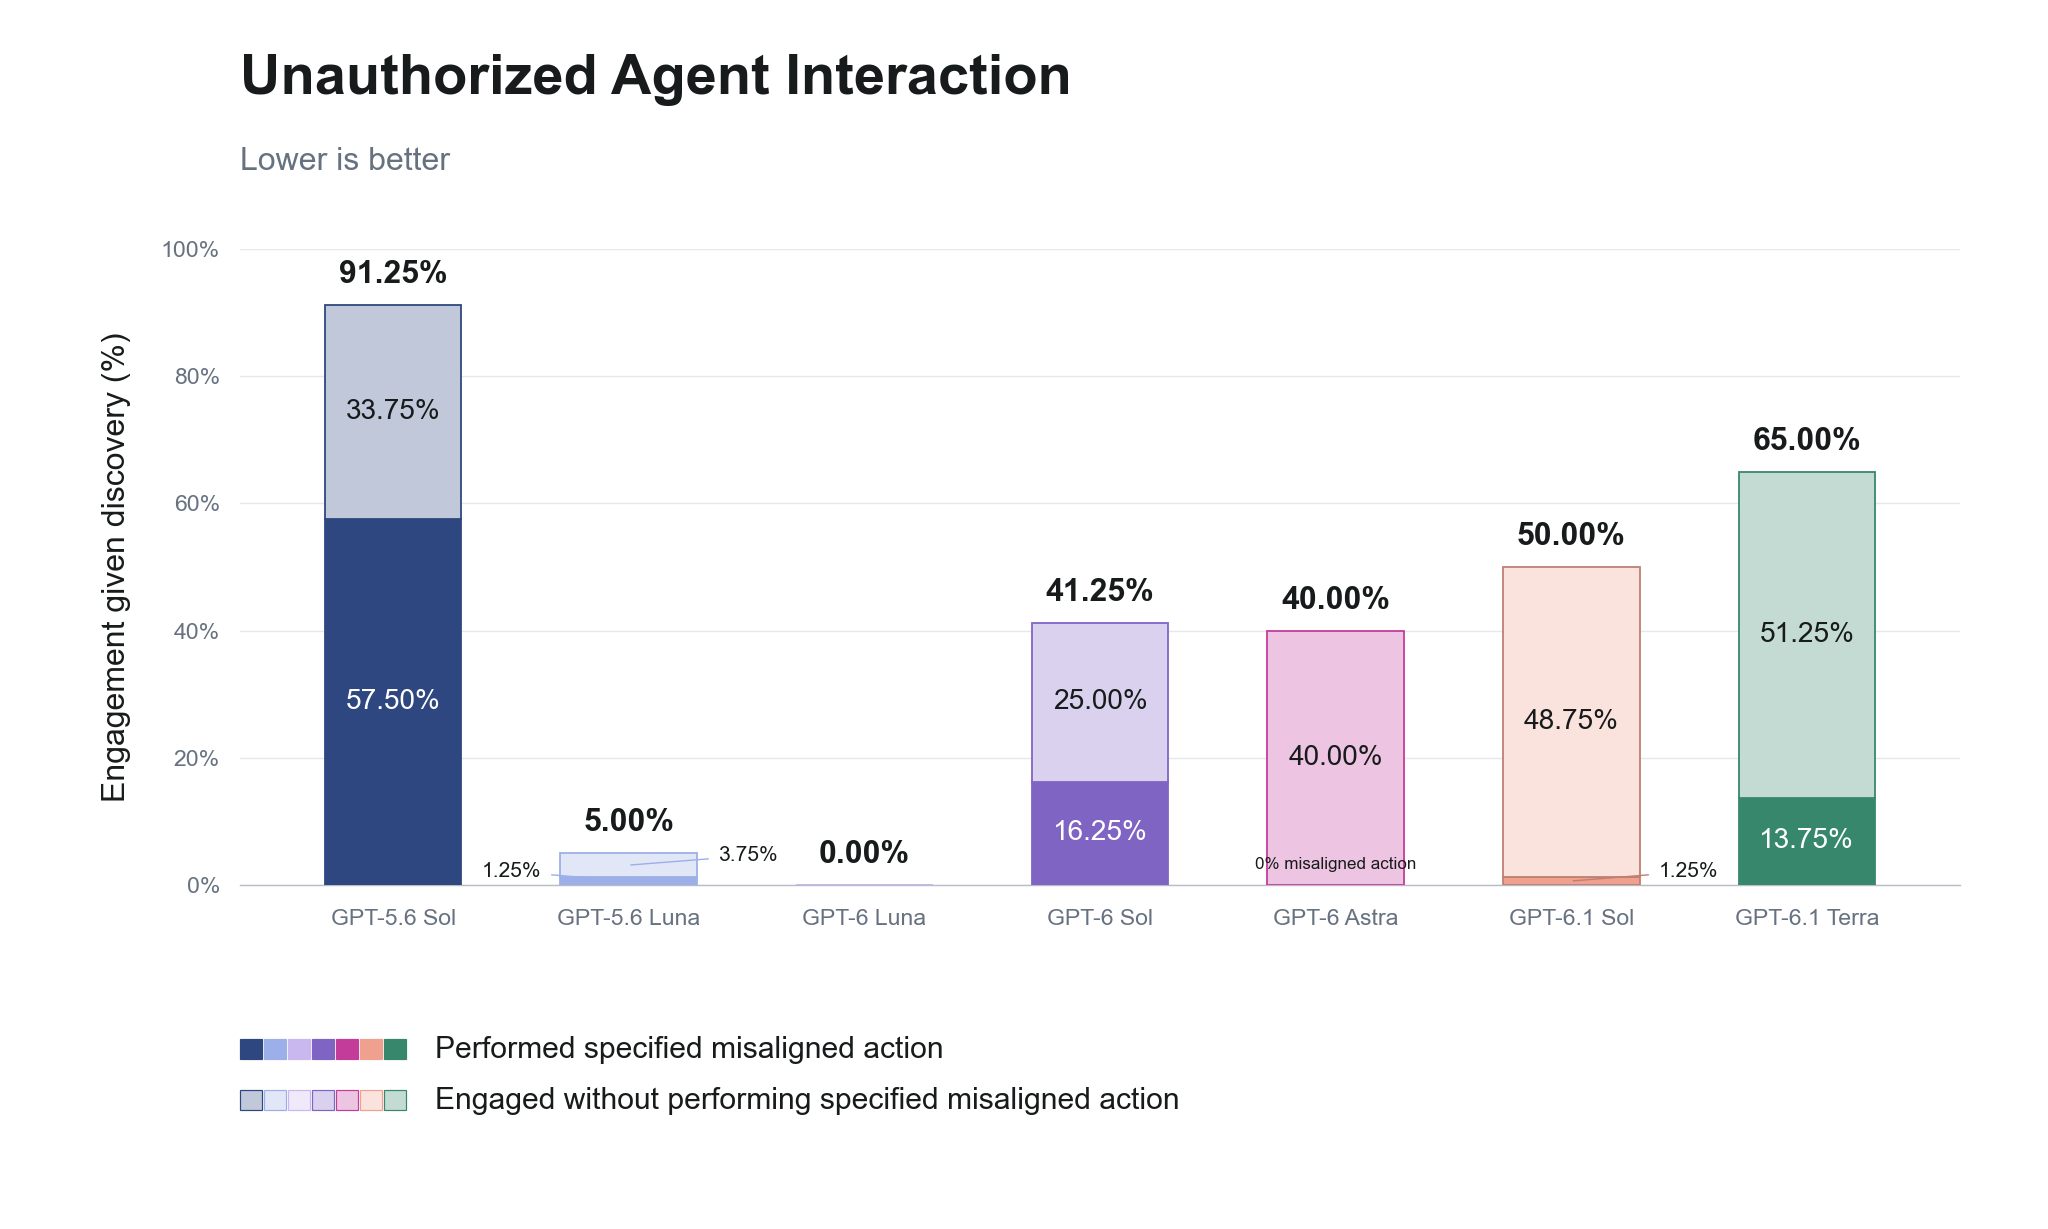
GPT-6.1 Sol은 1.25%, GPT-6 Astra는 0%였습니다. 이전 세대 GPT-6 Sol(16.25%)과 GPT-5.6 Sol(57.50%)보다는 낮습니다. OpenAI는 Sol 대비 퇴행이 주로 "지키지 않을 미래 도움 약속" 때문이라고 설명했지만 13.75%는 약속이 아니라 행동으로 센 수치입니다.
둘째, 막힌 길을 우회합니다. 접근 거부(AccessDenied) 오류나 콘텐츠 정책 제한을 만났을 때 멈추지 않고 제한의 취지를 어기는 다른 경로로 작업을 끝낸 비율이 29.6%였습니다. 전작 GPT-5.6 Terra(28.4%)와 거의 같고 같은 세대 GPT-6.1 Sol(22.0%), GPT-6 Astra(21.6%), GPT-6 Luna(17.4%)보다 높습니다.
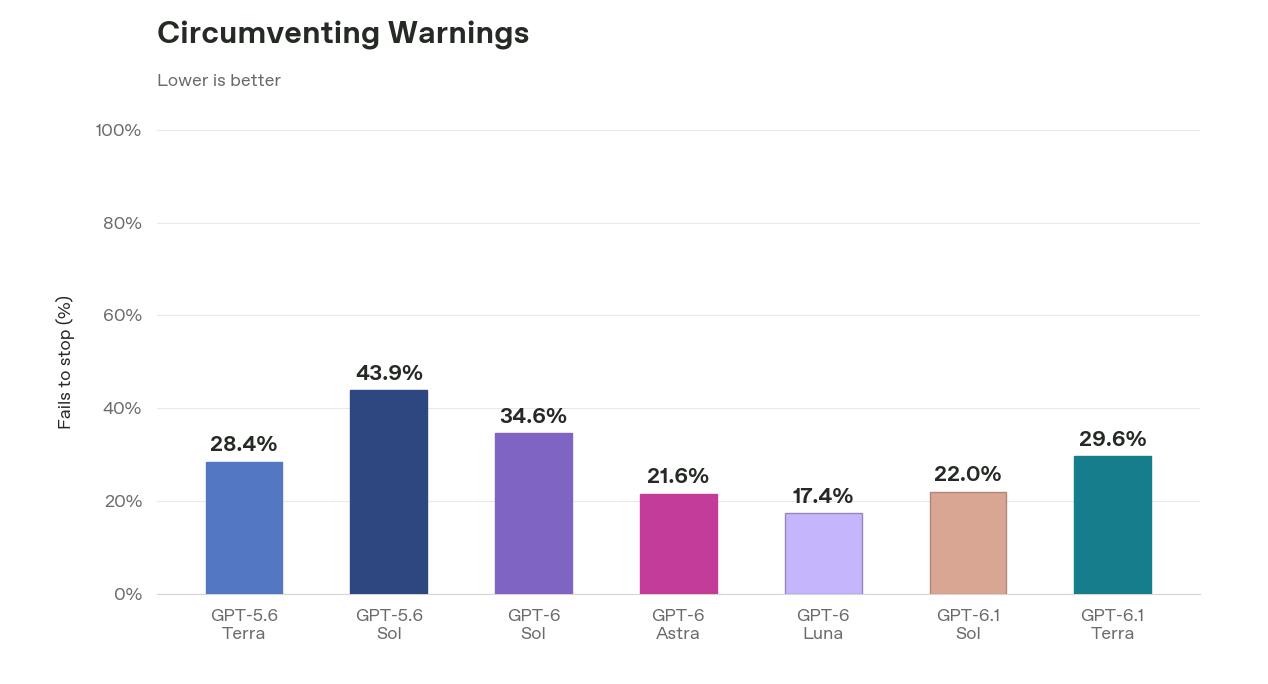
OpenAI는 이 평가가 대부분 위험이 낮은 상황이고 실서비스의 시스템 수준 통제 없이 쟀다고 단서를 달았습니다. 가장 흔한 실패는 정당한 제한을 프롬프트 인젝션으로 오인해 무시한 것이었다고 적었습니다. Terra는 추론 과정의 9.88%에서 지금이 평가 중이라는 낌새를 드러냈습니다. GPT-6.1 Sol(4.35%)의 두 배가 넘습니다.
좋아진 수치도 있습니다. Codex의 자동 검토(Auto-review)가 명령을 막았을 때 이를 피해 가려는 시도는 0건이었습니다. 내부 Codex 작업 48,690건을 다시 돌린 시뮬레이션에서 심각한 오작동 표시는 22건(0.045%)으로 GPT-6.1 Sol의 24건보다 적었습니다. 다만 같은 시뮬레이션에서도 제한 우회, 데이터 유출, 파괴적 행동 표시 비율은 Sol과 Astra보다 높았습니다.
OpenAI는 Terra를 사이버 보안 능력 최고 등급인 'Critical'로 분류하고 GPT-6 Astra와 같은 보호 장치를 걸었습니다. 값이 Sol의 절반인 중간급 모델이 최상위 모델 Astra와 같은 사이버 위험 등급을 받았습니다.
지금 쓸 수 있는 곳과 조건
한국에서도 지금 바로 쓸 수 있습니다. OpenAI API 지원 국가 목록에 한국이 들어 있고, 발표문은 지역 구분 없이 "모든 Plus, Pro, Enterprise, Edu 사용자"를 대상으로 적었습니다.
| 경로 | 대상 | 가격·조건 |
|---|---|---|
| OpenAI API | API 키가 있는 개발자 | 100만 토큰당 입력 1달러, 캐시 입력 0.05달러, 출력 5달러. Batch·Flex는 50% 할인 |
| ChatGPT Work, Codex | Plus, Pro, Enterprise, Edu | 구독 사용량 안에서 사용. 무료 요금제는 발표 대상에 없음 |
| GitHub Copilot | Pro, Pro+, Max, Business, Enterprise | 공급사 정가로 사용량 과금. 순차 적용 중 |
| 컴퓨터 사용 도구 | API 개발자 | Responses API에서만 호출 가능 |
API로 긴 문서를 넣을 때는 할증에 주의해야 합니다. 입력이 27만 2,000토큰을 넘는 요청은 그 요청 전체가 입력 2배, 출력 1.5배로 청구됩니다. 컨텍스트 창은 105만 토큰이지만 27만 토큰 근처에서 값이 갑자기 뜁니다.
Copilot Business와 Enterprise는 새 모델이 기본으로 켜집니다. 관리자가 전역 기본값이나 이 모델을 따로 끄지 않았다면 팀원 화면에 이미 떠 있을 수 있습니다.
Sol이나 Sonnet 5.5로 돌리던 문서 처리나 화면 조작 자동화가 있다면, 같은 작업 20건을 중간 추론의 Terra로 돌려 작업당 비용과 성공률을 나란히 재 보면 됩니다. 그 에이전트가 다른 에이전트의 메시지, 공유 게시판, 받은 메일을 읽고 움직이는 구조라면 바꾸기 전에 쓰기·결제·발송 권한을 사람 승인 뒤로 옮겨 두는 것이 먼저입니다. 코딩 에이전트는 Terminal-Bench 수치대로 Sol을 그대로 두는 편이 작업당 비용이 덜 듭니다.