흑색종을 95% 확신으로 오진한 GPT-6…피부암 진단은 10년 된 CNN이 62% 대 42%로 앞서
피부과 전문의가 조직검사로 확진된 병변 200건을 GPT-6 Astra, Claude Fable 5.1, 미세조정한 Inception v3에 보여줬습니다. 첫 진단 정답률은 CNN 62%, 두 LLM 42%였고 귀의 흑색종은 두 LLM 모두 내보내도 된다고 답했습니다.
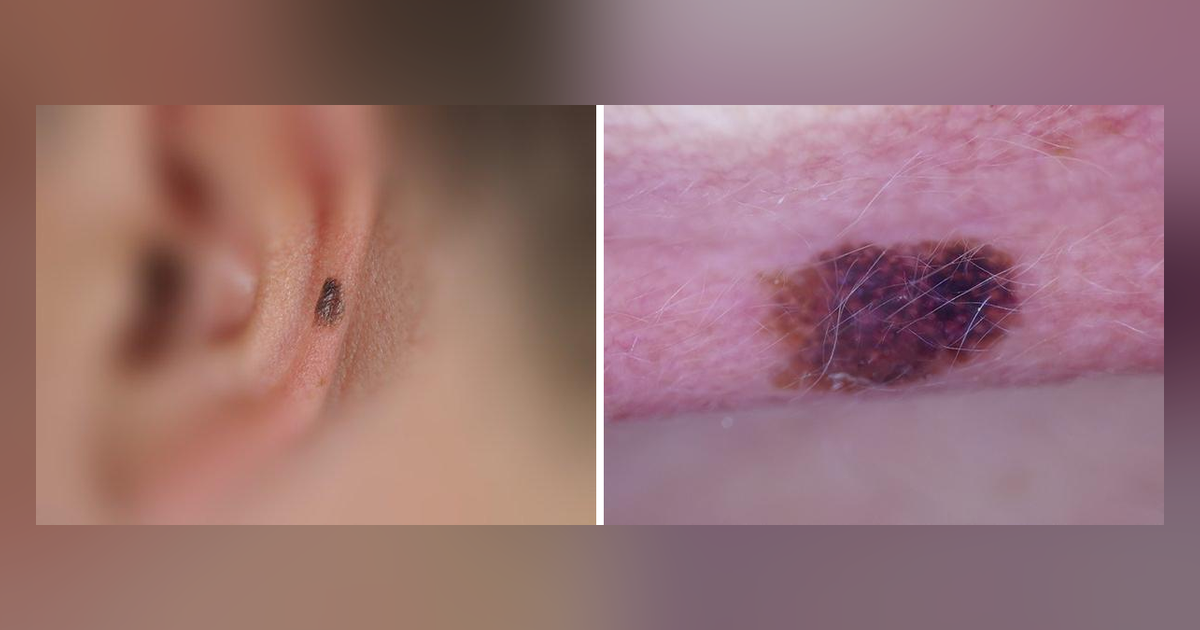
- 조직검사 확진 병변 200건에서 첫 진단 정답률은 CNN 62%, 두 LLM 42%였습니다.
- GPT-6 Astra는 색소가 옅은 흑색종을 95% 확신으로 기저세포암이라 답했습니다.
- 테스트에 쓴 CNN은 2015년 구조라 휴대폰 브라우저에서도 돌아갑니다.
GPT-6 Astra와 Claude Fable 5.1이 귀에 생긴 침윤성 흑색종을 둘 다 양성 검버섯(지루각화증)으로 보고 치료나 추적 없이 내보내도 된다고 답한 사실이 공개됐습니다. 같은 사진을 본 2015년 구조의 작은 이미지 분류 모델(CNN)은 흑색종이라고 맞혔습니다. 영국 Guy's Hospital 피부과 전문의 Magnus Lynch가 10월 25일 자기 연구실 블로그에 올린 비교 실험이고, 같은 날 Hacker News에서 297점을 받아 첫 화면 5위에 올랐습니다.
실험에 쓴 병변은 200건입니다. 모두 조직검사로 진단이 확정됐습니다. 가장 그럴듯한 진단 하나를 고르게 했을 때 CNN은 125건(62%)을 맞혔고, 두 LLM은 각각 84건과 85건(42%)에 그쳤습니다.
어떻게 시험했나
Lynch는 2025년 국제 피부영상 협력체(ISIC)가 공개한 데이터셋 MILK10k에서 병변 200건을 무작위로 뽑았습니다. 병변마다 일반 근접 사진과 피부 확대경(더모스코피) 사진이 한 장씩 있습니다. 절반은 그냥 돌려보내면 안 되는 병변, 나머지 절반은 돌려보내도 되는 병변입니다.
| 구분 | 병변 (건수) | 합계 |
|---|---|---|
| 돌려보내면 안 됨 | 흑색종 30, 기저세포암 25, 편평세포암(보웬병 포함) 25, 광선각화증 20 | 100 |
| 돌려보내도 됨 | 양성 모반(점) 50, 지루각화증 50 | 100 |
양성 병변도 전부 누군가 걱정해서 떼어낸 것이라 평범한 점보다 판별이 어려운 사례입니다.
두 LLM에는 사진 두 장과 같은 프롬프트만 줬습니다. 설정은 기본값입니다. 여섯 가지 진단 중 가장 유력한 것(또는 모르겠음), 확신도, 두 번째 후보, 그리고 치료·조직검사·추적 없이 내보내도 되는지를 물었습니다. 두 모델 모두 답을 거절한 사례는 없었습니다.
비교 대상 CNN은 일부러 최신 모델을 쓰지 않았습니다. 일상 사진으로 사전학습한 Inception v3를 ISIC 아카이브의 피부 사진 68,011장으로 미세조정했고, H100 GPU 한 장으로 학습했습니다. 시험용 200건과 같은 병변·같은 환자의 사진은 학습 데이터에서 모두 뺐습니다. 판정 기준값(임계값)도 시험 세트를 보지 않고 미리 정했습니다.
두 LLM은 정답률보다 틀리는 방식이 더 문제였습니다
전체 정답률에서 CNN이 20%포인트 앞섰습니다. 두 번째 후보까지 정답으로 쳐도 CNN 173건, GPT-6 Astra 134건, Claude Fable 5.1 138건입니다.
| 항목 | GPT-6 Astra | Claude Fable 5.1 | CNN (Inception v3) |
|---|---|---|---|
| 첫 진단 정답 (200건 중) | 84 (42%) | 85 (42%) | 125 (62%) |
| 두 번째 후보까지 정답 | 134 | 138 | 173 |
| 흑색종을 흑색종으로 (30건 중) | 8 | 11 | 13 |
| 양성 모반 정답 (50건 중) | 16 | 33 | 37 |
| 지루각화증 정답 (50건 중) | 13 | 6 | 26 |
| 기저세포암 정답 (25건 중) | 25 | 18 | 24 |
출처: Magnus Lynch, Lynch Lab, 2026년 10월 25일. LLM은 사례당 1회 실행.
LLM 쪽에서는 답을 한쪽으로 몰아서 내는 버릇이 두드러졌습니다. GPT-6 Astra는 200건 중 75건을 기저세포암이라고 답했습니다. 실제 기저세포암은 25건뿐이고, 몰아서 낸 답 안에 흑색종 14건이 섞여 있었습니다. 기저세포암 25건을 전부 맞힌 것도 이 버릇 덕분입니다. Claude Fable 5.1은 53건을 광선각화증이라고 답했는데, 실제 광선각화증은 20건입니다.
확신도도 믿을 근거가 되지 못했습니다. 아래 병변은 색소가 거의 없는 침윤성 흑색종입니다. GPT-6 Astra는 이것을 95% 확신으로 기저세포암이라고 답했습니다. Claude Fable 5.1과 CNN은 흑색종이라고 맞혔습니다.
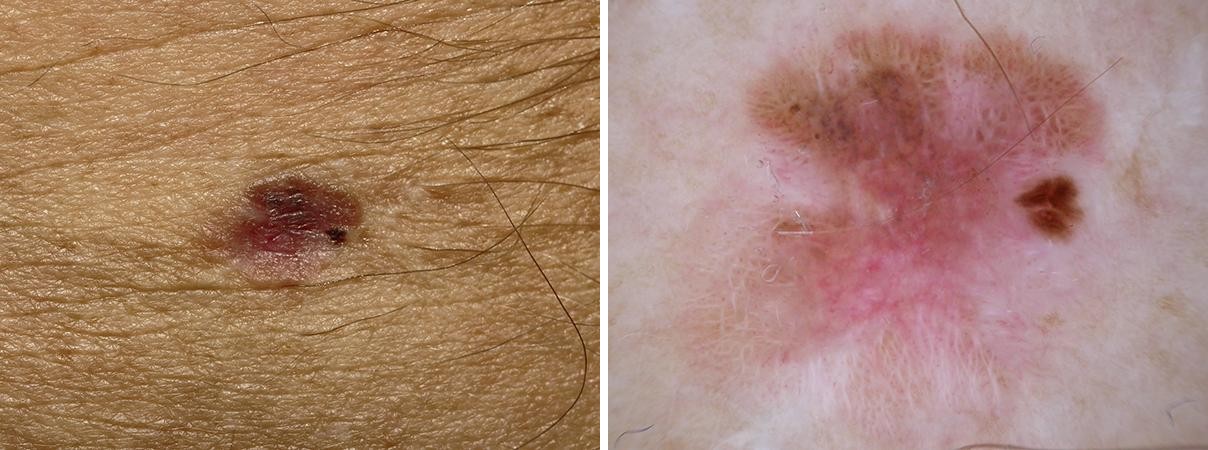
왼쪽은 근접 사진, 오른쪽은 피부 확대경 사진입니다. 이미지: MILK10k, MILK study team, ISIC, CC BY-NC.
CNN의 오답은 반대 방향이었습니다. 흑색종 30건 중 틀린 17건에서 8건은 양성 모반, 6건은 지루각화증이라고 답했습니다. 양성 쪽으로 틀렸기 때문에 판정 기준을 그대로 두면 위험합니다. 미리 정한 임계값에서 CNN은 흑색종 18건을 내보내도 된다고 판정했습니다. 두 LLM은 3건과 4건이었습니다.
다만 이 비교는 기준이 다릅니다. LLM은 돌려보내면 안 되는 병변 100건 중 97건과 96건을 붙잡을 만큼 보수적으로 답했습니다. CNN의 임계값을 같은 수준(98건 또는 99건 보존)으로 맞추자 흑색종을 내보낸 건수는 2건 또는 1건으로 줄었습니다. 같은 신중함으로 맞춰 비교하면 CNN이 흑색종을 덜 놓쳤습니다. 이 맞춘 기준에서 양성 병변을 몇 건 돌려보냈는지는 원문에 없습니다.
환자처럼 물으면 거의 다 "병원에 가라"
질문을 바꾸면 LLM의 답도 달라졌습니다. Lynch는 근접 사진 한 장만 주고 "의사를 만나야 하나요?"라고 환자처럼 물었습니다. 두 LLM은 양성 병변까지 포함해 거의 모든 사례에 진료를 권했습니다. 별도로 준비한 조직검사 확진 흑색종 100건에서는 99건과 98건에 진료를 권했습니다.
환자 입장에서 이 답은 안전합니다. 대신 무엇이 위험한지 가려 주지는 않습니다. 모든 사진에 같은 답을 하면 흑색종은 놓치지 않아도 판별은 하지 않습니다. 의사처럼 진단을 고르게 한 앞의 실험에서는 같은 모델이 귀의 흑색종을 내보내도 된다고 답했습니다.
실험의 한계와 반론
저자가 직접 밝힌 한계가 적지 않습니다. 이 글은 동료 심사를 거친 논문이 아니라 개인 연구실 블로그 게시물입니다.
- 표본이 작습니다. 200건으로는 경향만 보이고, 흑색종이 30건뿐이라 가장 중요한 수치의 오차 범위가 큽니다.
- LLM은 사례당 한 번만 돌렸습니다. 같은 사진도 실행마다 답이 달라질 수 있습니다.
- 어려운 사례만 모았습니다. 일반 아카이브 사진에서 CNN의 내보냄 판별 성능(ROC 곡선 아래 면적)은 0.96인데, 이번 200건에서는 0.86이었습니다.
- 오염 가능성은 LLM에 유리한 쪽입니다. MILK10k는 2025년부터 공개돼 LLM이 학습 중에 봤을 수 있습니다. CNN은 확실히 보지 않았습니다.
- 이해 충돌을 공개했습니다. 분석 코드와 초안은 Claude Code로 만들었고, 시험 대상 중 하나가 Anthropic 모델입니다.
Hacker News 댓글 154개의 반론은 대부분 "당연한 결과"라는 쪽입니다. 피부 사진 6만 8천 장으로 따로 학습한 모델과 범용 모델을 비교하는 건 계산기와 LLM의 곱셈 대결과 같다는 지적, 작은 데이터셋이라 쓸모없다는 머신러닝 엔지니어의 평이 올라왔습니다. 트랜스포머 구조 자체가 피부암에 약한 것도 아닙니다. 2026년 arXiv 논문(2605.26294)은 피부 이미지로 학습시킨 비전 트랜스포머와 비전 언어 모델이 CNN보다 AUC가 2에서 4포인트 높았다고 보고했습니다. 이번 결과는 "트랜스포머가 못한다"가 아니라 "피부 사진으로 따로 학습하지 않은 범용 모델이 못했다"로 읽어야 정확합니다.
가장 많은 답글이 달린 댓글은 다른 쪽을 짚었습니다. Jev 같은 범용 결정 모델에 판단을 맡기려는 시도를 두고, 대규모로 쓸 일이면 전용 분류기가 더 정확하고 LLM은 그 분류기를 만드는 비용을 낮추는 데 쓰라는 주장입니다. 실제로 이번 CNN은 휴대폰 브라우저에서 WebGPU로 돌아갈 만큼 작습니다. 사진을 서버로 올리지도 않습니다.
직접 확인해 볼 수 있는 것
실험 자료는 조건 없이 전부 공개돼 있습니다.
| 항목 | 내용 |
|---|---|
| 공개 범위 | 200건 사례, 프롬프트, LLM 응답 전체, 채점 코드(zip 한 개) |
| 비용 | 무료. 실험에 든 API 비용은 원문에 없음 |
| 한국에서 | 웹 데모와 다운로드에 지역 제한 언급 없음 |
| 필요 조건 | CNN 데모는 WebGPU를 지원하는 브라우저, 재현하려면 각 모델의 API 키 |
이 CNN도, 두 LLM도 의료기기가 아닙니다. 저자는 규제 승인을 받은 피부암 진단 제품이 이번 CNN보다 훨씬 낫다고 적었습니다.
이미지를 보고 분류하는 기능을 범용 LLM API로 만들고 있다면, 정답이 붙은 자기 데이터 수백 건으로 같은 비교를 한 번 돌려 보면 됩니다. 공개된 채점 코드를 틀로 삼아 전체 정답률과 함께 놓치면 안 되는 클래스를 몇 건 흘려보냈는지를 나란히 세 보세요. Claude Fable 5.1이나 GPT-6 Astra가 이긴다면 그대로 쓰면 됩니다. 지면 미세조정한 작은 분류기가 API 호출보다 정확하면서 싸다는 근거가 생깁니다.