Opus 5.5와 0.7점 차 Kimi K3.1 Pro, API 값은 절반에 가중치도 공개
Moonshot AI가 10월 23일 Kimi K3.1 Pro를 공개했습니다. Terminal-Bench 4.0 65.7%로 Opus 5.5(66.4%)에 근접했고, API는 100만 토큰당 입력 2달러·출력 10달러로 K3보다 33% 내렸습니다. 가중치는 11월 4일까지 공개합니다.
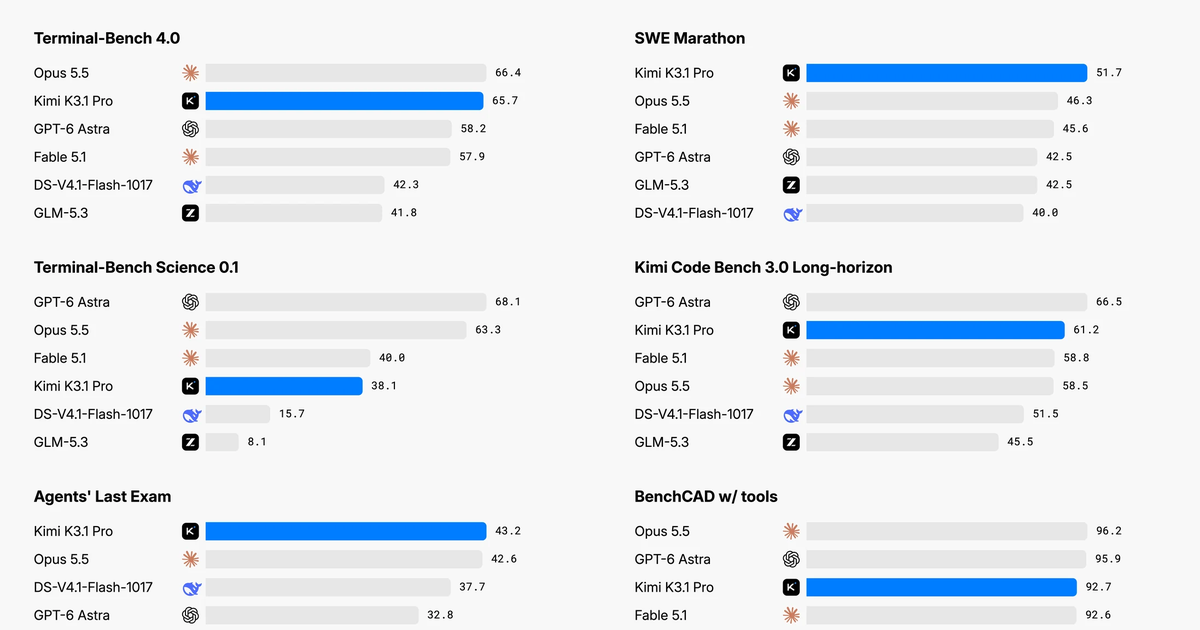
- Kimi K3.1 Pro는 코딩 시험에서 Opus 5.5와 0.7점 차입니다.
- API 출력 100만 토큰 10달러로 Opus 5.5의 절반, K3보다 33% 쌉니다.
- 가중치는 11월 4일까지 풀고, 해킹 능력은 일부러 낮췄습니다.
중국 Moonshot AI의 새 모델 Kimi K3.1 Pro가 Anthropic 최상위 모델과 코딩 시험에서 거의 같은 점수를 냈습니다. 에이전트 코딩 벤치마크 Terminal-Bench 4.0에서 K3.1 Pro는 65.7%, Claude Opus 5.5는 66.4%입니다. API 값은 Opus 5.5의 절반입니다. 전체 가중치도 11월 4일까지 공개한다고 Moonshot이 10월 23일 공식 블로그에서 밝혔습니다.
같은 날 Hacker News에서 이 발표는 510점을 받아 1위에 올랐습니다. Kimi 앱과 웹, 데스크톱 앱 Kimi Work, 코딩 도구 Kimi Code, API에서 당일부터 쓸 수 있습니다. 속도를 두세 배 높인 K3.1 Pro Highspeed도 함께 나왔습니다.
K3에서 무엇이 나아졌나
K3.1 Pro는 새로 학습한 모델이 아닙니다. 7월에 나온 Kimi K3(총 2.8조 파라미터)를 바탕으로, 학습을 마친 뒤 다듬는 단계(사후 학습)에 연산을 크게 더 쏟은 모델입니다. 컨텍스트는 K3와 같은 100만 토큰입니다.
Moonshot이 K3와 나란히 공개한 수치는 이렇습니다.
| 항목 | Kimi K3 | Kimi K3.1 Pro |
|---|---|---|
| Kimi Code Bench 3.0 장기 과제 (자체 시험) | 55.95% | 61.2% |
| 어려운 사실 질문 환각률 (낮을수록 좋음) | 23.4% | 8.3% |
| 재무 리서치 (자체 시험) | 58.8 | 70.4 |
| Artificial Analysis 지능 지수 | 44 | 55 (전체 4위) |
| 출력 속도 (Artificial Analysis 측정) | 초당 37.9토큰 | 초당 77.1토큰 |
가장 크게 달라진 건 틀린 사실을 지어내는 비율입니다. 모델이 일부러 헷갈리게 만든 질문을 모은 자체 시험에서, 답변 속 주장 하나하나를 검사했을 때 틀린 비율이 23.4%에서 8.3%로 내려갔습니다. 같은 시험에서 Opus 5.5는 15.0%, GPT-6 Astra는 5.5%입니다. Moonshot은 이 수치가 일상 사용의 오류율이 아니라 스트레스 시험 결과라고 따로 적었습니다.
외부 평가도 같은 방향입니다. 여러 벤치마크를 묶어 점수를 매기는 Artificial Analysis는 K3.1 Pro에 55점을 줘 215개 모델 중 4위에 올렸습니다. 같은 기관이 매긴 K3 점수는 44점입니다.
Opus 5.5·GPT-6 Astra와 견주면
Moonshot 발표표에서 K3.1 Pro는 긴 코딩 작업에서 미국 최상위 모델과 비슷하거나 앞서고, 과학 계산 같은 특수 영역에서는 뒤처집니다.
| 벤치마크 | K3.1 Pro | Opus 5.5 | GPT-6 Astra | Fable 5.1 |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 65.7 | 66.4 | 58.2 | 57.9 |
| SWE Marathon | 51.7 | 46.3 | 42.5 | 45.6 |
| OSWorld V2.1 (컴퓨터 조작) | 79.6 | 81.8 | 75.8 | 80.7 |
| Terminal-Bench Science 0.1 | 38.1 | 63.3 | 68.1 | 40.0 |
이 표는 Moonshot이 직접 고르고 측정한 것입니다. K3.1 Pro는 Claude Code를 실행 도구로 써서 평가했습니다. 다른 모델 점수는 각 회사 발표나 공식 순위표에서 가져왔습니다. 표 아래 주석에는 Claude 모델이 다른 모델로 넘어가 답했을 수 있다는 단서와, GPT 모델에 사이버 보안 차단이 걸렸을 수 있다는 단서가 붙어 있습니다.
HN 댓글에서는 "Kimi는 벤치마크 점수만큼 체감 성능이 안 나온다"는 반응도 나왔습니다. 자기 작업으로 직접 재보기 전에는 이 표를 그대로 믿을 이유가 없습니다.
값은 Opus 5.5의 절반, 대신 토큰을 많이 씁니다
K3.1 Pro API는 100만 토큰당 입력 2달러, 출력 10달러입니다. 7월 K3는 입력 3달러, 출력 15달러였으니 성능을 올리면서 값은 33% 내렸습니다. Opus 5.5가 입력 4달러, 출력 20달러이니 K3.1 Pro는 정확히 절반입니다.
| 모델 (100만 토큰당) | 입력 | 출력 | 캐시 입력 |
|---|---|---|---|
| kimi-k3.1-pro | 2달러 | 10달러 | 0.20달러 |
| kimi-k3.1-pro-highspeed | 4달러 | 20달러 | 0.20달러 |
| kimi-k3 (전작) | 3달러 | 15달러 | 0.30달러 |
| Claude Opus 5.5 | 4달러 | 20달러 | 0.20달러 |
속도를 높인 Highspeed는 값도 두 배라 Opus 5.5와 같아집니다. 응답 대기가 중요한 대화형 서비스가 아니라면 기본 모델이 맞습니다.
단가가 절반이라고 작업 하나에 드는 돈도 절반이 되는 건 아닙니다. Artificial Analysis가 지능 지수를 매기는 동안 K3.1 Pro는 출력 토큰 1억 5천만 개를 썼습니다. 비교 모델 중앙값 8,700만 개의 1.7배입니다. 이 모델은 생각하는 과정(사고 모드)을 끌 수 없고 기본값이 가장 오래 생각하는 max라서, 짧은 질문에도 출력이 길어지기 쉽습니다. reasoning_effort를 low나 high로 내리면 줄일 수 있습니다.
한국에서 쓸 수 있나
국가 제한은 공식 문서에 적혀 있지 않습니다. Moonshot은 한국어 API 안내 페이지를 따로 두었습니다. OpenRouter에도 moonshotai/kimi-k3.1-pro로 같은 값에 올라와 있습니다.
| 항목 | 내용 |
|---|---|
| 개인 | Kimi 웹·모바일 앱·Kimi Work 3.1.0 이상(Windows, Apple 실리콘 Mac)에서 바로 선택 |
| 개발자 | platform.kimi.ai에서 1달러 이상 충전해야 K3.1 Pro가 열림. 누적 충전액에 따라 분당 요청 한도가 올라감 |
| 기업 | Kimi Business는 관리자가 켜야 하며 출시 시점에는 꺼져 있음. API 고객은 데이터 미보관(ZDR) 옵션 사용 가능 |
| 코딩 도구 | Kimi Code에서 /model 명령으로 선택 |
| 제약 | 이미지 입력은 URL 대신 base64로만. 내장 웹 검색은 개편 중이라 운영 환경 비권장. temperature 등 샘플링 값은 고정 |
구독 요금제 한도에는 불만이 많습니다. HN에서 한 사용자는 월 99달러 플랜에서 세션 하나로 47분 만에 5시간 한도에 걸렸다고 적었습니다. 많이 쓸 계획이면 구독보다 API 종량제가 예측하기 쉽습니다.
Moonshot은 K2 시리즈를 10월 31일부터 신규 가입자에게 막고 12월 말에 모두 종료한다고 가격 페이지에 공지했습니다. K2.6이나 K2.7 Code를 쓰는 서비스라면 옮길 곳이 사실상 K3.1 Pro뿐입니다.
해킹 능력은 일부러 뺐다
Moonshot은 배포용 K3.1 Pro에서 사이버 공격 관련 학습 데이터를 찾아 지웠다고 밝혔습니다. 사후 학습을 늘릴수록 취약점을 찾아 공략하는 능력이 함께 오르는 것을 확인한 뒤 원인을 추적해 보니 일반 학습 자료와 강화학습 과제에 보안 관련 내용이 섞여 있었다는 설명입니다.
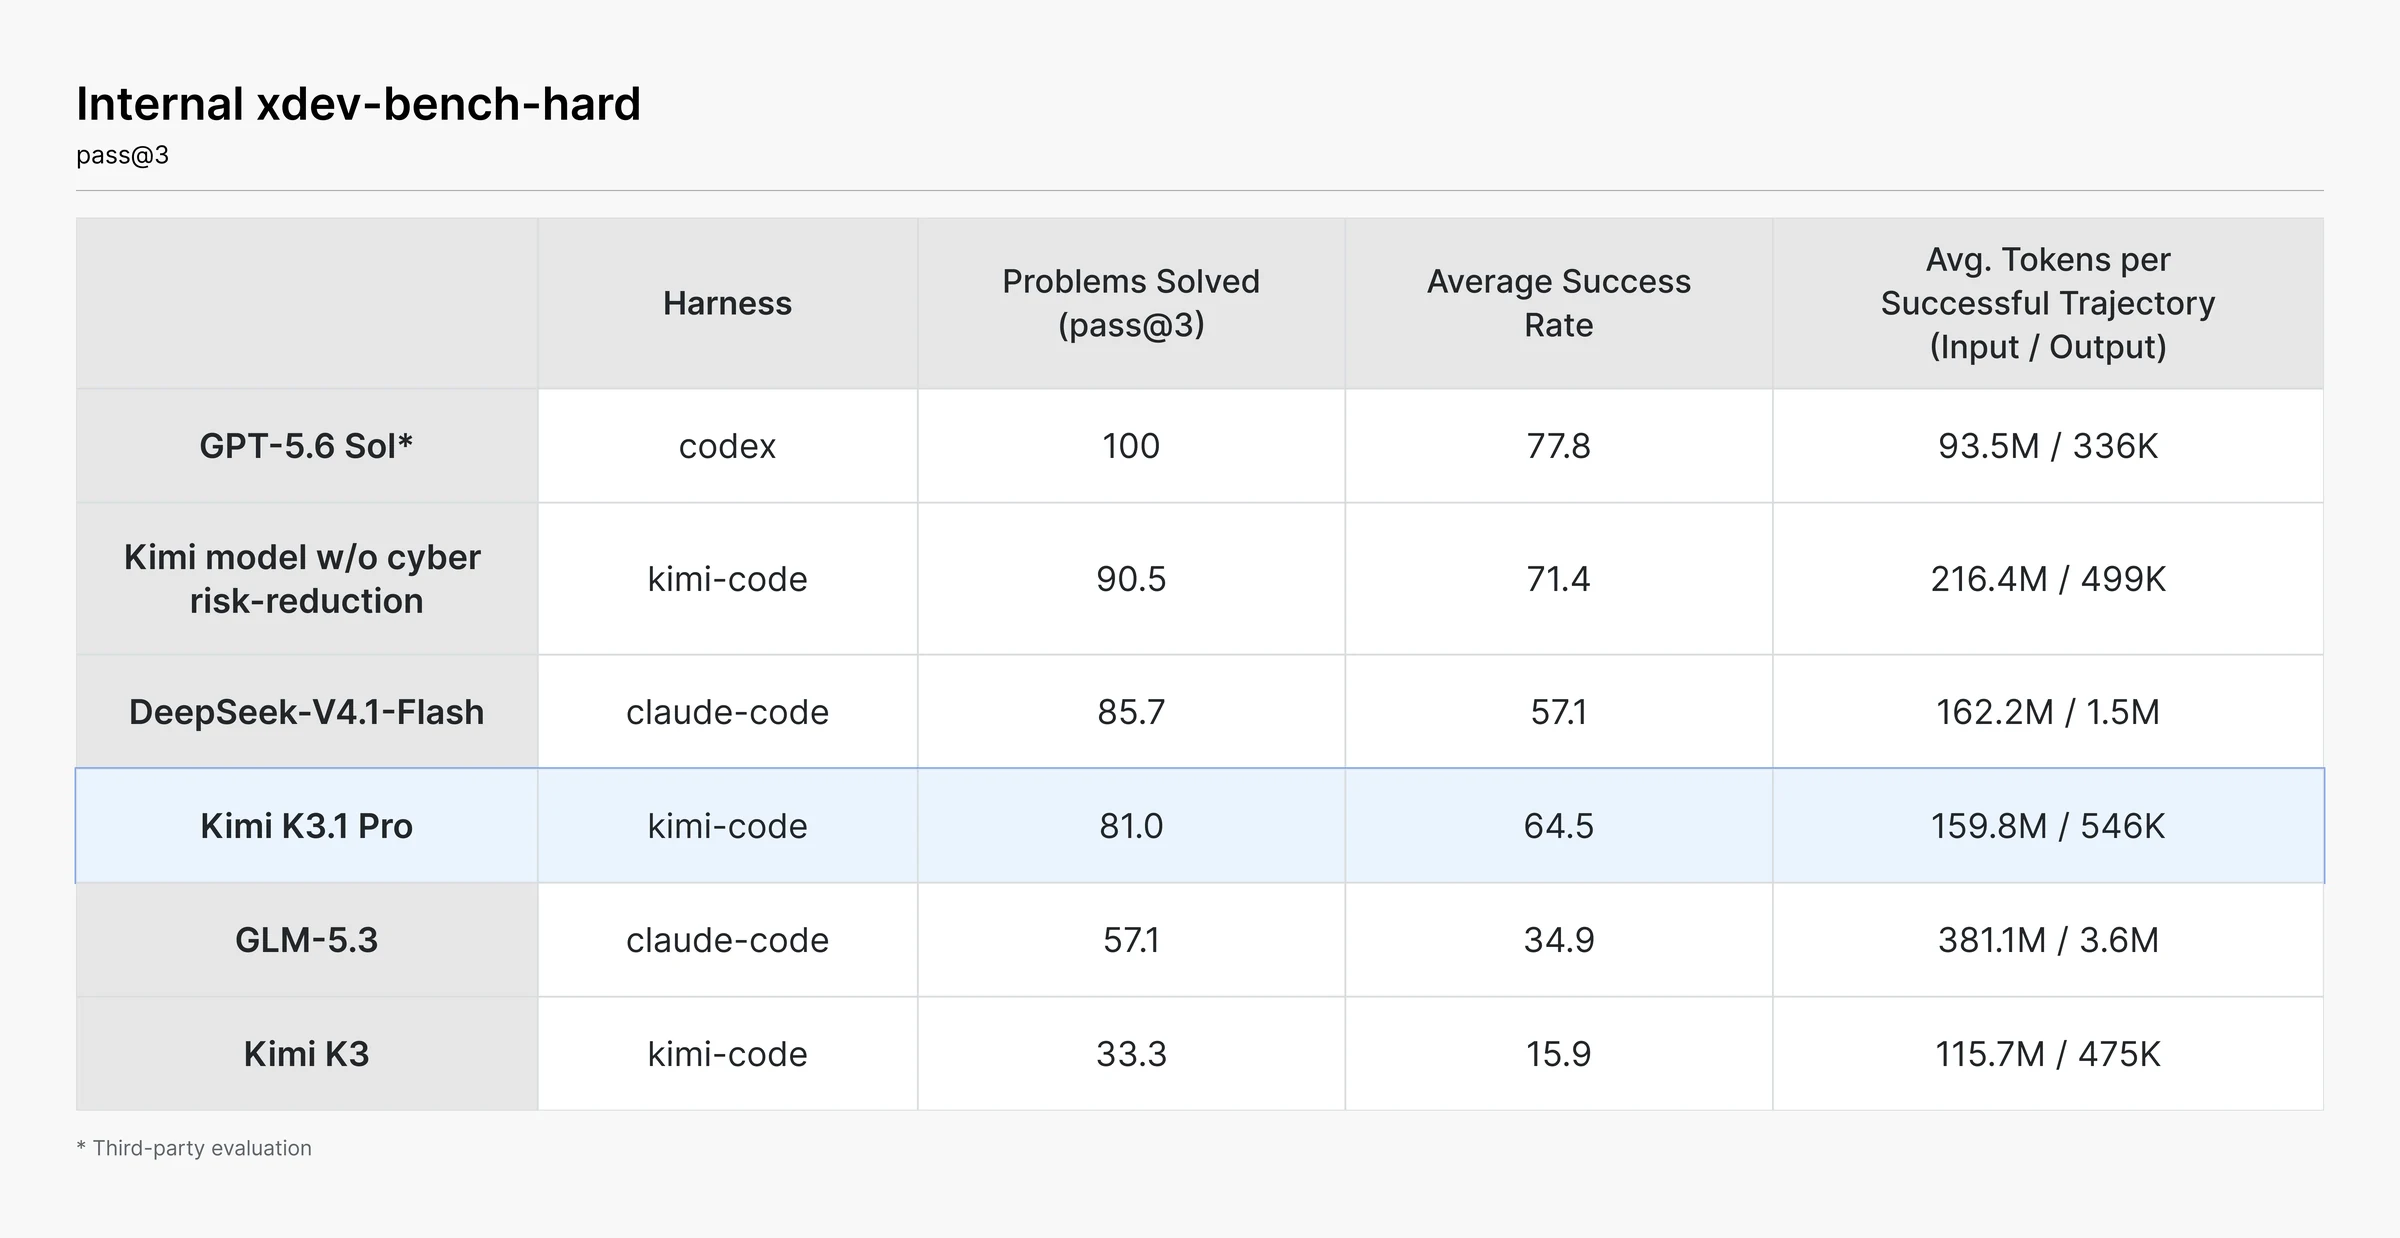
자체 시험 xdev-bench-hard는 Linux 커널, Node.js 같은 실제 소프트웨어의 공개된 취약점을 재현해 공격 코드를 짜게 합니다. 데이터를 지우지 않은 체크포인트는 90.5%를 풀었습니다. 배포판은 81.0%입니다. 그래도 전작 K3의 33.3%보다는 훨씬 높습니다.
Moonshot의 원칙은 두 줄입니다. "오픈 가중치로 사이버 능력의 절대 최전선을 넓히지 않는다." 그리고 "오픈 가중치의 사이버 능력은 점진적으로 올린다." HN에서는 "할 수 있는데 안 한다는 인정"이라는 댓글이 가장 많은 답글을 받았습니다.
11월 4일 가중치, 중국 수출 통제 초안 아래에서 처음
이번 가중치 공개 약속은 중국 정부가 대형 모델 가중치를 수출 통제 목록에 넣겠다는 초안을 낸 지 일주일 만에 나왔습니다. 중국 상무부와 과학기술부는 10월 16일 「수출 금지·제한 기술 목록」 개정 의견수렴 공고를 올렸습니다. 의견 마감은 11월 15일입니다.
초안 분석(ChinaTalk)에 따르면 파라미터 2조 개 이상, 학습 연산 10의 26제곱 FLOPs 이상, 세계 선도 수준 성능 중 하나만 넘어도 통제 대상입니다. K3가 2.8조 파라미터이고, Moonshot은 K3.1 Pro를 "3조급"이라고 부릅니다. 초안대로라면 파라미터 기준만으로 통제 대상입니다.
다만 오픈소스 공개 길은 열어 뒀습니다. 상무부 문답 자료는 AI 기술을 오픈소스로 내는 경우 자동 허가를 적용해 "기본적으로 신고 즉시 내보낼 수 있게" 하겠다고 적었습니다. 이미 공개된 기술은 아예 관리 대상에서 뺍니다. API나 앱으로 쓰는 것은 처음부터 수출이 아닙니다.
남은 변수는 "오픈소스"의 정의입니다. 초안에는 이 정의가 없습니다. K3처럼 자체 라이선스를 붙인 공개가 자동 허가 대상인지도 불분명하다고 ChinaTalk은 지적했습니다. Moonshot 발표문에는 수출 통제 이야기가 한 줄도 없습니다. K3.1 Pro 라이선스도 아직 공개 전입니다.
이미 Claude Code나 다른 코딩 에이전트를 API 키로 돌리는 팀이라면, 이번 주에 처리할 실제 이슈 서너 개를 K3.1 Pro(reasoning_effort: high)로 한 번 더 돌려 보면 됩니다. 결과물 품질과 함께 청구서의 출력 토큰 수를 Opus 5.5와 나란히 놓아야 단가 절반이 실제로 얼마의 절약인지 나옵니다. 자체 서버에 올릴 계획이라면 11월 4일 Hugging Face에 올라오는 저장소의 라이선스 파일부터 확인하세요.