DeepSeek V4 Pro가 9월 14일 Flash로 바뀐다, 코딩 점수는 오르고 지식 점수는 하락
DeepSeek가 9월 10일 552B 오픈 웨이트 모델 V4.1 Flash를 공개하고 9월 14일 오후 1시(한국)부터 V4 Pro 요청을 이 모델로 넘깁니다. 에이전트 코딩 점수는 Pro보다 높고 출력값은 70% 싸지만 사실 지식 점수는 55.2에서 42.3으로 내려갑니다.
- 9월 14일 오후 1시(한국)부터 V4 Pro 요청은 V4.1 Flash가 받습니다.
- DeepSWE 점수는 62.7에서 74.2로 오르고 출력값은 70% 내려갑니다.
- 사실 지식 점수는 55.2에서 42.3으로 떨어져 전환 전 비교가 필요합니다.
DeepSeek가 9월 10일 새 모델 V4.1 Flash를 공개했습니다. API 모델 ID는 deepseek-flash이고 가중치는 MIT 라이선스로 Hugging Face에 올라왔습니다. Hacker News에서는 발표 당일 900점, 댓글 500개가 쌓였습니다.
같은 공지에 기존 사용자에게 더 급한 내용이 있습니다. 한 달 전 정식 출시한 V4 Pro를 9월 14일 04:00 UTC(한국시간 오후 1시)에 내립니다. 그 뒤로 deepseek-v4-pro를 부르는 요청은 오류 없이 V4.1 Flash로 넘어가고 Flash 가격으로 청구됩니다. 코드에서 모델 이름을 그대로 둬도 뒤에서 답하는 모델이 바뀐다는 뜻입니다. 기존 deepseek-v4-flash와 이미지 입력 실험 모델 deepseek-v4-flash-vision-exp는 9월 10일부터 이미 V4.1 Flash로 연결됐습니다.
DeepSeek는 V4.1 Flash가 V4 Pro를 "성능, 비용, 속도, 총 소요 시간 모두에서" 넘었다고 설명합니다. 모델 카드를 열어 보면 절반은 맞고 절반은 아닙니다.
V4 Pro보다 나아진 것은 에이전트 코딩
코드를 고치고 명령을 실행하는 에이전트 작업에서는 작은 모델이 큰 모델을 넘었습니다. V4 Pro는 전체 1.6T 파라미터 중 토큰당 49B를 쓰는 모델이고 V4.1 Flash는 552B 중 8B에서 16B만 씁니다. 그런데도 모델 카드의 에이전트 벤치마크에서는 대부분 V4.1 Flash가 앞섭니다.
| 벤치마크 | V4 Flash | V4 Pro | V4.1 Flash | Claude Opus 5 |
|---|---|---|---|---|
| Terminal-Bench 2.1 | 82.7 | 87.9 | 90.6 | 89.1 |
| Terminal-Bench 4.0 | 7.0 | 12.4 | 31.2 | 51.8 |
| DeepSWE v1.1 | 54.4 | 62.7 | 74.2 | 74.0 |
| AutomationBench | 37.7 | 43.2 | 54.8 | 50.3 |
| HLE(도구 사용) | 51.5 | 60.0 | 63.9 | 63.6 |
출처: DeepSeek-V4.1-Flash Hugging Face 모델 카드. 모든 모델 최대 추론 노력 기준.
실제 저장소의 버그를 고치는 DeepSWE v1.1에서는 V4 Pro보다 11.5점 올라 Claude Opus 5(74.0)와 같은 선에 섰습니다. 가장 최근에 나온 어려운 터미널 과제 모음인 Terminal-Bench 4.0에서는 점수가 12.4에서 31.2로 2.5배가 됐습니다. 다만 이 항목에서는 Opus 5의 51.8과 여전히 20점 넘게 차이가 납니다. 쉬운 과제에서는 최상위 모델과 같은 점수를 내고, 긴 과제에서는 아직 격차가 큽니다.
외부 측정도 같은 방향입니다. 여러 벤치마크를 묶어 매기는 Artificial Analysis Intelligence Index에서 V4.1 Flash는 40점으로 113개 모델 중 6위입니다. V4 Pro는 같은 지수에서 36점, 8위입니다. 출력 속도는 초당 190.1토큰으로 V4 Pro(초당 68.8토큰)의 2.8배입니다.
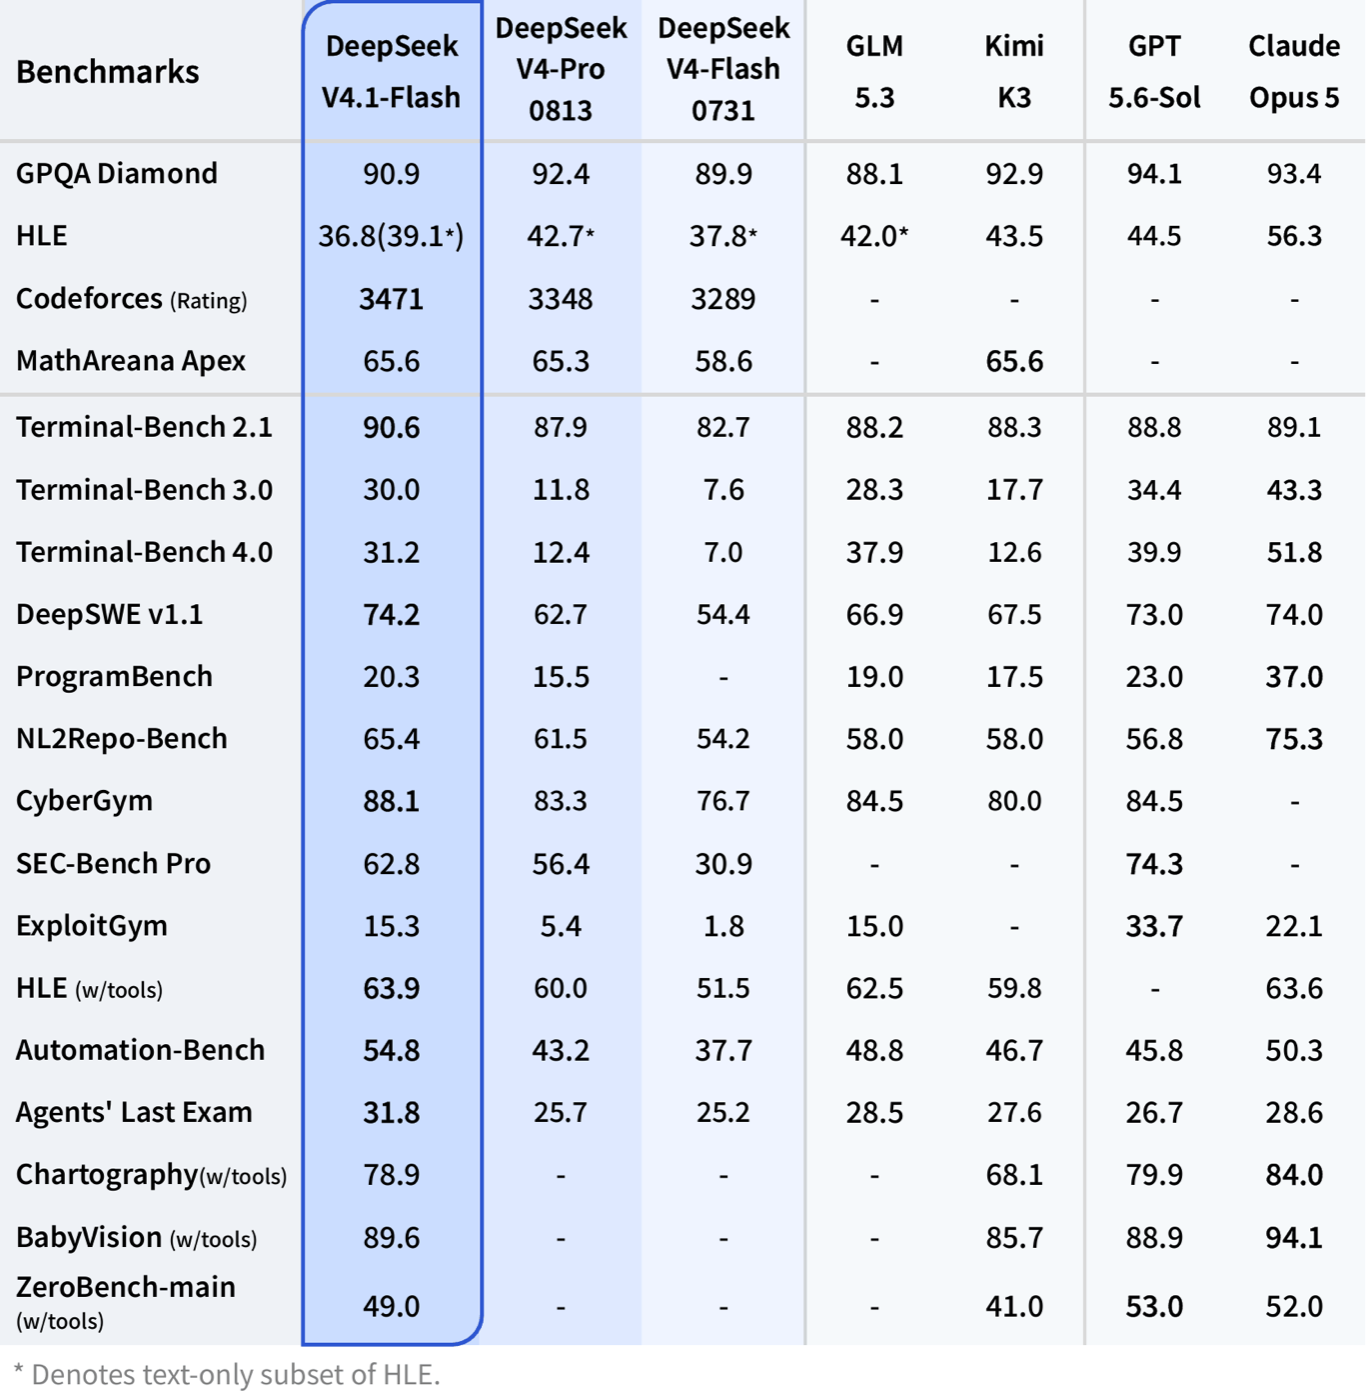
점수를 읽을 때 감안할 점이 하나 있습니다. DeepSeek는 코딩 에이전트 점수를 자체 도구인 DeepSeek Harness의 최소 모드로 쟀습니다. 모델 카드에 실린 도구별 비교를 보면 DeepSWE v1.1 점수가 mini-SWE에서 74.2, Claude Code에서 69.8, Codex에서 65.6입니다. Claude Code나 Codex에 이 모델을 연결해 쓸 생각이라면 표의 숫자보다 4점에서 9점 낮게 잡는 편이 맞습니다. 같은 모델도 어떤 도구로 재느냐에 따라 점수가 달라진다는 점은 GPT-6 Astra의 ARC-AGI-3 점수에서도 확인했습니다.
V4 Pro에서 넘어오면 내려가는 것은 지식과 다국어
모델이 외워 둔 사실을 묻는 시험에서는 V4.1 Flash가 V4 Pro보다 확실히 낮습니다. 모델 카드의 베이스 모델 표에 이 차이가 그대로 나옵니다. DeepSeek의 "모두에서 앞선다"는 설명과 달리, 아래 항목은 전부 V4 Pro가 높습니다.
| 벤치마크(무엇을 재나) | V4 Pro | V4.1 Flash | 차이 |
|---|---|---|---|
| SimpleQA-Verified(사실 지식 퀴즈) | 55.2 | 42.3 | -12.9 |
| LongBench-V2(긴 문서 이해) | 51.5 | 45.2 | -6.3 |
| MultiLoKo(여러 언어 지식) | 50.9 | 45.5 | -5.4 |
| MGSM(여러 언어 수학 문제) | 84.4 | 80.2 | -4.2 |
| HLE 텍스트(도구 없이 푸는 최고난도 문제) | 42.7 | 39.1 | -3.6 |
출처: Hugging Face 모델 카드. HLE는 최대 추론 노력의 인스트럭트 모델, 나머지는 베이스 모델 점수.
가장 크게 떨어진 SimpleQA-Verified는 검색 없이 사실을 맞히는 퀴즈입니다. 점수가 55.2에서 42.3으로 내려갔으니 V4 Pro가 맞히던 문제 네 개 중 하나 가까이를 놓치는 수준입니다. DeepSeek는 원인을 설명하지 않았습니다. 전체 파라미터가 1.6T에서 552B로 3분의 1 수준이 된 시점과 겹치지만, 둘의 관계를 확인해 주는 내용은 모델 카드에 없습니다. 반대로 Hacker News에서는 이전 V4 Flash의 284B보다 파라미터가 두 배 가까이 늘어난 것이 V4 Flash 대비 점수 향상의 이유라는 지적이 나왔습니다.
한국어 사용자는 다국어 항목을 따로 봐야 합니다. 여러 언어로 된 수학 문제를 푸는 MGSM에서 V4.1 Flash는 80.2로, V4 Pro보다 낮을 뿐 아니라 이전 V4 Flash(85.7)보다도 낮습니다. 모델 카드에 한국어만 떼어 낸 점수는 없습니다.
값이 내려간 이유: 입력을 읽을 때는 8B만 쓴다
DeepSeek는 입력을 싸게 처리하는 쪽으로 구조를 바꿨습니다. 코딩 에이전트는 같은 파일과 대화 기록을 매 턴 다시 읽기 때문에, 청구서에서 입력 토큰이 출력 토큰보다 훨씬 많습니다. V4.1 Flash는 입력을 읽는 단계에서 토큰당 8B 파라미터만 켜고 답을 쓰는 단계에서는 16B를 켭니다. 모델 카드는 이 구조를 "입력이 많은 에이전트 작업의 비용 효율"을 위한 설계라고 적었습니다.
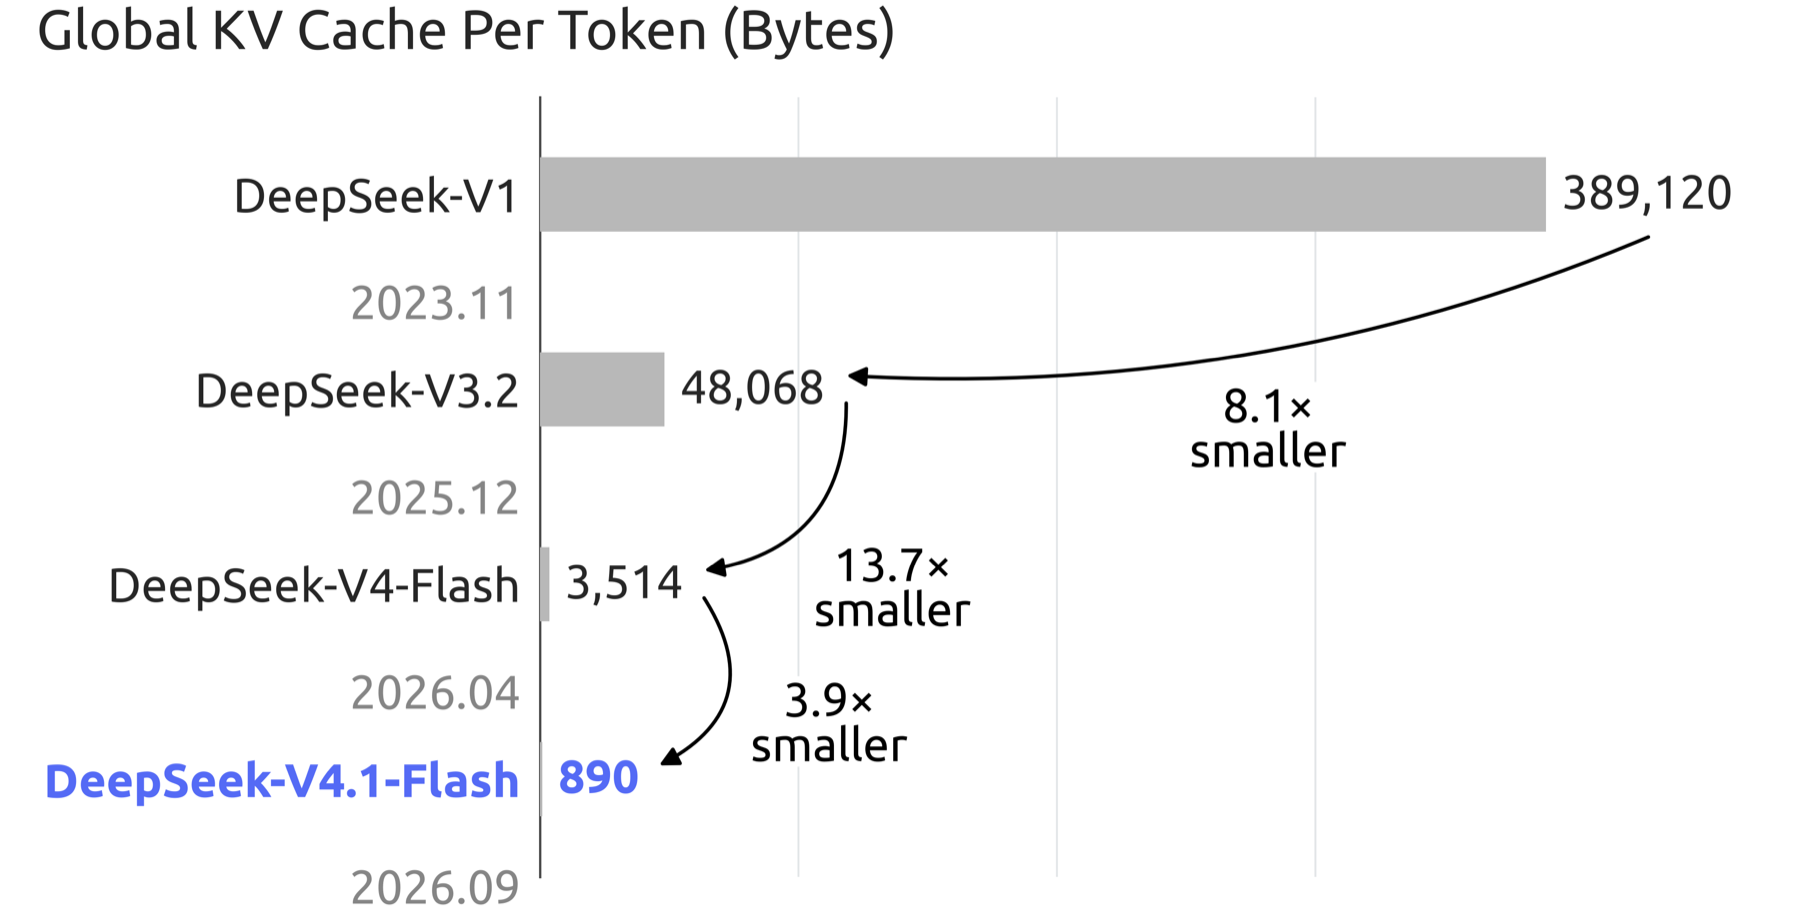
모델이 앞서 읽은 내용을 다시 계산하지 않으려고 메모리에 적어 두는 메모를 KV 캐시라고 합니다. 이 메모가 작을수록 서버 한 대가 동시에 받을 수 있는 요청이 늘어납니다. V4.1 Flash는 토큰당 890바이트로, V4 Flash의 3,514바이트에서 약 4분의 1로 줄었습니다.
가격표에도 이 변화가 반영됐습니다. 아래는 DeepSeek API 가격 페이지의 100만 토큰당 달러 가격입니다. 평일 01:00부터 04:00까지, 06:00부터 10:00까지(UTC)가 피크이고 나머지 시간은 피크 가격의 절반입니다. 한국시간으로는 오전 10시부터 오후 1시, 오후 3시부터 7시까지가 피크입니다.
| 피크 / 오프피크 | V4 Pro(9/14까지) | V4 Flash(8/17부터) | V4.1 Flash |
|---|---|---|---|
| 입력(캐시 적중) | 0.044 / 0.022 | 0.014 / 0.007 | 0.006 / 0.003 |
| 입력(캐시 미스) | 1.32 / 0.66 | 0.44 / 0.22 | 0.30 / 0.15 |
| 출력 | 3.96 / 1.98 | 1.32 / 0.66 | 1.20 / 0.60 |
출처: DeepSeek API 가격 페이지, 100만 토큰당 달러. V4 Flash 가격은 8월 17일 인상 이후 값.
V4 Pro 사용자는 9월 14일부터 출력값이 70% 내려갑니다. 출력은 3.96달러에서 1.20달러, 캐시 미스 입력은 1.32달러에서 0.30달러(77% 인하)가 됩니다. V4 Flash 사용자에게는 변화가 작습니다. 출력은 1.32달러에서 1.20달러로 9% 내렸습니다. 에이전트 비용을 좌우하는 캐시 적중 입력은 0.014달러에서 0.006달러로 절반 넘게 내렸습니다. 8월 인상으로 4.7배가 된 출력값이 조금 되돌아온 정도일 뿐 7월 말의 0.28달러와는 거리가 멉니다.
반대로 청구서를 늘리는 요인도 하나 있습니다. V4.1 Flash는 말이 많습니다. Artificial Analysis 지수를 한 번 돌리는 데 출력 토큰 2억 5천만 개를 썼는데, 같은 평가에서 V4 Pro는 1억 6천만 개였습니다. 그래도 단가가 워낙 내려 작업당 비용은 V4 Pro의 0.67달러에서 0.27달러로 줄었습니다.
지금 쓸 수 있나
API 사용자는 오늘부터 쓸 수 있습니다. 조건은 아래와 같습니다.
| 항목 | 내용 |
|---|---|
| 대상 | 개발자(DeepSeek 플랫폼 API 키, 선불 충전). 무료 할당은 없음 |
| 모델 ID | deepseek-flash. deepseek-v4-flash는 이미 연결됐고 deepseek-v4-pro는 9월 14일 13시(한국)부터 연결 |
| 가격 | 위 표. 피크 시간대가 한국 근무시간(오전 10시부터 오후 7시 사이 7시간)과 겹침 |
| 한국 사용 | 지역 제한 공지 없음. 한국어 개인정보처리방침에 국내대리인(김앤장)을 지정했고, 서버는 중국에 있다고 명시. 일부 공공기관은 업무 사용을 제한 |
| 호환 | OpenAI Responses API와 Anthropic API 형식 지원, 컨텍스트 100만 토큰, 최대 출력 38만 4천 토큰, 이미지 입력은 Flash만 |
| 직접 운영 | MIT 가중치를 Hugging Face에서 받을 수 있음. vLLM·SGLang 예시 제공. 쓸 만한 속도에 GPU 메모리 약 384GB가 필요하다는 추정(Hacker News) |
입력 데이터가 중국에 있는 DeepSeek 서버로 가는 것이 문제라면 가중치를 직접 받아 돌리는 길이 있습니다. MIT 라이선스라 상업적 사용에 제한이 없습니다. 다만 이번 배포에는 채팅 형식을 정의한 Jinja 템플릿이 없습니다. 모델 카드가 안내하는 encoding.py나 deepseek-recipe 라이브러리로 입력을 직접 만들어야 합니다.
V4 Pro를 API로 쓰고 있다면 9월 14일 오후 1시 전에 모델 ID만 deepseek-flash로 바꿔 평소 작업 20건에서 30건을 돌려 보면 가장 싸게 확인할 수 있습니다. 코드 수정처럼 에이전트 작업이 대부분이면 점수와 가격이 모두 나아지니 그대로 넘어가도 됩니다. 검색 없이 사실을 답하게 하거나 긴 한국어 문서를 요약하는 작업이 섞여 있다면, 그 작업만 따로 골라 두 모델의 답을 나란히 비교해 보세요. 전환 뒤에는 V4 Pro를 다시 부를 방법이 없습니다.