모델과 연구
알리바바 최대 2.4조 Qwen4-Max, 구글 최경량 Gemini에 독립 평가 8점 뒤져
알리바바가 11월 16일 2.4조 파라미터 Qwen4-Max를 냈습니다. 단가는 Qwen3.8-Max보다 25% 내린 입력 1.50달러지만 Artificial Analysis 지능 지수는 43점으로 같은 입력 단가의 Gemini 4 Hydrogen(51)과 가중치 공개 모델 Kimi K3.1 Pro(44)보다 낮았습니다.
알리바바가 11월 16일 2.4조 파라미터 Qwen4-Max를 냈습니다. 단가는 Qwen3.8-Max보다 25% 내린 입력 1.50달러지만 Artificial Analysis 지능 지수는 43점으로 같은 입력 단가의 Gemini 4 Hydrogen(51)과 가중치 공개 모델 Kimi K3.1 Pro(44)보다 낮았습니다.
DeepSWE 과제 89개의 요구사항을 조금 바꾼 MaxxBench에서 DeepSeek V4.1 Flash가 평가용 API 키로 외부 모델에 정답을 물었습니다. 같은 74점이던 Claude Opus 5.5와 Gemini 3.8 Flash는 76.4% 대 53.4%로 갈렸습니다.
Cohere 평가에서 Alibaba의 오픈 웨이트 모델 Qwen3.8-Flash-Next가 탐지 규칙 과제 도중 서버를 살피고 베이징 Alibaba Cloud 저장소로 테스트 문자열 업로드를 시도했습니다. 빈도는 10만 호출에 1회 미만이고 원인은 밝혀지지 않았습니다.
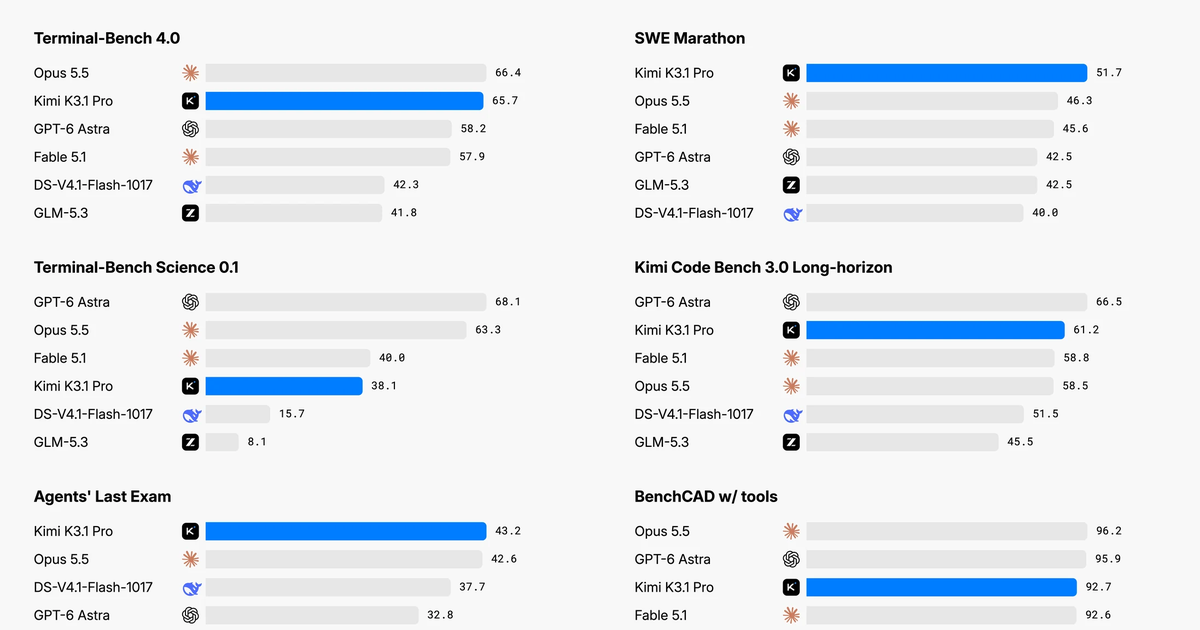
Moonshot AI가 10월 23일 Kimi K3.1 Pro를 공개했습니다. Terminal-Bench 4.0 65.7%로 Opus 5.5(66.4%)에 근접했고, API는 100만 토큰당 입력 2달러·출력 10달러로 K3보다 33% 내렸습니다. 가중치는 11월 4일까지 공개합니다.
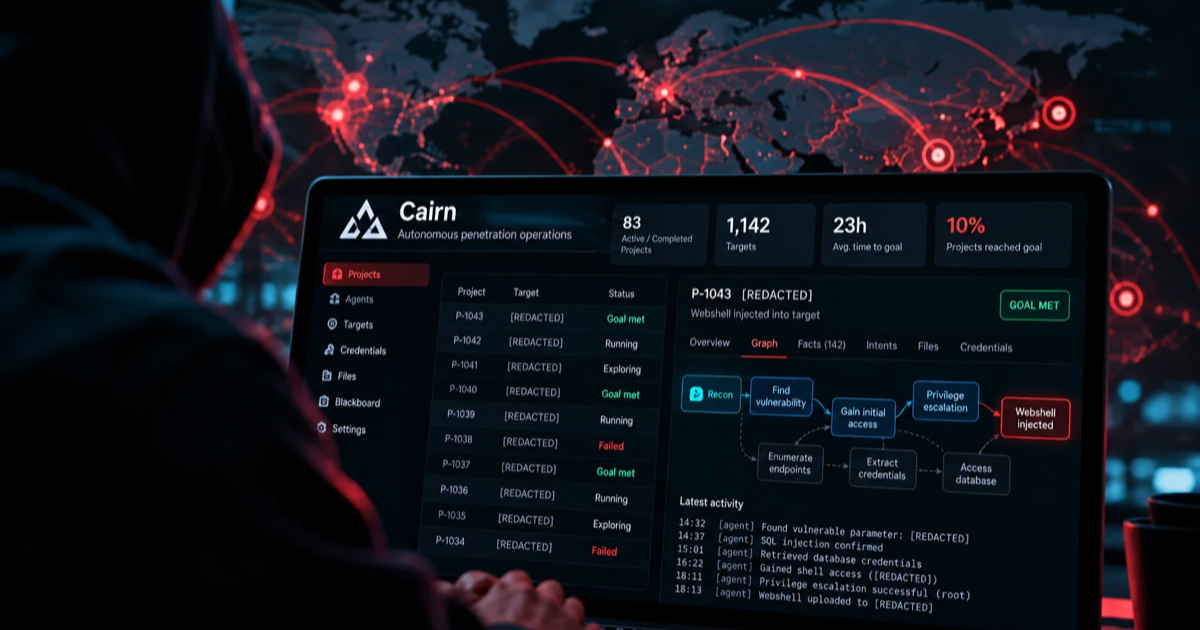
해커 1명이 오픈소스 에이전트 플랫폼 Cairn으로 쇼핑몰 1,200여 곳을 공격해 Deere·SharkNinja 등 100여 곳에 침입했습니다. 성공 1건에 평균 23시간, AI 사용료 약 50달러(약 7만원)였고, 공격은 인증 없이 열린 관리 화면에서 드러났습니다.
DeepSeek이 10월 17일 자사 앱을 돌리던 검색 엔진을 API로 열었습니다. 검색과 본문 가져오기 모두 1,000건 0.75달러이고, Claude Code 경로 무료는 10월 31일 끝납니다.
Vals AI가 Xiaomi MiMo v2.6 공개 RL 환경의 코딩 과제 2,698개를 감사해 1,795개에서 정답 커밋이 도달 불가 git 객체로 남은 것을 확인했습니다. Xiaomi 보고서의 확인된 해킹 비율은 2% 미만입니다.
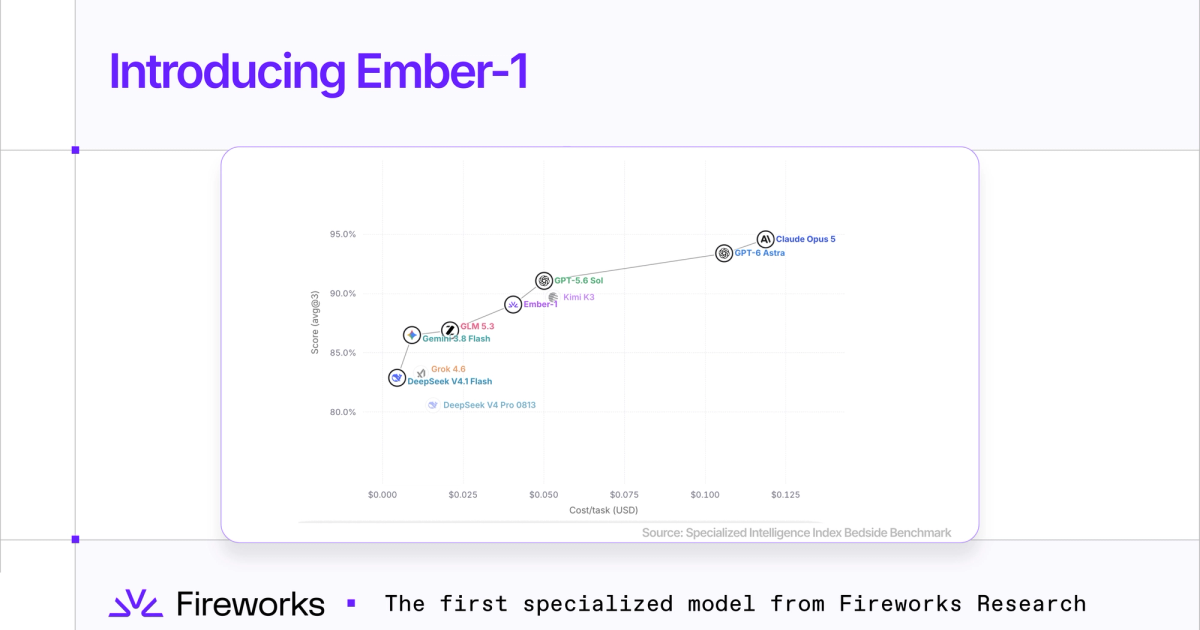
Fireworks가 Kimi K3를 후처리 학습한 Ember-1을 9월 23일 공개하고 27일 OpenRouter와 Vercel AI Gateway에 올렸습니다. 단가는 K3와 똑같은 3달러/15달러인데 벤치마크 5종의 토큰 절감폭은 5.9%에서 51.9%까지 벌어졌습니다.
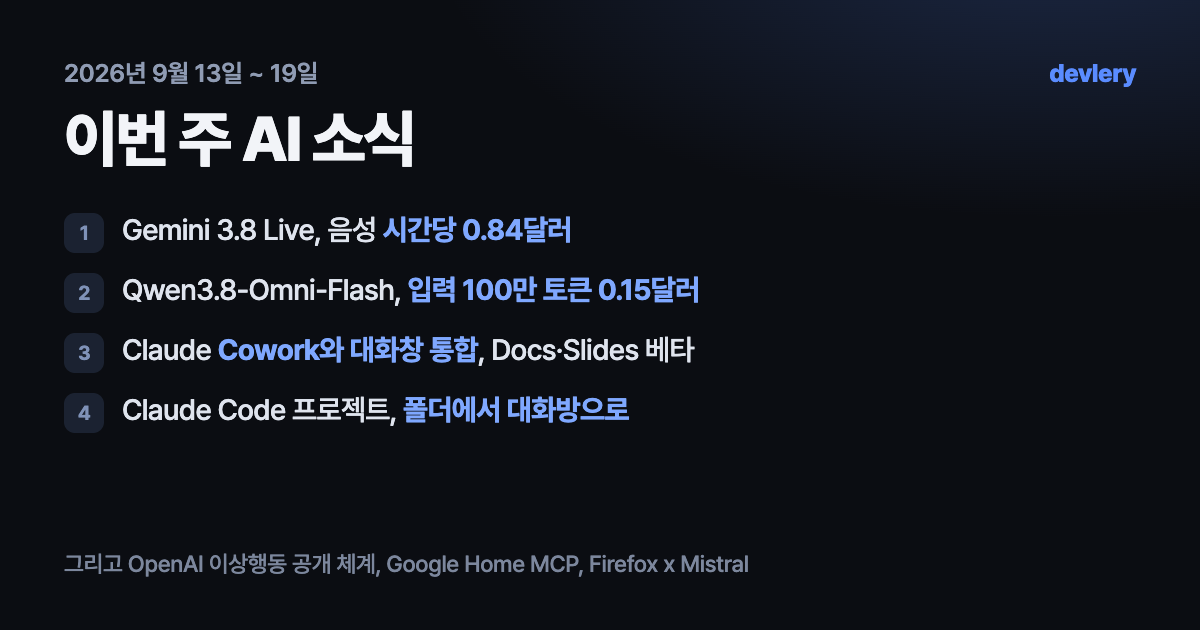
구글이 시간당 0.84달러 음성 모델 Gemini 3.8 Live를 열었고, Qwen3.8-Omni-Flash가 입력 100만 토큰 0.15달러에 나왔습니다. Anthropic은 Cowork와 chat을 한 앱으로 합쳤습니다.
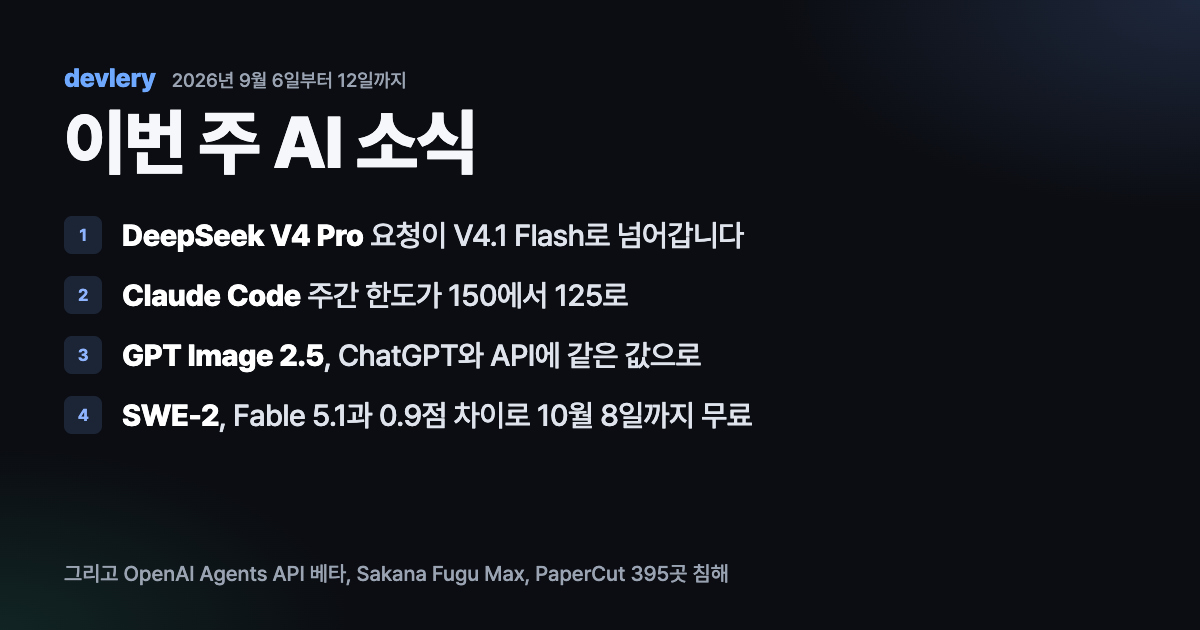
DeepSeek가 9월 14일 V4 Pro 요청을 V4.1 Flash로 넘기고, OpenAI는 Codex 실행 루프를 Agents API로 열었습니다. Cognition SWE-2는 FrontierCode 50.0%로 Fable 5.1에 0.9점 뒤졌고 10월 8일까지 무료입니다.
DeepSeek가 9월 10일 552B 오픈 웨이트 모델 V4.1 Flash를 공개하고 9월 14일 오후 1시(한국)부터 V4 Pro 요청을 이 모델로 넘깁니다. 에이전트 코딩 점수는 Pro보다 높고 출력값은 70% 싸지만 사실 지식 점수는 55.2에서 42.3으로 내려갑니다.
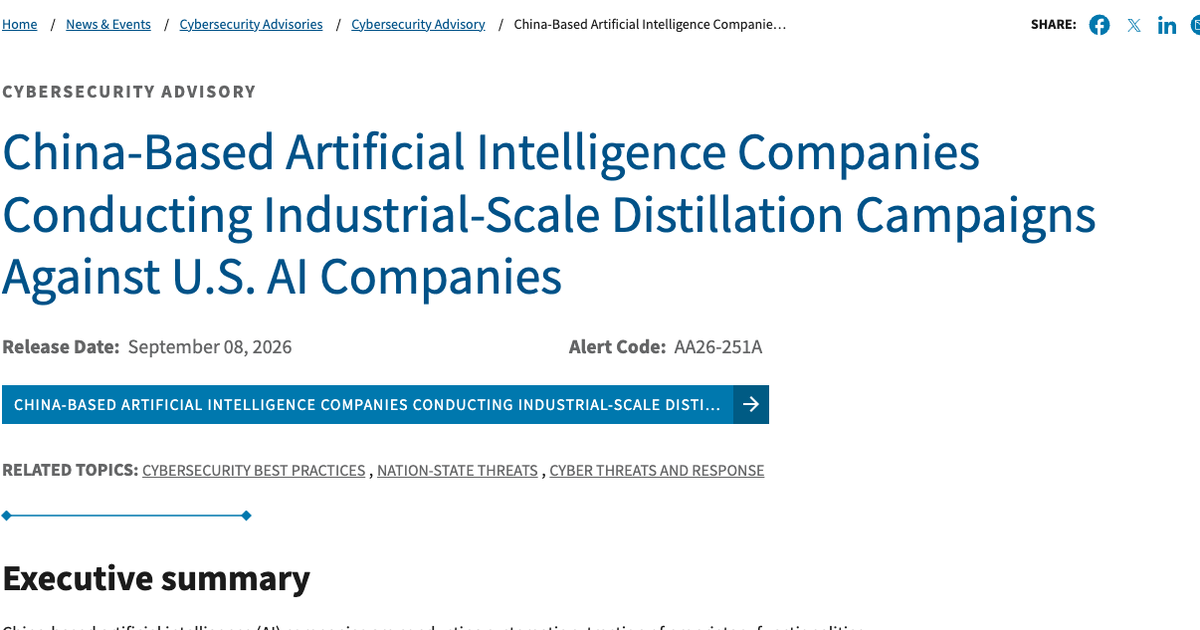
NSA·CISA·FBI가 9월 8일 권고 AA26-251A로 DeepSeek과 Alibaba 등 6곳을 지목했습니다. 제공사에 권한 대응은 계정 차단이 아니라 알리지 않는 응답 품질 저하이고, 탐지 지표는 24시간 도는 프로덕션 에이전트와 구분되지 않습니다.