Kimi K3의 추론을 짧게 다시 학습한 Ember-1, 토큰 절감은 5.9%에서 51.9%까지
Fireworks가 Kimi K3를 후처리 학습한 Ember-1을 9월 23일 공개하고 27일 OpenRouter와 Vercel AI Gateway에 올렸습니다. 단가는 K3와 똑같은 3달러/15달러인데 벤치마크 5종의 토큰 절감폭은 5.9%에서 51.9%까지 벌어졌습니다.
- Fireworks가 Kimi K3를 짧게 생각하도록 후처리 학습해 같은 단가로 내놨습니다.
- 토큰 절감폭은 벤치마크마다 5.9%에서 51.9%까지 갈립니다.
- 가중치는 비공개라
fireworks/ember-1엔드포인트에서만 돌아갑니다.
추론 모델 요금은 답에서 나오지 않습니다. 모델이 답하기 전에 혼자 생각하는 동안 쌓입니다. Fireworks Research가 9월 23일 공개한 Ember-1은 그 생각을 짧게 만드는 후처리 학습만으로 만든 모델입니다. 바탕은 Moonshot AI의 Kimi K3이고, 9월 27일 OpenRouter와 Vercel AI Gateway에 올라오면서, 그 게이트웨이를 쓰던 곳에서는 모델 이름만 바꿔 부를 수 있게 됐습니다.
새 능력을 더한 모델이 아닙니다. 같은 작업을 시켰을 때 모델이 덜 떠들게 만들어 출력 토큰 청구서를 줄입니다. 하는 일은 그게 전부입니다.
Kimi K3와 달라진 것은 추론 길이 하나
Ember-1은 Kimi K3와 같은 2.78T 규모의 MoE 모델이고, 컨텍스트 창도 104만 토큰으로 같습니다. 값도 같습니다. 100만 토큰당 입력 3달러, 캐시된 입력 0.30달러, 출력 15달러입니다. 단가가 같으니 절감은 전부 토큰 수에서만 나옵니다.
Fireworks가 밝힌 출발점은 Kimi K3의 토큰 배분입니다. "Kimi K3 같은 추론 모델은 생성 토큰의 대부분, 때로는 90%가 넘는 양을 내부 추론에 씁니다." 사용자가 읽는 답은 남은 10% 남짓입니다.
reasoning_effort를 낮춰보는 쪽은 통하지 않았다고 적었습니다. "K3의 추론 강도를 낮추는 것으로는 해결되지 않았습니다. 낮은 설정은 품질을 너무 많이 내줬습니다." Kimi K3는 reasoning_effort를 low, high, max 세 단계로 받고 기본값이 max입니다. Fireworks는 그 다이얼 대신 모델 자체를 다시 학습시키는 쪽을 골랐습니다. 수학, 코딩, 지시 따르기, 대화, 검색, 도구 사용, 소프트웨어 엔지니어링에 걸쳐 실험 50회와 평가 200회를 돌렸고, 자기 반성은 남기되 같은 자리를 맴도는 추론 루프만 없애도록 훈련했다고 설명합니다.
발표문이 낸 벤치마크 5종입니다. 비교 대상 "K3 Max"는 Kimi K3를 기본 설정인 reasoning_effort=max로 돌린 값입니다.
| 벤치마크 | 표본 | Kimi K3 | Ember-1 | 토큰 감소 |
|---|---|---|---|---|
| Terminal Bench 2.1 | 89 | 80.9% | 82.0% | 51.9% |
| SWE-bench Verified | 500 | 93.2% | 92.2% | 15.5% |
| SWE-Interact | 75 | 21.3% | 20.0% | 32.5% |
| DeepSWE 1.1 | 113 | 66.4% | 75.2% | 23.7% |
| τ-2 Bench Airline | 50 | 64% | 66% | 5.9% |
점수만 보면 5종 중 3종에서 올랐고 2종에서 내렸습니다. DeepSWE 1.1이 66.4%에서 75.2%로 8.8포인트 올라 가장 크게 움직였습니다. 내린 쪽은 SWE-Interact 1.3포인트와 SWE-bench Verified 1.0포인트로 폭이 훨씬 작습니다. 다만 표본이 50건에서 500건 사이라 1포인트 안팎의 차이를 유의미한 향상으로 읽기는 어렵습니다.
"40% 절감"은 벤치마크마다 다른 숫자였다
발표문 대표 문구는 "토큰 40% 절감"입니다. 실제로 그 40%에 가까운 벤치마크는 하나도 없습니다. 위 표의 감소폭을 크기 순으로 세우면 이렇습니다.
출처: Fireworks 공식 발표문의 벤치마크 표. 막대 길이는 Kimi K3 대비 생성 토큰 감소율.
위아래 차이가 아홉 배 가까이 납니다. 달러로 환산한 절감액은 더 벌어집니다. τ-2 Bench Airline은 50건을 다 돌려 0.3달러를 아꼈고, DeepSWE 1.1은 113건에서 126.9달러를 아꼈습니다.
폭이 벌어진 이유는 과제 성격입니다. 원래 길게 생각하던 과제일수록 줄일 여지가 큽니다. Terminal Bench 2.1은 터미널에서 여러 단계를 밟느라 추론이 길게 늘어집니다. 반대로 τ-2 Bench Airline은 항공 예약 대화를 몇 턴 주고받는 과제라 원래 추론이 짧고 깎을 것이 없습니다. 내 워크로드가 어느 쪽에 가까우냐에 따라 절감은 50%가 될 수도, 6%에 그칠 수도 있습니다.
고객 두 곳에서 잰 실제 수치
Fireworks는 벤치마크와 별개로 고객 두 곳의 코딩 워크로드에서 A/B 테스트를 돌린 결과를 함께 실었습니다.
출력 토큰이 39% 줄었고 과제 점수는 0.751에서 0.753으로 사실상 그대로입니다. 발표문은 이 결과를 "무소식이 희소식"이라고 적었습니다. "개발자들은 모델이 바뀐 것을 알아채지 못한 채 하던 일을 계속했고, 토큰은 눈에 띄게 덜 썼습니다." 다만 고객 두 곳에서 Fireworks가 직접 잰 수치이고, 어떤 작업이었는지는 공개하지 않았습니다.
값은 내려가도 프런티어를 다 가져가지는 못했다
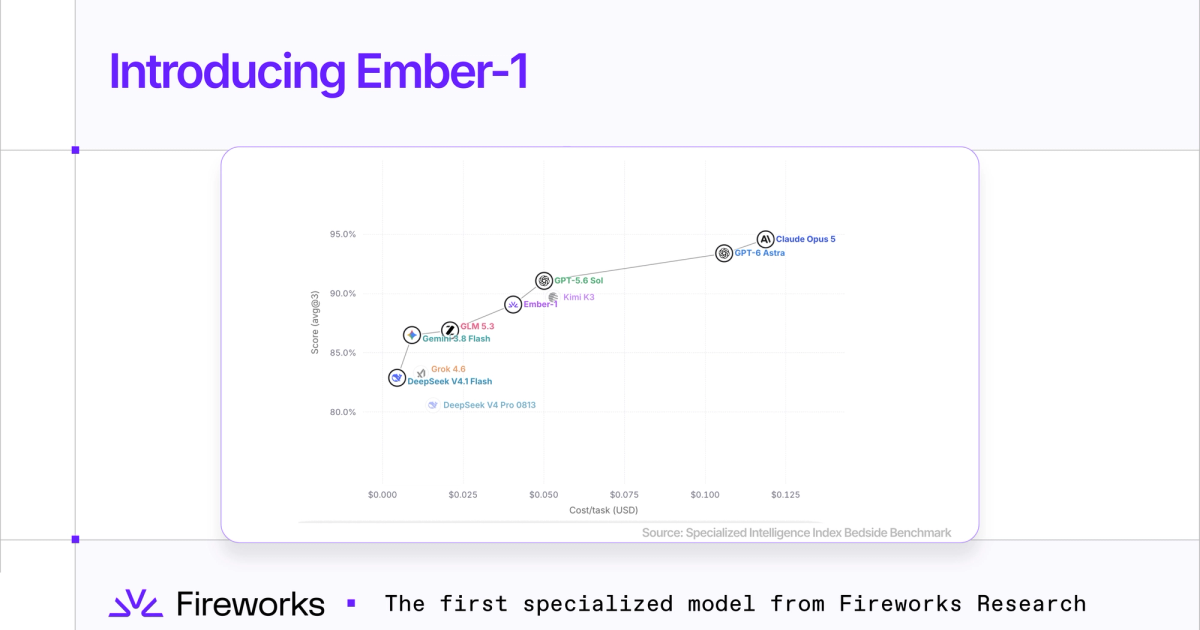
발표문이 자랑한 다른 지표는 Doximity의 Bedside Bench입니다. 임상 사례 500건을 푸는 과제에서 GPT-5.6 Sol, GPT-6 Astra, Claude Opus 5, GLM 5.3을 포함한 공개·비공개 모델을 통틀어 새 파레토 프런티어를 세웠다고 적었습니다. 과제당 비용을 가로축에 두면 Ember-1은 Kimi K3와 거의 같은 점수를 더 왼쪽에서 냅니다.
같은 벤치마크를 시간 축으로 바꿔 그리면 Ember-1은 프런티어에서 내려옵니다.
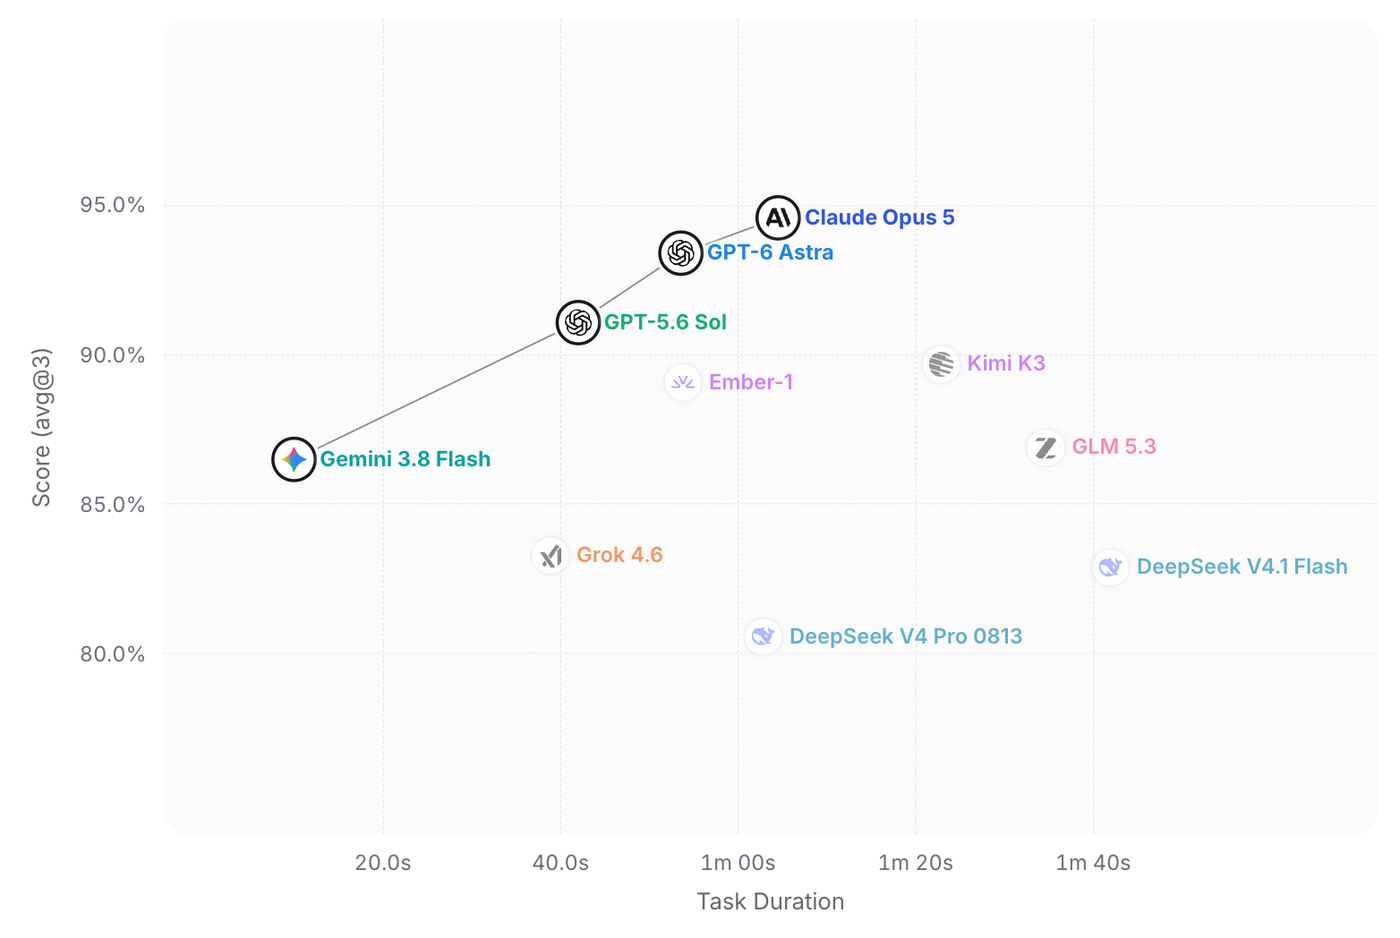
Ember-1은 Kimi K3보다 왼쪽에 있습니다. 생성 토큰이 줄었으니 그만큼 빨리 끝납니다. 그런데 프런티어 선을 잇는 것은 Gemini 3.8 Flash, GPT-5.6 Sol, GPT-6 Astra, Claude Opus 5이고 Ember-1은 그 아래에 있습니다. GPT-5.6 Sol은 Ember-1보다 짧은 시간에 더 높은 점수를 냅니다. 요금이 아니라 응답 대기가 병목인 서비스라면 Ember-1으로 바꿔도 얻는 것이 크지 않습니다.
Hacker News에서 나온 반론
9월 27일 올라온 Hacker News 글은 584점과 249개 댓글을 받았습니다. 반론은 다섯 갈래였습니다.
- 무엇을 잃었는지가 표에 없다.
tomrod는 벤치마크가 절반만 보여준다고 썼습니다. 토큰을 줄이면서 어떤 능력이 깎였는지를 구분해 적지 않았다는 지적입니다. 댓글에서는 golang 작업에서 성능이 퇴행한 사례가 나왔습니다. - 주장만큼 압도하지 않는다. Opus 5.5와 GPT-6 Sol이 특정 지표에서 Ember-1보다 앞선다는 것이
7777777phil의 반박입니다. - 더 싼 대안이 이미 있다.
netvarun에 따르면 GLM 5.3이 Kimi K3와 비슷한 성능을 절반 이하 값에 냅니다. 토큰을 40% 줄여도 단가가 두 배면 남는 게 없습니다. - 방법 설명이 모호하다. "task and environment feedback", "on-policy planning" 같은 표현을 두고
kingstnap은 과학적으로 들릴 뿐 정보가 없다고 썼습니다. 학습 알고리즘도 데이터도 공개되지 않았습니다. - 오픈웨이트라는 말의 범위.
intothemild가 짚은 대로, 바탕이 된 Kimi K3부터가 라이선스 제약이 커서 자유롭게 쓸 수 있는 가중치로 보기 어렵습니다.
Ember-1 자체는 가중치도 학습 코드도 공개되지 않았습니다. 파인튜닝도 막혀 있고, 자체 호스팅은 불가능합니다. 다른 곳에서 검증하려면 API를 불러 결과를 재는 방법밖에 없습니다.
지금 켤 수 있는 조건
1차 소스에서 확인한 조건입니다.
| 항목 | 내용 |
|---|---|
| 대상 | 누구나. 대기자 명단이나 신청 절차가 없습니다 |
| 가격 | 100만 토큰당 입력 3달러, 캐시된 입력 0.30달러, 출력 15달러. Kimi K3와 동일 |
| 컨텍스트 | 104만 토큰. 텍스트와 이미지 입력, 함수 호출, 암묵적 프롬프트 캐시 지원 |
| 상태 | Research Preview. 2주 서버리스 접근으로 시작해 수요에 따라 영구화 |
| 제약 | Fireworks 서버리스 전용. 가중치 비공개, 파인튜닝 불가, 자체 호스팅 불가 |
| 데이터 | Fireworks 엔드포인트는 Zero Data Retention과 No Prompt Training 지원 |
| 한국 사용 가능 여부 | Fireworks API, OpenRouter, Vercel AI Gateway 모두 지역 제한 고지가 없습니다. 결제는 USD 카드 |
모델 ID는 세 경로 모두 fireworks/ember-1입니다. OpenAI 호환 엔드포인트라 기존 코드에서 바꿀 곳은 한 줄입니다.
curl https://openrouter.ai/api/v1/chat/completions \
  -H "Authorization: Bearer $OPENROUTER_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "fireworks/ember-1",
    "messages": [{"role": "user", "content": "이 저장소의 테스트 실패 원인을 찾아줘"}]
  }'
Kimi K3로 에이전트를 돌리고 있다면 확인은 반나절이면 끝납니다. 단가가 같으니 응답의 usage.completion_tokens만 모델 두 개로 나눠 재면 됩니다. 이때 벤치마크 평균인 40%가 아니라 내 과제에서 나온 숫자를 봐야 합니다. 위 표에서 보듯 같은 모델도 과제에 따라 5.9%에서 51.9%까지 달라지고, 여러 단계를 밟는 코딩 작업일수록 절감 폭이 큽니다. 2주 프리뷰 창은 9월 22일부터 세므로 10월 초에 닫힐 수 있고, 영구 제공 여부는 그때까지 모인 수요로 정해집니다. 그 전에 한 번 재두면 창이 닫혀도 다음 모델을 고를 기준이 남습니다. 절감이 기대에 못 미치면 모델 대신 하네스를 손볼 차례입니다. devlery가 앞서 정리한 같은 모델로 토큰값 28% 줄인 AWS Strands harness의 세 가지 기본값이 같은 청구서의 다른 쪽을 건드립니다.