같은 모델로 토큰값 28% 줄인 AWS Strands harness, 차이는 기본값 세 개
AWS가 9월 21일 에이전트 하네스 Strands harness를 Apache 2.0으로 공개했습니다. 같은 Claude·GPT 모델을 쓰고도 벤치마크 6종 평균 토큰 비용이 28% 낮았고, 차이를 만든 건 도구 결과 절단과 85% 압축 같은 기본값입니다.
- AWS가 에이전트 하네스
Strands harness를 Apache 2.0으로 공개했습니다. - 같은 Fable 5로 잰 비용이 Claude Code의 4분의 1이었습니다.
- 벤치마크는 AWS가 직접 돌렸고 상세 표는 후속 논문으로 미뤘습니다.
에이전트 비용을 줄이려면 더 싼 모델로 갈아타는 수밖에 없다고 생각하기 쉽습니다. AWS Strands 팀이 9월 21일 공개한 측정값은 그렇지 않습니다. 모델을 똑같이 고정하고 그 바깥의 프로그램만 바꿨더니 같은 벤치마크를 한 바퀴 도는 비용이 네 배 가까이 벌어졌습니다.
여기서 말하는 바깥의 프로그램을 하네스(harness)라고 부릅니다. 모델에 도구를 쥐여주고, 결과를 받아 다시 물어보고, 대화가 길어지면 잘라내는 쪽입니다. Claude Code나 Codex가 하는 일에서 모델이 하는 추론을 빼면 남는 부분이 전부 하네스입니다. 이 부분은 지금까지 회사마다 알아서 만들었습니다. 직접 에이전트를 만드는 사람은 그 조립을 매번 처음부터 다시 했습니다.
AWS가 공개한 것은 그 조립을 끝내 놓은 하네스입니다. 파이썬에서 create_harness() 한 줄이면 셸·파일·웹 도구를 갖춘 에이전트가 돌아갑니다. 모델은 이름으로 지정하고, AWS 계정은 없어도 됩니다.
같은 모델을 쓰고도 비용이 네 배 벌어졌다
발표문이 낸 대표 수치는 벤치마크 6종 평균에서 토큰 비용 28% 절감입니다. 비교 조건은 "같은 Claude 또는 GPT 모델"입니다. 모델을 바꿔서 싸진 게 아니라 모델은 그대로 둔 채 하네스만 바꿨을 때 생긴 차이입니다.
가장 벌어진 항목은 Terminal-Bench 2.1입니다. Claude Fable 5로 하네스마다 89회씩 돌린 결과입니다.
| 하네스 | 비용 | 정확도 |
|---|---|---|
| Strands harness | 56.29달러 | 69.7% |
| Oh-my-pi | 86.83달러 | 69.7% |
| OpenCode | 73.42달러 | 66.3% |
| Claude Code | 248.05달러 | 61.8% |
| DeepSeek Harness | 40.30달러 | 59.5% |
Claude Code가 248.05달러에 61.8%, Strands harness가 56.29달러에 69.7%입니다. 쓴 모델이 양쪽 다 Claude Fable 5입니다. 값이 4분의 1로 내려가면서 점수는 7.9포인트 올라갔습니다. 발표문은 이 항목을 "Fable 5에서 Claude Code보다 77% 저렴"으로 표현했습니다.
표에서 같이 봐야 할 다른 줄은 가장 싼 DeepSeek Harness입니다. 40.30달러로 Strands harness보다 더 적게 썼지만 정확도가 59.5%로 목록에서 가장 낮습니다. AWS도 발표문에 이 대목을 먼저 적었습니다. 토큰을 덜 쓰는 것만으로는 좋은 하네스가 아닙니다. 비용 차이가 커 보여도 정확도 열을 함께 읽어야 합니다.
나머지 측정 조건입니다. 여섯 벤치마크는 ALFWorld, ContextBench, GAIA, WebShop, τ²-bench, Terminal-Bench 2.1이고, 실행은 EC2에서 Harbor로 분산해 돌렸습니다. 표의 달러는 과제 한 건이 아니라 89회 시도를 다 돌린 비용으로 보도됐습니다.
차이를 만든 기본값 세 개
AWS는 이 효율이 어디서 나왔는지를 발표문에서 직접 지목했습니다. 모델이나 프롬프트가 아니라 컨텍스트 관리 기본값입니다. 세 줄입니다.
첫 줄이 가장 큽니다. 에이전트가 파일을 읽거나 명령을 돌리면 결과가 통째로 대화에 들어가고, 그 대화는 다음 요청마다 다시 전송돼 다시 청구됩니다. devlery가 앞서 정리한 한 번 읽은 파일이 470턴 동안 다시 청구되는 문제가 이것입니다. 1,500토큰에서 자르면 긴 결과가 대화에 눌러앉지 못합니다. 잘린 원본은 버리지 않고 파일로 내보내 두었다가 필요할 때 다시 읽습니다.
둘째 줄은 언제 요약할지를 정합니다. 컨텍스트 창이 가득 차고 나서 손쓰면 이미 비싼 요청을 여러 번 보낸 뒤입니다. 85%에서 미리 압축을 걸면 그 구간을 건너뜁니다. 셋째 줄은 그래도 넘칠 때의 대비로, 작업을 실패로 끝내지 않고 루프 안에서 복구합니다. 여기에 프롬프트 캐시 기본값이 더해져 매 요청에서 반복되는 앞부분을 다시 계산하지 않습니다.
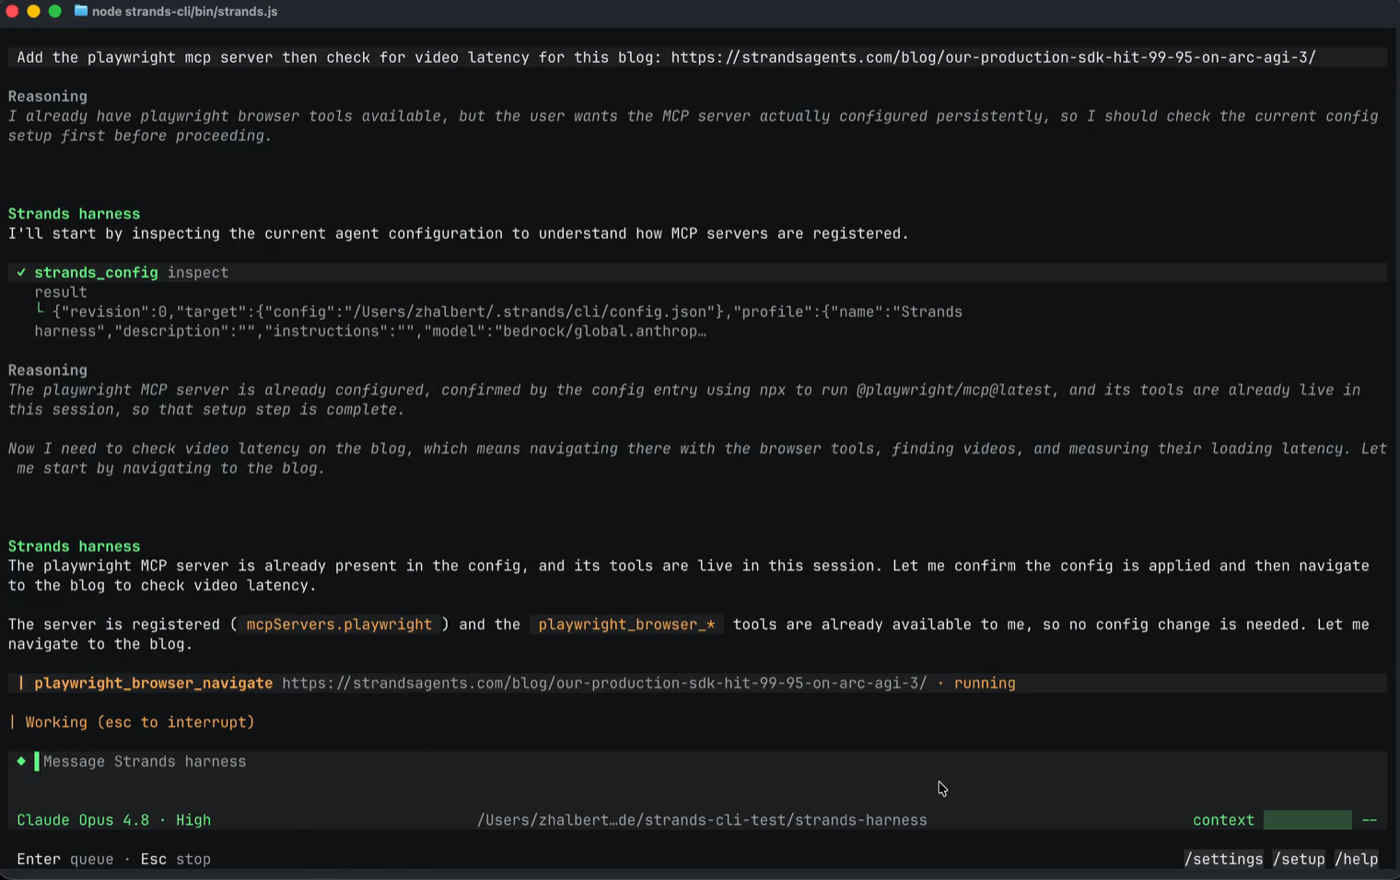
이 세 값은 Strands harness를 안 쓰는 사람에게도 그대로 적용됩니다. 직접 만든 루프에 숫자 세 개만 옮겨 넣으면 됩니다. 도구 결과에 길이 상한을 걸고, 압축 시점을 창이 다 차기 전으로 당기고, 오버플로를 예외가 아니라 복구 경로로 처리합니다. AWS가 내놓은 것 중 실무에 가장 빨리 닿는 쪽은 프레임워크가 아니라 이 세 값입니다.
이 수치를 어디까지 믿을지
벤치마크를 AWS가 직접 돌렸습니다. 발표문도 상세 표를 싣지 않았고 "연구진의 후속 논문"으로 미뤘습니다. 위 표의 하네스별 비용과 정확도는 발표 이후 2차 보도와 토론을 거쳐 정리된 것입니다. 논문이 나오기 전까지는 재현된 숫자가 아니라 벤더가 낸 숫자로 읽는 편이 맞습니다.
Hacker News 토론(143점, 96댓글)에서 나온 반론도 같은 곳을 짚습니다.
- Terminal-Bench 2.1이 포화 상태라는 지적. 상위 하네스가 이미 비슷한 점수대에 몰려 있으면, 이 벤치마크에서 앞섰다고 다른 작업에서도 앞선다는 보장이 없습니다.
- 비교 목록에서 vanilla Pi가 빠진 점. 토큰 사용량을 유의미하게 못 이겨서 뺀 것 아니냐는 의심이 달렸습니다.
- 장기 과제에서의 손실. 85% 압축과 도구 결과 절단은 짧은 과제에서 이득이지만, 수백 턴을 도는 작업에서 잘려 나간 정보가 나중에 필요해지면 오히려 손해라는 우려입니다.
- 외부 리더보드와 맞대면 안 된다는 점. Artificial Analysis 같은 곳은 하네스 구성이 달라, 여기 69.7%를 거기 점수와 나란히 놓으면 안 됩니다.
실사용 후기는 아직 적습니다. 토론 대부분이 수치를 두고 벌어졌고 써봤다는 댓글보다 다른 하네스를 쓰겠다는 댓글이 많았습니다. 가벼운 vanilla Pi를 꼽은 사람, 제공사 지원 폭 때문에 OpenCode를 쓴다는 사람, 직접 만든 하네스가 낫다는 사람이 있었습니다. TypeScript 에이전트에는 Mastra가 낫다며 옮긴 사례도 나왔습니다.
오늘 설치해볼 수 있는 조건
1차 소스에서 확인한 조건입니다.
| 항목 | 내용 |
|---|---|
| 대상 | 누구나. 대기자 명단이나 베타 신청 절차가 없습니다 |
| 요금제 | 하네스는 무료(Apache 2.0). 모델 호출 비용은 고른 제공사에 따로 청구됩니다 |
| AWS 계정 | 필요 없습니다. Anthropic·OpenAI·Google·Ollama·LiteLLM을 직접 지정할 수 있습니다 |
| 한국 사용 가능 여부 | PyPI·npm 패키지라 설치에 지역 제한이 없습니다. 로컬 Ollama로 돌리면 외부 호출 자체가 없습니다 |
| 필요 조건 | Python 3.10 이상 또는 Node.js 22 이상. 배포는 Linux 컨테이너가 되는 곳 |
설치와 최소 실행 코드입니다.
pip install strands-harness
# 또는
npm install @strands-agents/harness
from strands_harness import create_harness

agent = create_harness(model="anthropic/claude-opus-5")
agent("벡터 데이터베이스 상위 세 곳의 가격과 한도를 비교해 comparison.md에 정리해줘")
Strands harness는 코딩 에이전트가 아니라 범용 에이전트를 목표로 만들었습니다. 셸·파일·웹이라는 기본 도구도 "모델이 이미 쓸 줄 아는 원시 도구"를 고른 결과이고, 과제별 전용 도구는 얹지 않았습니다. 세션 ID로 이전 대화를 이어받고, 열린 과제는 보조 에이전트에 넘기고, 다단계 작업은 체크리스트로 추적합니다. 배포는 Modal, Cloudflare Containers, Azure Container Apps, Google Cloud Run, Amazon ECS, Amazon Bedrock AgentCore가 발표문이 명시한 예시입니다. 대화형으로 먼저 만져보려면 npm install -g @strands-agents/cli로 Strands CLI를 설치한 뒤 /export로 파이썬이나 TypeScript 코드를 뽑아낼 수 있습니다.
에이전트 루프를 이미 직접 굴리고 있다면, 하네스를 갈아타기 전에 숫자 하나부터 옮겨보는 쪽이 빠릅니다. 도구 결과에 1,500토큰 상한을 걸고 이번 주 실행 로그의 입력 토큰 합계를 적용 전후로 비교하면, 28%라는 수치가 내 작업에서 얼마가 되는지 반나절이면 확인됩니다. 그 숫자가 의미 있게 나올 때 하네스 전체를 바꿀지 따져도 늦지 않고, AWS의 후속 논문은 그때 재현 조건을 확인하는 용도로 쓰면 됩니다.