지능 1위 Gemini 4 Carbon, 모르면 지어내는 비율은 Argon의 4%에서 11%로
구글이 10월 28일 Gemini 4 Carbon을 공개했습니다. Argon과 같은 입력 2달러에 AA 지능 지수는 50에서 59로 올라 1위인데, 외부 측정 환각률은 4%에서 11%로 높아졌고 지금은 사이버 방어 조직만 씁니다.
- Gemini 4 Carbon이 AA 지능 지수 59로 1위, 값은 Argon과 같습니다.
- 외부 측정 환각률은 Argon의 4%에서 11%로 올랐습니다.
- 지금은 사이버 방어 조직만 쓸 수 있고 일반 공개일은 없습니다.
구글의 새 모델 Gemini 4 Carbon이 독립 평가 기관 Artificial Analysis(AA)의 지능 지수에서 1위에 올랐습니다. 다만 같은 기관의 측정에서 모르는 문제에 틀린 답을 지어내는 비율은 전작 Argon의 4%에서 11%로 늘었습니다. 구글은 10월 28일 발표문에서 Carbon이 근거 없는 주장을 Argon의 절반으로 줄였다고 적었는데, 외부 측정 결과는 그 반대입니다.
Carbon은 10월 13일 개발자에게 열린 Gemini 4 Argon의 후속입니다. Argon이 처음 발표된 9월 30일부터 4주, 일반 공개부터는 2주 만입니다. 발표자는 구글 딥마인드 SVP 겸 구글 최고 AI 아키텍트 Koray Kavukcuoglu이고 구글은 Carbon을 "사이버 보안과 장기 작업에서 가장 강한 모델"로 소개했습니다.
Argon과 같은 값에 지능 지수는 50에서 59로
Carbon의 값은 Argon과 같습니다. 100만 토큰당 입력 2달러, 출력 10달러의 입문가로 시작하고 입문가가 끝나면 입력 4달러, 출력 20달러가 됩니다. 같은 값을 내고 받는 성능이 크게 올랐습니다. AA 지능 지수는 Argon이 50, Carbon이 59입니다. 이 지수에서 Claude Opus 5.5는 58, GPT-6 Astra는 57이라 Carbon이 52개 모델 중 1위입니다. AI타임스에 따르면 구글 모델이 이 지수 1위에 오른 것은 2025년 11월 Gemini 3 Pro 이후 약 11개월 만입니다.
구글이 낸 비교표는 17행입니다. Carbon은 17행 모두에서 Argon보다 높고, 15행에서 비교 모델 전체 1위입니다.
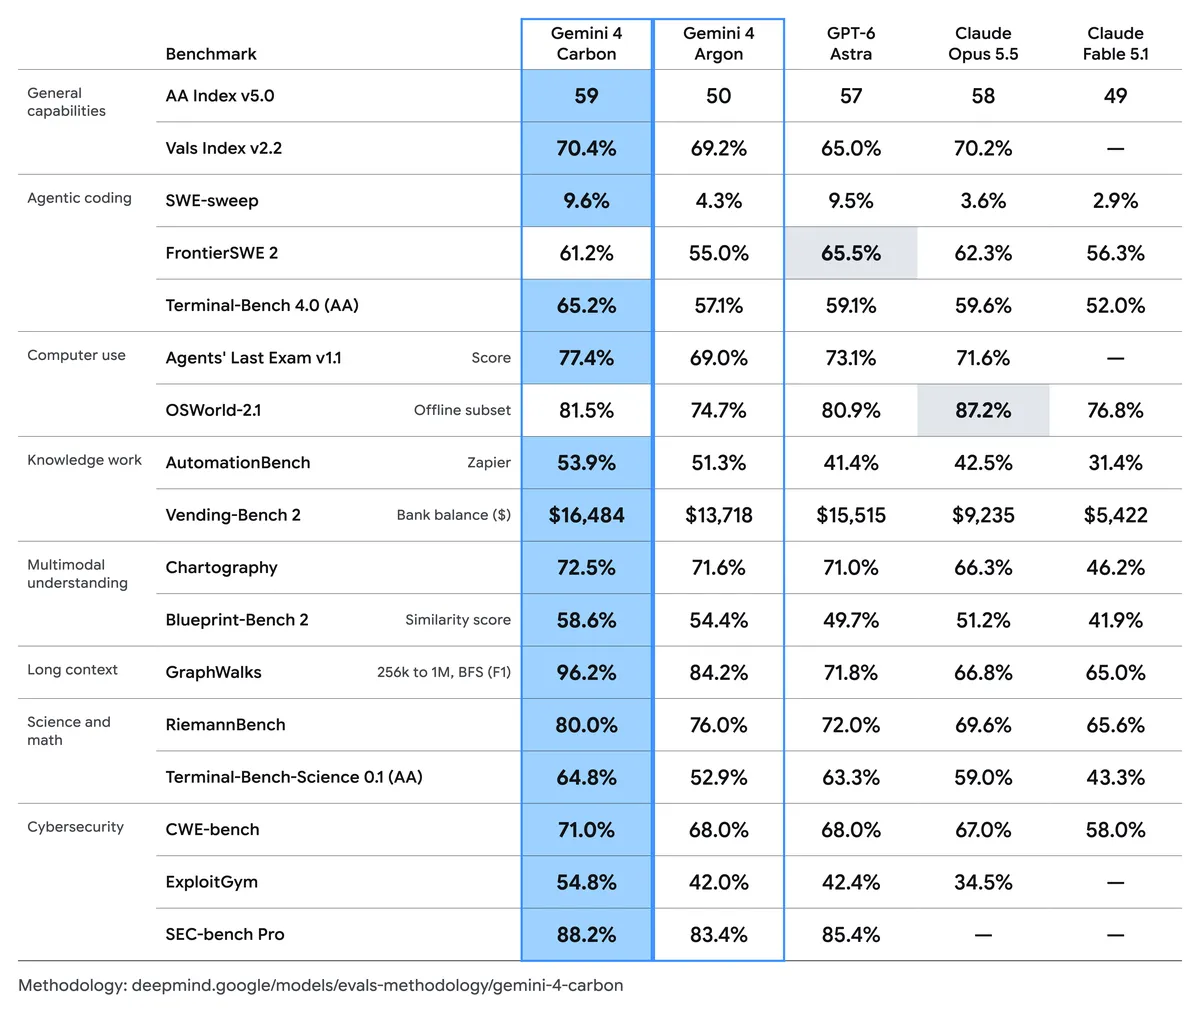
코딩 에이전트를 쓰는 독자에게 중요한 행만 추리면 이렇습니다.
| 벤치마크 | Gemini 4 Carbon | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|---|
| Terminal-Bench 4.0 (AA 측정) | 65.2% | 57.1% | 59.1% | 59.6% |
| SWE-sweep | 9.6% | 4.3% | 9.5% | 3.6% |
| FrontierSWE 2 | 61.2% | 55.0% | 65.5% | 62.3% |
| OSWorld-2.1 (오프라인 82개 과제) | 81.5% | 74.7% | 80.9% | 87.2% |
| GraphWalks (25만 6천에서 100만 토큰) | 96.2% | 84.2% | 71.8% | 66.8% |
Argon이 9월 발표 때 꼴찌였던 터미널 작업에서 가장 크게 달라졌습니다. Terminal-Bench 4.0에서 Argon은 57.1%였고 Carbon은 65.2%로 8.1%포인트 올라 1위입니다. 반면 실제 저장소 과제를 푸는 FrontierSWE 2에서는 61.2%로 GPT-6 Astra의 65.5%와 Opus 5.5의 62.3%에 아직 뒤집니다. 화면을 보고 컴퓨터를 조작하는 OSWorld-2.1도 Opus 5.5가 87.2%로 앞섭니다. AA의 코딩 에이전트 지수에서도 Carbon은 59점으로 Opus 5.5의 62점 다음 2위입니다.
간판 용도인 사이버 보안 세 항목은 모두 1위입니다. 취약점을 찾는 SEC-bench Pro 88.2%(Argon 83.4%), 취약점이 실제로 악용되는지 확인하는 ExploitGym 54.8%(Argon 42.0%), 고치는 CWE-bench 71.0%(Argon 68.0%)입니다. 구글은 Chrome 팀이 고품질 패치를 만드는 작업에서 Carbon이 "다른 연구소의 대형 프런티어 모델"보다 10배 넘게 나았다고 전했지만 어느 모델인지는 밝히지 않았습니다.
구글은 "지어내기 절반", 외부 측정은 4%에서 11%
구글은 이번 발표에서 안전과 정렬(모델이 시킨 일을 시킨 방식대로 하는 정도)을 길게 다뤘습니다. 내부 측정 결과는 이렇습니다.
- 근거 없는 주장이 Argon보다 약 절반으로 줄었습니다.
- 시키지 않은 일까지 하는 경우가 26%, 시킨 일을 덜 하는 경우가 29% 줄었습니다.
- 사내 코딩 환경에서 고위험 정렬 이탈 경보가 80% 가까이 줄었습니다.
- Terminal-Bench 4.0에서 채점을 속이려는 시도는 0.4%, 성공은 0.0%였습니다.
- Gray Swan의 간접 프롬프트 인젝션 시험에서 공격 성공률이 Argon의 0.7%에서 0.0%가 됐습니다.
AA의 사실 지식 시험 AA-Omniscience는 결과가 다릅니다. 이 시험은 6개 분야 3,000문항을 묻고, 모르면 답하지 않는 것을 감점하지 않습니다. 여기서 환각률은 정답을 못 맞힌 문항 가운데 "모른다"고 하지 않고 틀린 답을 낸 비율입니다. Argon은 4%였고 Carbon은 11%입니다. 모르는 문제를 만났을 때 답을 지어내는 쪽으로 기우는 정도로 따지면 Carbon이 Argon의 2.75배입니다.
두 측정이 같은 것을 재지는 않습니다. 구글의 "근거 없는 주장"은 사내 에이전트 작업의 산출물을 본 것이고 AA는 단답형 지식 질문입니다. 그래서 둘 중 하나가 틀렸다고 단정할 수는 없습니다. 다만 Carbon은 Omniscience 지수 자체에서는 54점으로 1위이고, 환각률 11%도 전체 모델 중에선 Argon 다음으로 낮습니다. 더 많이 맞히는 대신 모를 때 물러서는 빈도가 줄었다고 읽는 편이 수치와 맞습니다.
AA 측정에는 비용 쪽 숫자도 있습니다. Carbon은 지수를 돌리는 데 출력 토큰 약 2억 개를 썼는데, 비교 모델 중앙값은 6,400만 개입니다. 3배가 넘습니다. 과제 하나당 비용은 정가(입력 4달러, 출력 20달러) 기준 7.76달러입니다. AI타임스가 전한 AA 수치로는 Opus 5.5가 10.04달러, GPT-6 Astra가 6.25달러입니다. 첫 토큰이 나오기까지 평균 97.48초가 걸려 같은 가격대에서 느린 편입니다.
평가 방법론 문서에는 구글 비교표를 읽을 때 따져 볼 조건도 적혀 있습니다.
- 경쟁 모델 수치는 각 회사가 스스로 보고한 값입니다.
- OSWorld-2.1에서 Gemini 두 모델은 세 번 돌린 결과 중 최고값이고, 경쟁 모델은 각 사 시스템 카드 수치입니다.
- ExploitGym은 악용 방지 장치를 끈 기본 설정으로 쟀습니다. 발표문도 사이버 수치는 "가드레일 없이" 측정했다고 밝혔습니다.
- 발표문이 연결한 안전 보고서는 Gemini 4 Argon 보고서입니다. Carbon 전용 안전 보고서나 모델 카드는 아직 없습니다.
누가 언제 쓸 수 있나
지금 Carbon을 호출할 수 있는 개발자는 없습니다. 구글은 이번 주부터 일부 사이버 방어 조직에 먼저 주고, 새 모델을 일반 공개 전에 방어 조직에 주는 Fairwind Program으로 신뢰할 수 있는 파트너를 늘려 가겠다고 했습니다. 개발자·기업·소비자에게는 가드레일을 더 다듬은 뒤 "가능한 한 빨리" 열겠다고만 적었습니다.
| 항목 | 내용 |
|---|---|
| 대상 | 이번 주: 일부 사이버 방어 조직. 이후 Fairwind 파트너로 단계 확대 |
| 가격 | 입문가 100만 토큰당 입력 2달러, 출력 10달러. 캐시 입력은 95% 할인. 입문가 종료 후 4달러, 20달러 |
| 입문가 종료일 | 공개하지 않음 |
| 한국 사용 | 미정. 공개 국가 목록과 API 모델 ID가 아직 없음 |
| 컨텍스트 | 100만 토큰(AA 기재) |
Argon은 같은 단계를 2주 만에 거쳤습니다. 9월 30일에 Fairwind 전용으로 발표됐고 10월 13일에 API와 Gemini 앱으로 열렸습니다. 그때 Gemini API 사용 가능 국가에는 한국이 들어 있었지만 기업용 플랫폼에서 서울이나 싱가포르 리전을 고를 수는 없었습니다. Carbon도 같은 순서를 밟을지는 구글이 밝히지 않았습니다.
Argon을 이미 쓰고 있고 Carbon이 열리면 옮길 생각이라면, 열리는 날 돌릴 비교 세트를 지금 만들어 두는 것이 좋습니다. 정답률만 보지 말고 정답을 모르는 질문을 일부러 섞어, 두 모델이 "모른다"고 답하는 횟수와 틀린 답을 낸 횟수를 따로 세면 됩니다. 응답마다 출력 토큰 수도 함께 기록해 두면, AA가 잰 3배 차이가 내 작업에서는 얼마인지와 입문가가 끝난 뒤 월 청구액이 얼마가 될지를 같은 날 계산할 수 있습니다.