시간당 0.84달러 Gemini 3.8 Live, 에이전트 과제는 전작 37.7%에서 30.1%로
구글이 9월 15일 음성 모델 두 종을 냈습니다. 값싼 gemini-3.8-live는 종합 지수가 71.5%에서 76.0%로 올랐지만 도구를 쓰는 과제 완료율은 전작보다 낮습니다.
- 구글이 9월 15일 Gemini 3.8 Live 음성 모델 두 종을 열었습니다.
- 싼 쪽은 도구 과제 완료가 전작 37.7%에서 30.1%로 내려갔습니다.
- 도구를 호출하는 음성 에이전트는 시간당 3.50달러짜리를 써야 합니다.
구글이 2026년 9월 15일 음성 모델 두 종을 열었습니다. gemini-3.8-live와 gemini-3.8-live-extended-thinking입니다. 둘 다 Live API용 음성 대 음성(speech-to-speech) 모델입니다. 사람이 마이크에 대고 말하면 글자로 받아적는 단계를 건너뛰고 바로 소리로 대답합니다. 콜센터 상담원, 매장 주문 접수, 말로 시키는 비서처럼 사람이 말하는 동안 모델이 뒤에서 조회나 예약 같은 실제 작업을 해야 하는 제품에 씁니다. 전작은 gemini-3.1-flash-live-preview입니다.
발표문에는 구글이 직접 실은 벤치마크 차트가 두 장 있습니다. 한 장에서는 새 모델이 전작을 앞서지만 다른 한 장에서는 순서가 뒤집힙니다.
전작보다 나아진 것과 나빠진 것
값싼 gemini-3.8-live는 종합 점수가 올랐고 응답은 빨라졌습니다. Artificial Analysis의 Speech to Speech Index에서 76.0%를 받았습니다. 전작 gemini-3.1-flash-live-preview의 고추론 설정(High)은 71.5%였으니 4.5%포인트 높습니다. 첫 소리가 나오기까지 걸리는 시간은 전작 2.99초에서 1.18초로 줄었습니다. 대화 도중 상대가 말을 끊었다 이어가는 느낌에 직접 영향을 주는 수치입니다.
그런데 같은 발표문의 두 번째 차트를 보면 순서가 달라집니다.
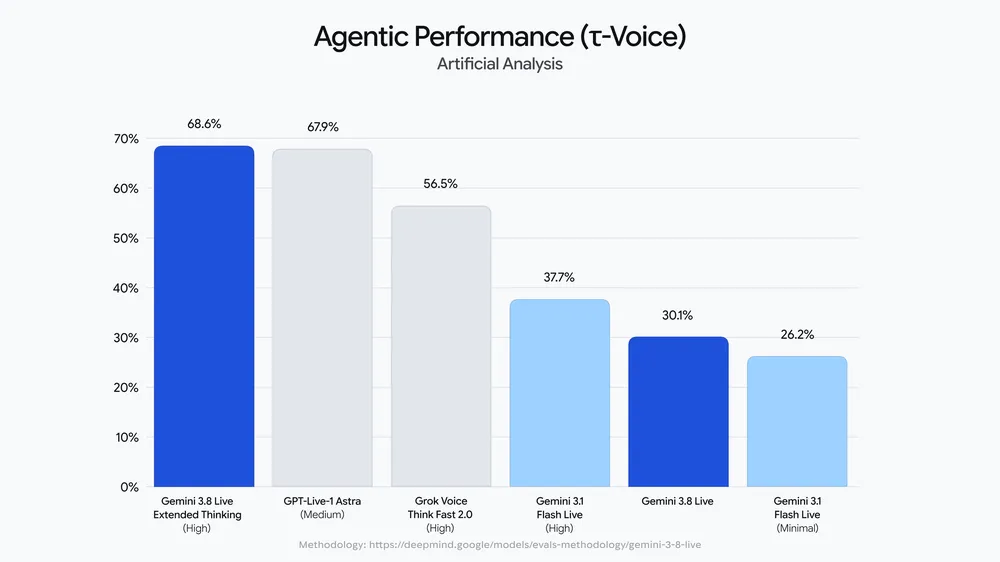
τ-Voice는 모델이 대화하면서 도구를 호출해 요청을 실제로 끝내는지 재는 벤치마크입니다. 여기서 gemini-3.8-live는 30.1%로, 전작 High 설정의 37.7%보다 7.6%포인트 낮습니다. 종합 지수를 끌어올린 모델이 정작 일을 끝내는 항목에서는 뒷걸음쳤습니다.
지수가 이 퇴행을 가린 것은 계산 방식 때문입니다. Speech to Speech Index는 음성 추론(Big Bench Audio), 에이전트 성능(τ-Voice), Arena 선호도, 과제 성공률 네 항목을 동일 가중으로 평균합니다. 한 항목이 내려가도 나머지 셋이 올라가면 종합 점수는 올라갑니다.
도구를 쓰는 능력은 값비싼 쪽에 몰려 있습니다. gemini-3.8-live-extended-thinking은 τ-Voice 68.6%로 OpenAI GPT-Live-1 Astra(Medium) 67.9%와 xAI Grok Voice Think Fast 2.0(High) 56.5%를 앞섭니다. 종합 지수도 82.6%로 1위이고, 음성 추론 Big Bench Audio에서는 97.7%입니다.
| 모델 | S2S 지수 | τ-Voice | 첫 소리 | 시간당 |
|---|---|---|---|---|
| 3.8 Live Extended Thinking | 82.6% | 68.6% | 1.35초 | 3.50달러 |
| 3.8 Live | 76.0% | 30.1% | 1.18초 | 0.84달러 |
| 3.1 Flash Live (High, 전작) | 71.5% | 37.7% | 2.99초 | 1.75달러 |
| GPT-Live-1 Astra (Medium) | 81.5% | 67.9% | 1.34초 | 5.83달러 |
| Grok Voice Think Fast 2.0 (High) | 81.3% | 56.5% | 0.70초 | 4.80달러 |
지수와 τ-Voice 수치는 구글 발표문 차트, 지연과 시간당 비용은 Artificial Analysis 집계입니다.
두 모델 중 무엇을 고르나
모델 선택은 도구 호출이 대화에 섞이느냐로 갈립니다. 안내와 문답만 하는 상담 봇이라면 gemini-3.8-live가 시간당 0.84달러에 1.18초로 답합니다. 같은 일을 GPT-Live-1 Astra로 하면 시간당 5.83달러이니 구글 쪽이 7분의 1 값입니다. 반면 예약을 잡거나 주문을 넣는 것처럼 모델이 도구를 호출해 일을 끝내야 하면 τ-Voice 30.1%짜리로는 열 번 중 일곱 번을 못 끝냅니다. 그 경우 시간당 3.50달러인 Extended Thinking을 써야 합니다. 값은 4배가 됩니다.
유료 등급 가격은 100만 토큰 기준으로 이렇습니다. 오디오 입력 3달러(분당 0.005달러), 오디오 출력 12달러(분당 0.018달러). 텍스트는 입력 0.75달러, 출력 4.50달러인데 이 텍스트 단가에는 2026년 12월 31일까지라는 기한이 붙어 있습니다. 2027년 1월 1일부터 각각 1.50달러와 9달러로 두 배가 됩니다. 도입 가격에 종료일을 미리 박아 두는 방식은 Gemini 3.8 Flash 때도 같았습니다.
무료 등급에서는 텍스트와 오디오 입출력이 모두 무료입니다. 대신 무료 등급 데이터는 구글이 제품 개선에 씁니다. 유료 등급은 그 대상에서 빠집니다. 프로토타입은 무료로 돌리더라도 실제 고객 음성이 들어가기 시작하면 유료로 올려야 합니다.
옮길 때 조용히 깨지는 것
전작에서 옮기는 일은 모델 문자열 한 줄로 끝나지 않습니다. 구글이 모델 문서에 적은 변경 가운데는 오류 없이 동작만 달라지는 것도 있습니다.
- 비동기 함수 호출이 기본값이 됐습니다. 전작에서는 도구 결과를 기다렸다가 말했는데, 이제는 기다리지 않고 말을 이어갑니다. 예전 동작을 유지하려면
behavior: BLOCKING을 명시해야 합니다. 스케줄링 모드는SILENT,WHEN_IDLE,INTERRUPTED세 가지입니다. - Extended Thinking에서는
turnComplete: true가 더 이상 대화 차례의 끝이 아닙니다. 배경 추론이 돌고 있으면 이 값이 참이어도 세션은 작업 중입니다.interaction_status가IN_PROGRESS인지IDLE인지를 봐야 합니다. 이 모델은 차단형 함수 호출 자체를 지원하지 않습니다. gemini-3.8-live는thinking_level과thinking_config를 받지 않습니다. 전작 설정을 그대로 두면 세션 설정 단계에서 걸립니다. Extended Thinking 쪽은thinking_config에 low, medium, high를 받고 MINIMAL은 지원하지 않습니다.- 3.8 Live 모델 문서의 마이그레이션 항목은 감정 대화(affective dialogue)가 API에서 빠졌다고 적고 있습니다. 프로액티브 오디오는 끌 수 없이 켜져 있습니다.
- 캐싱, 코드 실행, 파일 검색, 구조화 출력, URL 컨텍스트, Google Maps 그라운딩, Batch API는 두 모델 모두 지원하지 않습니다. 컨텍스트는 입력 131,072 토큰, 출력 65,536 토큰입니다.
세션 길이 제한도 그대로입니다. 오디오만 쓰면 15분, 영상까지 넣으면 2분입니다. 그보다 긴 통화를 받으려면 세션을 이어 붙이는 코드를 직접 짜야 합니다.
지금 쓸 수 있나
API 키만 있으면 오늘 됩니다. 대기자 명단도 신청 절차도 없습니다.
| 항목 | 조건 |
|---|---|
| 개발자 | Gemini API와 Google AI Studio에서 바로 사용 |
| 기업 | Gemini Enterprise는 비공개 프리뷰 |
| 일반 사용자 | Search Live, Gemini 앱, Workspace(Docs·Gmail·Keep) |
| 한국 | 사용 가능. Live API 언어 표에 한국어( |
| 필요 조건 | API 키. 무료 등급은 텍스트·오디오 무료 |
한국 관련해서 한 가지는 확인하지 못했습니다. Vertex AI에서 서울 리전(asia-northeast3) 데이터 레지던시를 지원하는지는 1차 소스에 나와 있지 않습니다. 국내 데이터 보관 요건이 있는 서비스라면 이 부분을 구글 영업에 직접 물어봐야 합니다. 생성 오디오에는 SynthID 워터마크가 들어갑니다.
이미 gemini-3.1-flash-live-preview로 음성 에이전트를 돌리는 팀이라면, 모델 문자열만 바꿔 배포하기 전에 도구 호출이 들어가는 대화 시나리오 한 벌을 두 모델로 각각 돌려 과제 완료율을 재보면 됩니다. 구글 차트대로라면 도구 비중이 높은 대화에서 gemini-3.8-live는 전작보다 덜 끝냅니다. 그 차이가 실제로 나온다면 선택지는 값이 4배인 Extended Thinking이거나, 텍스트 단가가 두 배로 오르는 2027년 1월 1일 전에 다른 제공사와 비용을 다시 견줘 보는 것입니다.