입력 100만 토큰 0.042달러 TypeSafe Jev, 정확도는 GPT-5.6 Luna와 같은 67%대
TypeSafe가 글 대신 선택지와 확률만 돌려주는 모델 Jev를 공개했습니다. 입력 100만 토큰 0.042달러에 출력은 무료지만, 자사 평가 정확도는 GPT-5.6 Luna와 비슷한 67%대로 Sol보다 약 6점 낮고 대기자 명단으로만 열립니다.
- Jev는 글을 쓰지 않고 판정과 확률만 내며, 출력 토큰은 무료입니다.
- 자사 평가 정확도는 Luna와 같은 67%대, Sol보다 약 6점 낮습니다.
- 환각 0%는 형식 오류가 없다는 뜻이고, 지금은 대기자 명단뿐입니다.
9월 15일 TypeSafe AI가 첫 공개 모델 Jev를 발표했고 발표 글은 몇 시간 만에 Hacker News 1위(305점)에 올랐습니다. 같은 날 Every의 평가 담당자들이 직접 써본 리뷰도 나왔습니다.
Jev는 문장을 쓰지 않는 모델입니다. "이 문의는 결제팀·기술팀·영업팀 중 어디로 보낼까", "이 고객은 얼마나 화가 났나" 같은 질문을 미리 정해 두고 텍스트를 넣으면, 답을 글로 풀어 쓰는 대신 고른 선택지와 선택지별 확률만 돌려줍니다. TypeSafe는 이런 모델을 "System One 모델"이라고 부릅니다.
LLM으로 판정하던 호출과 무엇이 다른가
지금은 분류나 품질 판정도 대개 LLM에게 맡깁니다. LLM은 토큰을 하나씩 생성하기 때문에 {"department": "technical"} 같은 짧은 답도 글자 단위로 만들어 냅니다. 출력 토큰 요금도 따로 내야 하고, 형식이 깨지면 다시 호출해야 합니다.
Jev는 질문 세 종류만 받습니다.
- Choice: 정해진 선택지 중 하나를 고르고, 선택지마다 확률을 붙입니다.
- Score: 순서가 있는 등급(예: 차분함, 짜증, 격분) 중 어디쯤인지 점수와 확률을 냅니다.
- Noul: 예/아니오 질문에 "예"일 확률을 냅니다.
TypeSafe는 모든 답을 한 번의 계산으로 동시에 만든다고 설명합니다. 공식 퀵스타트 예제를 줄이면 이렇습니다.
from typesafe_sdk import Choice, Noul, TypeSafeClient

client = TypeSafeClient()
response = client.system_one(
    state="Stripe 계정 연동이 3일째 안 됩니다...",
    questions={
        "department": Choice(
            instructions="어느 팀이 처리해야 하나",
            criteria={"billing": "결제 문제", "technical": "버그·연동 문제", "sales": "요금 문의"},
        ),
        "is_urgent": Noul(instructions="급한 요청인가"),
    },
)
# {"department": {"choice": "technical", "confidence": 0.596}, "is_urgent": {"noul": 0.999}}
속도와 비용에서 나아진 점은 분명합니다. TypeSafe 블로그는 호출 하나가 70~500ms에 끝나고 같은 작업을 LLM으로 돌리면 3초에서 329초가 걸린다고 적었습니다. 가격은 입력 100만 토큰 0.042달러이고 출력 토큰 요금은 받지 않습니다. 답이 숫자 몇 개뿐이라 따로 셀 가치가 없다는 이유입니다.
| 모델 | 입력 (100만 토큰) | 출력 (100만 토큰) | Jev보다 비싼 입력 단가 |
|---|---|---|---|
| TypeSafe Jev | 0.042달러 | 무료 | 기준 |
| GPT-5.6 Luna | 0.20달러 | 1.20달러 | 약 4.8배 |
| GPT-5.6 Terra | 2달러 | 12달러 | 약 48배 |
| Claude Fable 5.1 | 10달러 | 50달러 | 약 238배 |
홈페이지의 "Fable 5.1보다 238배 싸다"는 입력 단가끼리 나눈 값입니다(10달러 ÷ 0.042달러). 판정 작업에 흔히 쓰는 저가 모델과 비교하면 차이가 훨씬 줄어듭니다. Jev의 입력 단가는 7월 30일 80% 인하된 GPT-5.6 Luna보다 약 4.8배 쌉니다.
자사 차트에서도 정확도는 Luna 수준
비용은 크게 내려가지만 정확도가 오르지는 않습니다. TypeSafe가 블로그에 올린 차트에도 그대로 나옵니다. 네 가지 업무 워크플로의 평균 정확도를 세로축에, 워크플로 한 번의 비용을 가로축(로그 눈금)에 놓았습니다.
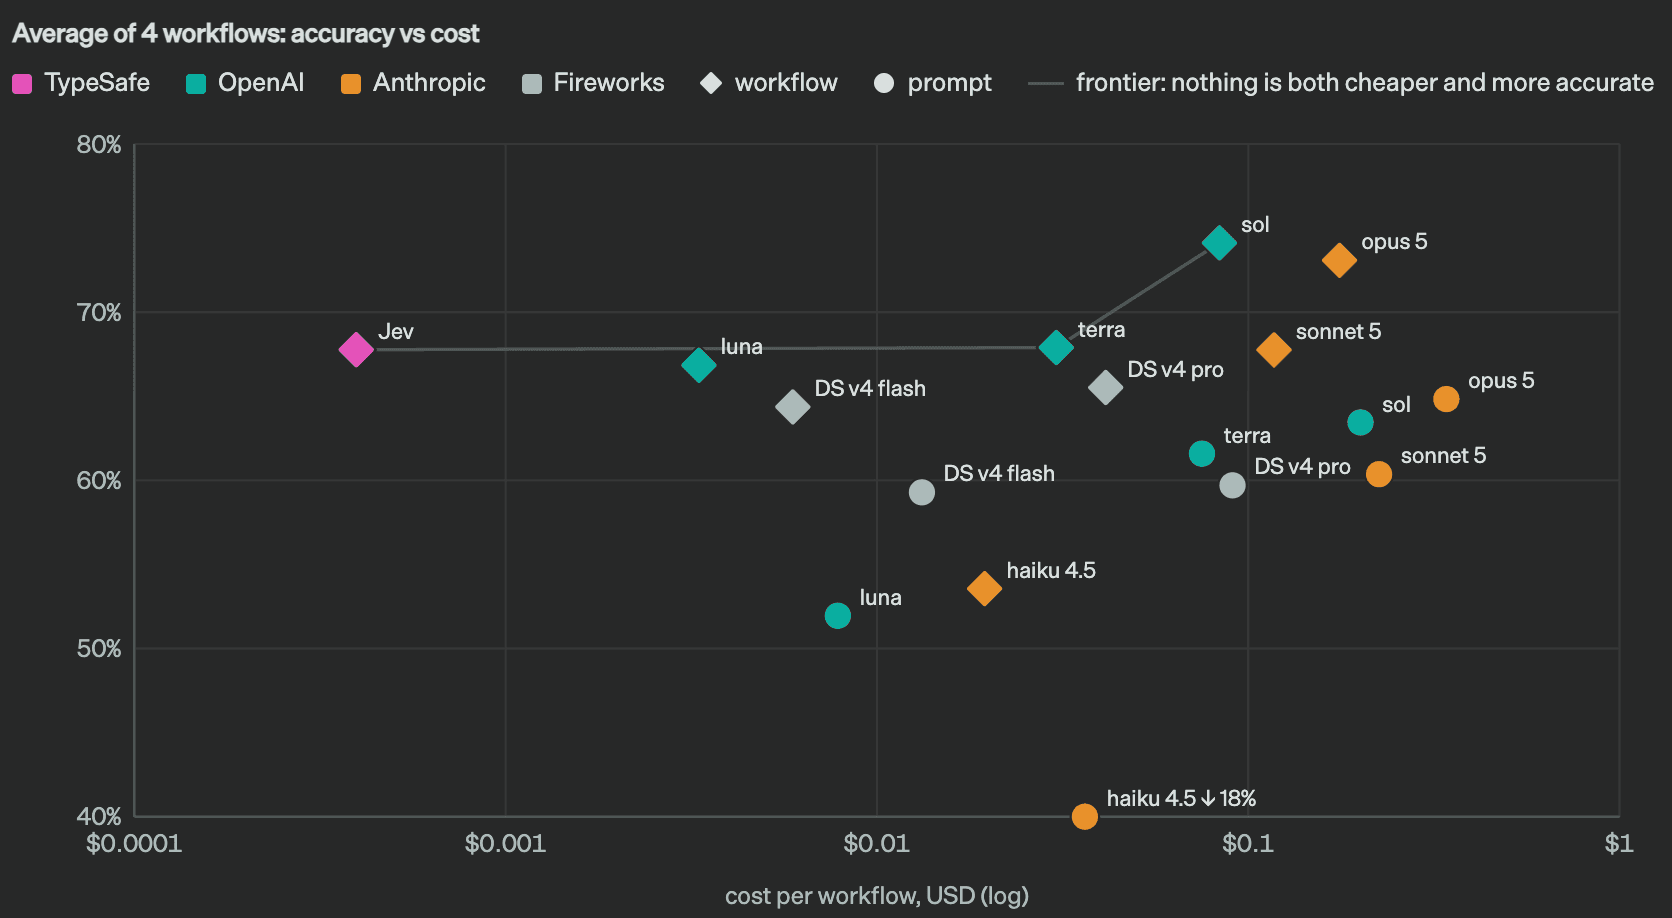
차트 눈금으로 읽은 근사치입니다.
| 모델 (워크플로 방식) | 평균 정확도 | 워크플로당 비용 |
|---|---|---|
| Jev | 약 68% | 약 0.0004달러 |
| GPT-5.6 Luna | 약 67% | 약 0.0035달러 |
| GPT-5.6 Terra | 약 68% | 약 0.03달러 |
| GPT-5.6 Sol | 약 74% | 약 0.085달러 |
| Claude Opus 5 | 약 73% | 약 0.17달러 |
Jev는 Luna와 정확도가 거의 같고 비용은 약 9분의 1입니다. 정확도가 6점 더 필요하면 여전히 Sol이나 Opus 5를 써야 합니다. 홈페이지의 444.6배라는 수치도 이 차트의 LLM들과 비교한 값입니다. 블로그는 이 수치가 "실제 업무에서 얻는 이득보다 높은 쪽일 것"이라고 스스로 적었습니다.
차트에서 Jev보다 눈에 띄는 숫자가 하나 더 있습니다. 같은 LLM이라도 긴 프롬프트 하나로 판정하게 한 경우("prompt")와 질문을 잘게 쪼갠 워크플로로 돌린 경우는 점수가 크게 다릅니다. Luna는 약 52%에서 67%로 15점 올랐고 Sol도 약 63.5%에서 74%로 올랐습니다. Jev를 쓰지 않고 질문 설계만 바꿔도 정확도가 꽤 오릅니다.
TypeSafe는 평가 조건의 한계도 직접 밝혔습니다.
- 정답 기준을 GPT-6 Astra와 Fable 5.1의 답에서 가져와 OpenAI·Anthropic 모델 쪽으로 기울어 있습니다.
- 워크플로 네 개를 자사 모델 팀이 만들었고 입력이 짧아 Jev에 유리합니다.
- 지연 시간은 미국 서부의 노트북에서 쟀고, 공개 벤치마크 점수는 일부러 싣지 않았습니다(창업자 HN 답변).
외부에서 검증한 자료는 Every 리뷰 하나뿐입니다. Every가 합성 문단 12개로 글쓰기 결함을 찾게 했더니 Jev는 중앙값 0.35초에 결함 7개 중 6개를 잡았고 Fable 5.1은 8.83초에 7개를 모두 잡았습니다. Jev의 비용은 Fable 5.1의 약 580분의 1이었습니다. 다만 Jev가 놓친 결함 하나는 세 번 돌려도 매번 놓쳤습니다.
"환각 0%"가 막는 것과 못 막는 것
TypeSafe는 Jev가 환각을 일으킬 수 없다고 홍보합니다. 여기서 막는 것은 형식 오류입니다. 정해진 선택지 밖의 값이나 깨진 JSON은 구조상 나오지 않습니다.
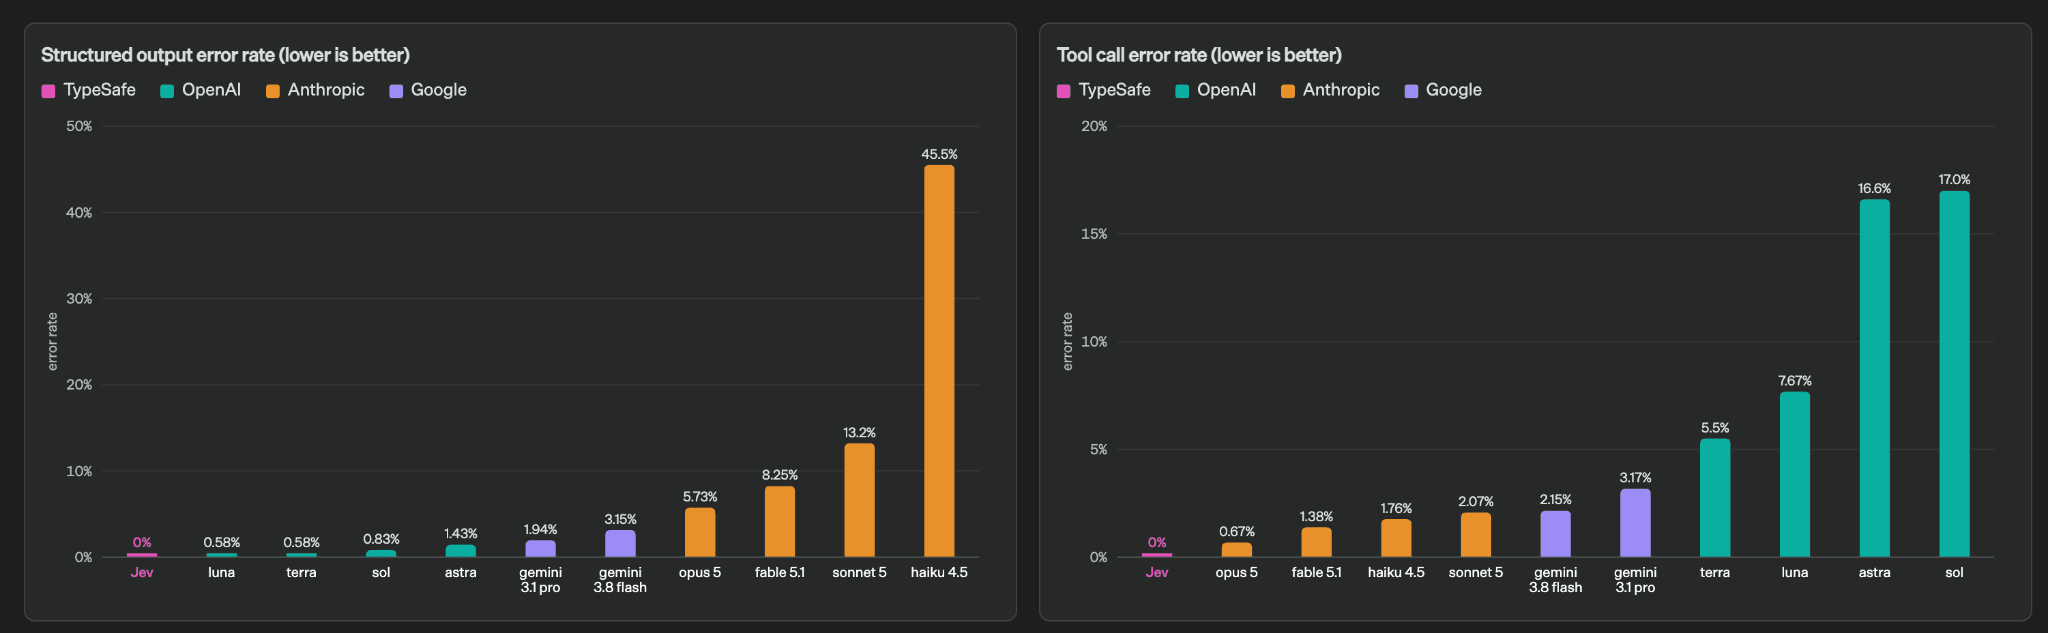
LLM 쪽 수치는 OpenRouter에서 모은 데이터입니다. 구조화 출력 오류율은 Luna·Terra가 0.58%, Fable 5.1이 8.25%, Haiku 4.5가 45.5%입니다. 도구 호출 오류율은 Opus 5가 0.67%로 가장 낮고 Sol이 17.0%로 가장 높습니다. 같은 모델이라도 호스트마다 도구 호출 점수가 다르다는 사실은 OpenRouter 호스트별 30점 차 실측에서 다뤘습니다.
틀린 선택지를 고르는 문제는 그대로 남습니다. HN에서 "형식은 못 틀려도 완전히 틀린 유효한 값은 낼 수 있다"는 지적이 나오자, TypeSafe CEO 계정은 확신한 채로 틀릴 수도 있다고 인정했습니다. "그냥 분류기 아니냐"는 질문에도 정확히 맞다고 답했습니다.
그래서 TypeSafe 문서는 답마다 함께 오는 confidence(0에서 1 사이 신뢰도) 값에 따라 처리 경로를 나누라고 권합니다. 문서 예시는 0.5 미만을 사람에게 넘기고, 삭제처럼 되돌리기 어려운 작업은 0.9를 넘을 때만 자동으로 실행합니다. 다만 이 신뢰도가 실제 정답률과 얼마나 맞는지 보여주는 보정 지표는 공개하지 않았습니다.
못 하는 일도 정해져 있습니다. 문장을 생성하지 못하고 이미지 입력도 받지 않습니다. 선택지는 최대 255개입니다. 코딩 작업은 아직 시도하지 않았다고 창업자가 밝혔습니다. 한국어 입력의 정확도를 다룬 자료는 문서와 블로그 어디에도 없습니다.
지금 쓸 수 있나
오늘 누구나 가입해서 쓸 수 있는 상태는 아닙니다. 조기 접근 대기자 명단에 이름을 올려야 합니다. 창업자는 HN에서 "첫 묶음을 명단에서 풀고 있다"고만 적었습니다.
| 항목 | 내용 |
|---|---|
| 대상 | 개발자 전용. HTTP API(POST /v1/systemone, 모델 jev-latest), Python·JavaScript SDK |
| 가격 | 입력 100만 토큰 0.042달러, 출력 무료. 무료 크레딧 안내 없음 |
| 필요 조건 | 조기 접근 대기자 명단 승인 후 콘솔에서 API 키 발급. Python SDK는 3.10 이상 |
| 한국 사용 | 미정. 9월 14일 개정 약관은 미국 내 방문자를 대상으로 하며 미국 밖에서 이용하기에 적합한지는 보장하지 않는다고 적었습니다. 국가별 금지 목록은 없고 서비스는 미국 서부에서 운영됩니다 |
| 입력 형식 | 텍스트·JSON만. 이미지 미지원, 한국어 성능 자료 없음 |
| 데이터 | 입력 데이터를 학습에 쓰는지 밝힌 약관 조항이 없습니다 |
직접 코딩하지 않는 실무자가 당장 쓸 수 있는 소식은 아닙니다. Jev는 앱이 아니라 API라서 사내 도구를 만드는 개발자가 연결해야 쓸 수 있습니다.
지원 티켓 분류나 LLM 판정 호출을 대량으로 돌리는 팀은 Jev 접근을 기다리는 동안 먼저 해볼 일이 있습니다. 긴 판정 프롬프트 하나를 선택지·등급·예/아니오 질문 몇 개로 쪼갠 뒤 정답을 달아 둔 샘플 100건으로 지금 쓰는 저가 모델의 정확도를 다시 재 보세요. TypeSafe 자사 차트에서 Luna는 질문을 쪼개는 것만으로 15점이 올랐으니 그 효과부터 확인할 수 있습니다. 명단이 풀리면 같은 질문과 같은 100건을 Jev에 그대로 보내 정확도와 비용을 나란히 비교하면 됩니다.