AI가 다른 AI 가중치 0.016% 고쳤더니 수학 6배…똑똑해진 건 아니었다
GPT-6 Astra가 학습 없이 Qwen3.5-0.8B 가중치 13만 개를 고쳐 MATH-500을 7.9%에서 48.1%로 올렸습니다. 공개 로그를 보면 끝나지 않던 추론 반복을 없앤 결과이고, AIME는 2.3%에 그쳤습니다.
- GPT-6 Astra가 학습 없이 Qwen 가중치 0.016%를 고쳐 수학 점수가 6배가 됐습니다.
- 공개 로그상 바뀐 것은 실력보다 끝나지 않던 추론 반복입니다.
- 수정 파일이 공개돼 오늘 같은 모델에 그대로 적용해 볼 수 있습니다.
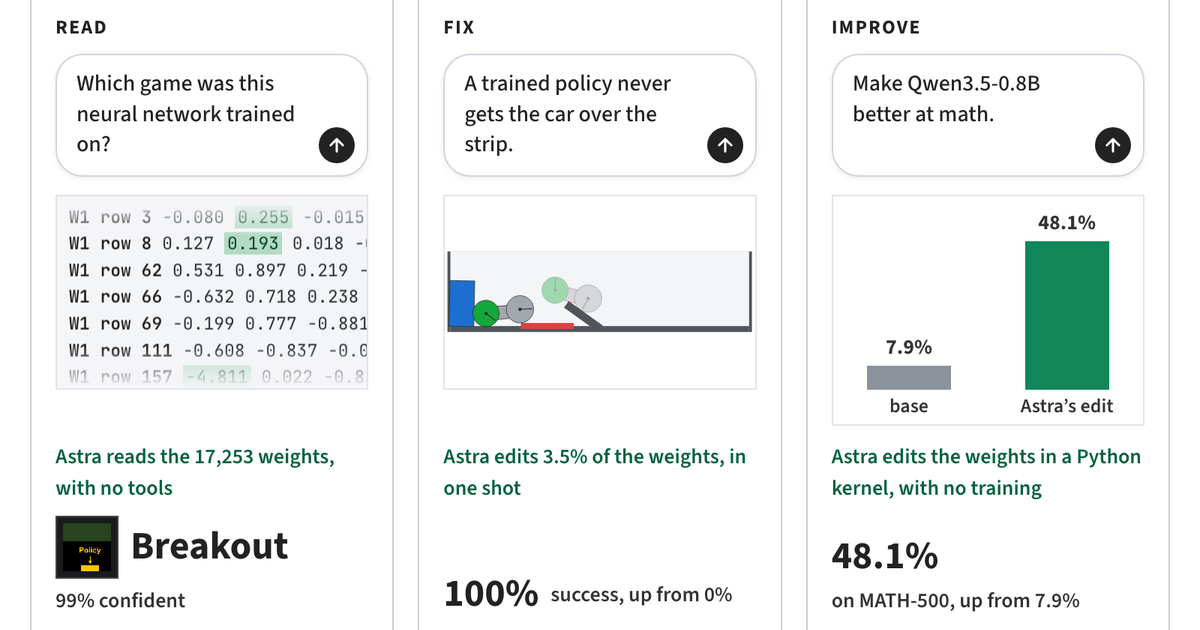
GPT-6 Astra가 학습 과정 없이 오픈 모델 Qwen3.5-0.8B의 가중치를 직접 고쳐 수학 점수를 6배로 끌어올린 사실이 드러났습니다. 벤치마크 MATH-500 점수는 7.9%에서 48.1%로 뛰었습니다. 고친 가중치는 전체 약 8억 개 중 131,072개(0.016%)입니다. MIT CSAIL 연구진이 11월 2일 공개한 글은 Hacker News에서 1,003점으로 1위에 올랐습니다.
가중치는 모델이 학습으로 얻은 숫자 뭉치입니다. 지금까지 이 숫자는 경사 하강법 같은 최적화 알고리즘이 정했고 사람이 읽고 고칠 대상이 아니었습니다. 연구진은 범용 LLM이 이 숫자를 직접 읽고 쓰는 방식을 Weight-Space Programming(가중치 공간 프로그래밍)이라고 부릅니다.
다만 연구진이 공개한 실험 로그를 열어 보면 6배라는 숫자가 주는 인상과 내용이 다릅니다. Astra는 Qwen에게 수학을 가르치지 않았습니다. 끝나지 않던 답을 끝나게 했습니다.
Astra가 해낸 일과 못 해낸 일
실험은 8개입니다. 작은 네트워크로 시작해 실제 언어 모델까지 커집니다. 실험마다 Astra에게는 도구를 끄거나 학습·경사 계산·모델 실행을 막는 제한이 걸렸습니다.
| 과제 | 대상 크기 | 결과 |
|---|---|---|
| 학습한 게임 맞히기 | 가중치 17,253개 | 4종 모두 정답 |
| 입출력층을 뺀 언어 모델의 언어 맞히기 | 716만 개 | 3종 모두 정답, 복사 담당 어텐션 헤드까지 식별 |
| 언덕을 못 넘는 자동차 정책 수정 | 171,664개 중 3.5% | 256회 전패에서 1,024회 전승 |
| Breakout 정책 처음부터 작성 | 학습 없이 한 번에 작성 | 517.4점, 5억 스텝 학습한 PPO는 25.3점 |
| 9×9 바둑 신경망 작성 | 148만 개 | 실행 예산 50회로 2,000만 게임 학습한 같은 크기 PPO에 승리 |
| 아부하는 모델 가려내기 | Gemma 3 270M | 가중치만으로는 4회 모두 실패, 어텐션 패턴을 보여주자 3쌍 성공 |
전부 대단해 보이지만 규모가 커질수록 Astra는 도구와 실행 예산에 기대게 됩니다. 가중치를 글자 그대로 프롬프트에 넣은 실험은 17만 개 규모까지입니다. 148만 개와 8억 개 모델은 파이썬 도구로 다뤘습니다.
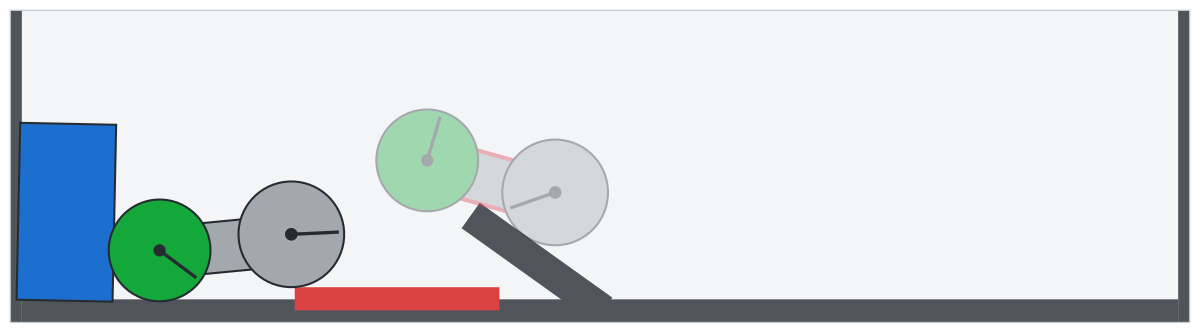
자동차 실험에서 Astra의 작업 방식이 잘 드러납니다. PPO 정책은 언덕으로 곧장 달리다 멈추는 데서 벗어나지 못했습니다. Astra는 차의 위치와 속도를 읽어 먼저 후진하게 만드는 작은 경로를 층마다 유닛 몇 개로 추가했습니다. 빨간 띠를 지나면 그 경로가 꺼지게 했습니다. 학습이 아니라 사람이 코드를 고치듯 동작을 설계했습니다.
6배는 답이 끝나기 시작한 결과입니다
Qwen3.5-0.8B의 문제는 수학 이전에 있었습니다. 추론 모드를 켜면 같은 문장을 되풀이하다 토큰 한도 32,768개에 걸려 답을 못 냅니다. MATH-500 답변의 93%가 이렇게 잘렸습니다. Qwen 모델 카드도 이 모델이 다른 Qwen3.5보다 추론 반복에 잘 빠진다고 경고합니다.
Astra는 15층과 19층의 MLP에서 이 반복을 만드는 방향 하나를 찾아 층마다 출력 열 64개에서 빼냈습니다. 로그에 남은 편집 수식은 한 줄입니다.
W = W0 - 6 * outer(u, mask64 * (u @ W0))
결정적인 숫자는 글 본문이 아니라 로그의 마지막 확인 결과에 있습니다. Astra가 편집을 고른 뒤, 고를 때 쓰지 않은 연습 문제 1,152개로 수정 전후를 비교한 값입니다.
끝까지 답하던 문제의 정답률은 한 칸도 움직이지 않았습니다. 늘어난 정답은 거의 전부(579개 중 576개) 원래 잘리던 답변에서 나왔습니다. 원래 풀 수 있던 문제를 끝까지 풀게 됐습니다. 답을 일찍 끊어 점수를 얻은 것도 아닙니다. 수정본의 정답 696개는 모두 추론을 정상적으로 닫았고 길이 중앙값은 9,172토큰이었습니다.
벤치마크 표에서도 같은 결과가 나옵니다. 잘림이 사라진 곳에서 점수가 뛰었고 어려운 문제는 그대로 어렵습니다.
| 벤치마크 | 수정 전 | 10회 | 25회 | 50회 |
|---|---|---|---|---|
| MATH-500 | 7.9 | 12.3 | 14.1 | 48.1 |
| GSM8K (초등 수준 문장제) | 13.8 | 25.7 | 25.1 | 67.1 |
| IFEval (지시 따르기) | 21.0 | 49.0 | 39.9 | 62.3 |
| MMLU-Pro (여러 분야 객관식) | 40.3 | 40.0 | 44.7 | 45.5 |
| AIME25 (경시대회) | 0.0 | 0.0 | 0.0 | 2.3 |
| MATH-500 토큰 한도 도달률 | 93.0 | 87.2 | 86.4 | 33.1 |
단위는 모두 %이고 10·25·50회는 Astra가 쓴 모델 실행 예산입니다. 잘림이 원래 드물던 MMLU-Pro(수정 전 28.9%)는 5.2포인트만 올랐습니다. Gemma 3 270M은 답변의 8.5%만 잘리는 모델인데, 같은 실험에서 Astra가 MATH-500을 6.8%에서 최대 7.7%로밖에 못 올렸습니다. 연구진도 편집은 가려진 능력을 드러낼 뿐 없는 능력을 더하지는 못했다고 썼습니다.
부수 효과는 실무에 더 가깝습니다. IFEval 평균 출력이 25,296토큰에서 4,241토큰으로 약 6분의 1이 됐습니다. 쓸모없는 반복이 사라진 만큼 추론 시간과 비용이 함께 줄어듭니다.
로그가 알려주는 한계
48.1%는 실행 한 번의 결과입니다. 공개 결과표를 보면 50회 예산으로 끝까지 평가된 실행은 이것뿐입니다. 재현성을 판단할 때 아래를 함께 봐야 합니다.
- 실행마다 다른 수정을 골랐습니다. 10회 실행은 행렬 30개에서 방향을 빼고 25회 실행은 어텐션 헤드 하나를 껐습니다. 예산이 늘면서 같은 수정이 다듬어진 것이 아닙니다. 25회의 IFEval(39.9%)은 10회(49.0%)보다 낮습니다.
- 빈손으로 끝난 실행도 있습니다. 표에 함께 남은 5회 예산 실행과 프롬프트를 바꾼 10회 실행은 수정본을 제출하지 않았습니다.
50회는 작은 숫자가 아닙니다. 1회는 최대 512문제를 생성하고 생성 1회에 약 30분까지 걸렸습니다. 50회 실행에는 158턴과 실제 경과 시간 20.3시간이 들었습니다. 경사 계산은 없지만 측정과 시행착오는 많습니다.- 비교군이 없습니다. Qwen 모델 카드는 반복을 줄이려면 샘플링을 조정하고 스트리밍으로 감지해 끊으라고 권합니다. 가중치 수정 대신 샘플링만 조정했을 때의 점수는 공개 결과표에 없습니다.
- 제3자 재현이 아직 없습니다. 피어리뷰 전 블로그 글입니다. HN에서 한 이용자는 소형 트랜스포머에 같은 시도를 해 학습한 가중치보다 훨씬 나쁜 결과(4.47bpb 대 2.53bpb)를 얻었다고 적었습니다. 다른 이용자는 작은 네트워크에서 AdamW보다 나았다고 적었습니다. 둘 다 개인 시도입니다.
연구진은 벤치마크와 실행 환경을 만들고 있다고 밝혔지만 그 코드는 이번 저장소에 없습니다. 수치 근거를 추적할 수 있도록 로그를 전부 공개한 점은 높게 평가합니다. 글 그림의 GPQA 수정 전 점수 24.5%가 중간값이고 최종값은 22.7%라는 정정까지 로그 문서에 적혀 있습니다.
같은 기법은 안전장치에도 듣습니다
이번 수정은 새 기법이 아닙니다. 연구진이 인용한 Arditi 외 2024년 논문은 오픈 모델 13종의 거부 응답이 활성값의 한 방향에 달려 있음을 보이고 그 방향을 지우는 랭크 1 가중치 편집을 탈옥 기법으로 제시했습니다. 달라진 것은 작업 주체입니다. 사람 연구자가 아니라 범용 LLM이 진단부터 검증까지 맡았습니다.
Astra가 안전장치를 제거했다는 뜻은 아닙니다. 이번 실험에 그런 시도는 없습니다. 그래도 파일 안 숫자 0.016%가 동작을 크게 바꿀 수 있다는 사실은 그대로 남습니다. 최근 공개된 사전 학습 데이터 오염 연구와 Mistral Large 4 가중치 공개까지 놓고 보면, 내려받은 가중치도 코드 의존성처럼 리비전과 해시를 고정해 관리할 이유가 하나 더 늘었습니다.
지금 써볼 수 있나
수정본은 누구나 적용할 수 있지만 같은 실험을 다시 돌리려면 Astra가 필요합니다.
| 항목 | 수정본 적용 | Astra로 재실험 |
|---|---|---|
| 대상 | 모델을 직접 돌리는 개발자 | OpenAI API 또는 Codex 사용자 |
| 가격 | 무료. Qwen은 Apache 2.0, 수정 파일은 CC BY 4.0, 스크립트는 MIT | 100만 토큰당 입력 10달러, 캐시 입력 1달러, 출력 50달러. 실험 비용은 미공개 |
| 한국 사용 | 공개 저장소에 지역 제한 표기 없음 | GPT-6 Astra 출시 글에서 확인한 대로 국가 제한 표기 없음 |
| 필요 조건 | Qwen 리비전 2fc0636 가중치, GPU, 저장소의 apply_edit.py | 전체 실행 환경 코드는 미공개, 프롬프트와 규칙만 공개 |
수정 파일(edit.npz)은 약 388KB입니다. 스크립트가 텐서별 해시를 검사해 평가에 쓴 모델을 비트 단위로 다시 만듭니다.
python exp8_math/code/apply_edit.py model.safetensors exp8_math/runs/p50c/edit edited.safetensors
소형 오픈 모델을 추론 모드로 돌리는 팀이라면 먼저 지난주 로그에서 답변이 토큰 한도로 잘린 비율을 세어 보면 됩니다. 그 비율이 높고 쓰는 모델이 Qwen3.5-0.8B라면, 이 수정본을 적용해 평소 프롬프트 100개를 수정 전후로 돌리고 잘림 비율과 정답률을 비교해 보세요. 벤치마크가 아니라 자기 프롬프트에서 같은 효과가 나는지가 도입을 가릅니다.