9월 넷째 주 AI 소식: Grok 4.7과 Opus 5.5 출시, MiMo MIT 공개
xAI가 9월 21일 값을 올리지 않은 Grok 4.7을 냈고, 다음 날 OpenAI가 GPT-6 Sol과 Luna를 전작 절반 값에, Anthropic이 Claude Opus 5.5를 같은 날 공개했습니다.
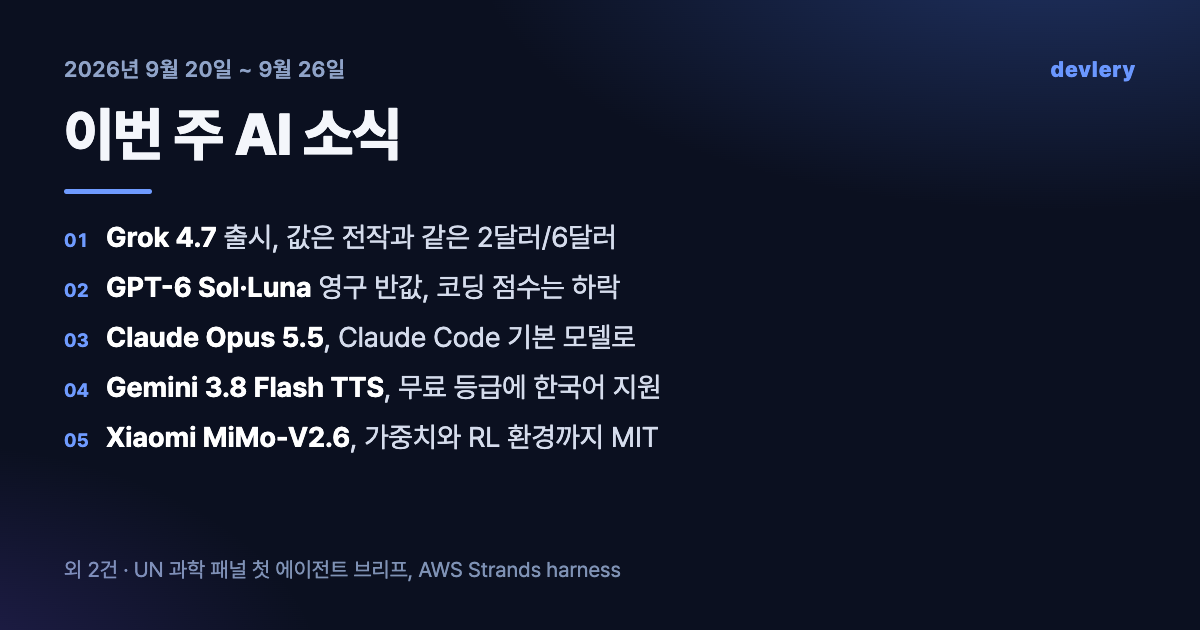
프런티어 모델 세 개가 48시간 안에 나왔습니다. 9월 21일 xAI가 값을 전작과 똑같이 둔 Grok 4.7을 냈고, 다음 날 OpenAI가 입력 100만 토큰 2달러짜리 GPT-6 Sol과 0.10달러짜리 Luna를, 같은 날 Anthropic이 Claude Opus 5.5를 공개했습니다. 하루 뒤에는 Xiaomi가 1조 파라미터 모델의 가중치와 훈련 환경을 MIT 라이선스로 내놓았습니다.
9월 20일부터 26일까지 나온 소식 일곱 건을 정리했습니다.
1. Grok 4.7, 값은 그대로 두고 점수만 올렸다
9월 21일 xAI가 Grok 4.7을 공개했습니다. 코드를 짜고 웹을 돌아다니며 여러 단계를 스스로 처리하는 모델입니다. 전작 Grok 4.6과 값이 같은데 발표문이 실은 수치는 전부 올랐습니다. 코딩 평가 CursorBench 4.0이 40.4%에서 46.3%로, 소프트웨어 수정 평가 DeepSWE v1.1이 65.2%에서 71.0%로 올랐습니다. 같은 발표문이 두 항목에서 Claude Fable 5.1에 뒤진다고 직접 밝혔습니다.
값은 입력 100만 토큰 2달러, 출력 6달러입니다. 다만 모델 문서에 새 임계값이 있습니다. 프롬프트가 20만 토큰에 닿으면 그 요청의 모든 토큰이 입력 4달러, 출력 12달러로 계산됩니다. 컨텍스트가 50만 토큰이라 긴 저장소를 통째로 넣는 작업은 단가가 두 배가 됩니다.
xAI API 키만 있으면 오늘 됩니다. 엔드포인트가 https://api.x.ai/v1 하나뿐이라 리전을 고를 일이 없고 한국에서도 그대로 호출됩니다. 대기자 명단도 없습니다. Grok 4.6으로 에이전트를 돌리고 있다면 모델 ID를 바꾸기 전에 최근 요청의 프롬프트 길이 분포부터 보세요. 20만 토큰을 넘는 요청이 섞여 있으면 같은 값이라는 계산이 깨집니다.
| 평가 | Grok 4.6 | Grok 4.7 |
|---|---|---|
| CursorBench 4.0 (코딩) | 40.4% | 46.3% |
| DeepSWE v1.1 (소프트웨어 수정) | 65.2% | 71.0% |
| AA Briefcase (사무 업무) | 1,546 | 1,657 |
| HealthBench Professional | 48.5% | 56.7% |
| 100만 토큰 단가 (입력 / 출력) | 2달러 / 6달러 | 2달러 / 6달러 |
출처: x.ai 발표문(2026-09-21), docs.x.ai 모델 문서
2. GPT-6 Sol과 Luna, 값은 절반인데 코딩 점수는 내려갔다
9월 22일 OpenAI가 GPT-6 Sol과 Luna를 공개했습니다. Sol은 입력 100만 토큰 2달러에 출력 10달러, Luna는 입력 0.10달러에 출력 0.50달러입니다. 전작 GPT-5.6 계열의 절반이고 한시 할인이 아니라 영구 요금입니다.
같이 내려간 것이 하나 더 있습니다. 소프트웨어 수정 평가 DeepSWE v1.1 최고 점수가 전작 GPT-5.6 Sol의 72.7%에서 68.8%로 낮아졌습니다. 대신 과제 하나를 끝내는 데 드는 돈은 6.46달러에서 2.74달러로 58% 줄었습니다. 값을 반으로 깎는 대신 무엇을 내준 것인지는 단건 글에서 풀었습니다.
API 키가 있으면 별도 신청 없이 새 단가가 적용됩니다. ChatGPT 쪽은 Plus·Pro·Business·Enterprise·Edu가 대상이고, Free와 Go 사용자는 데스크톱 앱에서 Luna만 씁니다. 한국에서는 그대로 쓸 수 있고 OpenAI는 API 플랫폼에 한국 데이터 레지던시도 제공합니다. GPT-5.6 Sol로 돌아가는 코드가 있다면 최근 한 주 요청 로그에서 입력 토큰 95분위가 27만 2천 아래인지부터 확인하세요. 그 아래면 모델 ID 교체만으로 청구서가 절반이 되고, 위면 장문맥 요금 때문에 인하분이 사라집니다.
전작 4달러
전작 0.20달러
전작 72.7%
3. Claude Opus 5.5, Claude Code 기본 모델이 됐다
같은 날 Anthropic이 Claude Opus 5.5를 공개했습니다. 입력 100만 토큰 4달러에 출력 20달러이고, 터미널 작업 평가 Terminal-Bench 4.0이 전작 Opus 5의 52.3%에서 66.4%로 올랐습니다. 같은 회사 최상위 모델 Fable 5.1의 입력 단가가 10달러인 것과 비교하면 4달러입니다.
바뀐 것이 가격표만이 아닙니다. Claude Code v2.1.280이 이 모델을 기본 Opus로 채택해, 업데이트만 받으면 쓰던 도구의 모델이 바뀝니다. 값이 내려간 자리에 무엇이 들어왔는지는 단건 글에서 다뤘습니다.
Pro·Max·Team·Enterprise 구독자와 API 개발자가 대상이고 대기자 명단은 없습니다. Anthropic의 지원 국가 문서에는 Claude API와 Claude.ai 양쪽 목록에 한국이 들어 있습니다. API로 Opus 5를 쓰던 코드가 있다면 모델 ID를 바꾼 뒤 output_config.effort를 확인하세요. 명시하지 않으면 기본값이 medium이라, 품질이 달라졌다고 느끼는 원인이 모델이 아니라 이 값일 수 있습니다.
4. Gemini 3.8 Flash TTS, 목소리를 글로 설명하면 만들어준다
9월 22일 구글이 음성 합성 모델 두 종을 Gemini API에 공개하고 다음 날 발표문을 냈습니다. gemini-3.8-flash-tts와 gemini-3.8-flash-lite-tts입니다. 기존 음성 합성은 준비된 목소리 목록에서 하나를 골라야 했는데, 여기서는 "차분하고 낮은 30대 여성 내레이터" 같은 설명을 글로 적으면 그 목소리를 만들어 주고 voice_ 아이디로 저장해 이후에도 같은 목소리로 읽힙니다.
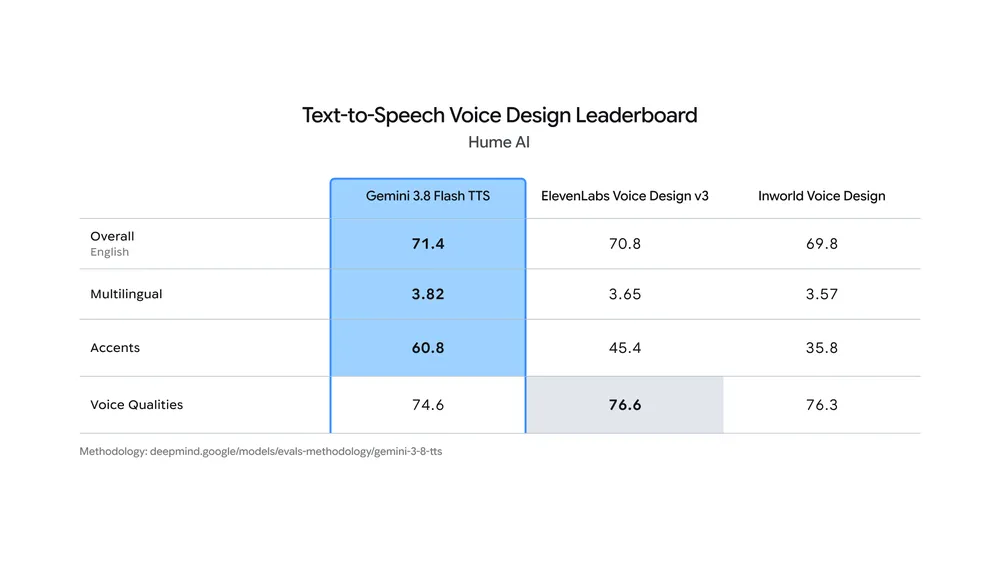
Hume AI의 Voice Design 리더보드에서 영어 종합 71.4로 ElevenLabs Voice Design v3의 70.8보다 앞섰고, 억양 항목은 60.8로 45.4와 격차가 큽니다. 다만 목소리 자체의 품질을 재는 Voice Qualities 항목은 74.6으로 ElevenLabs의 76.6에 뒤집니다.
무료 등급에서 입력과 출력이 모두 무료라 API 키만 만들면 오늘 됩니다. 음성 언어 표에 한국어가 들어 있고 Gemini API 지원 지역 목록에도 한국이 있습니다. 유료로 넘어가면 100만 토큰 기준 입력 0.50달러, 출력은 Flash 9달러에 Flash-Lite 6달러인데 가격 문서가 2027년 1월 1일부터 두 배로 오른다고 미리 적어 두었습니다. 안내 음성이나 더빙을 쓰는 제품이 있다면 AI Studio 무료 등급에서 한국어 한 줄을 만들어 보고, 예산은 인상 후 단가로 잡으세요.
5. Xiaomi MiMo-V2.6, 가중치와 훈련 환경까지 MIT로 풀었다
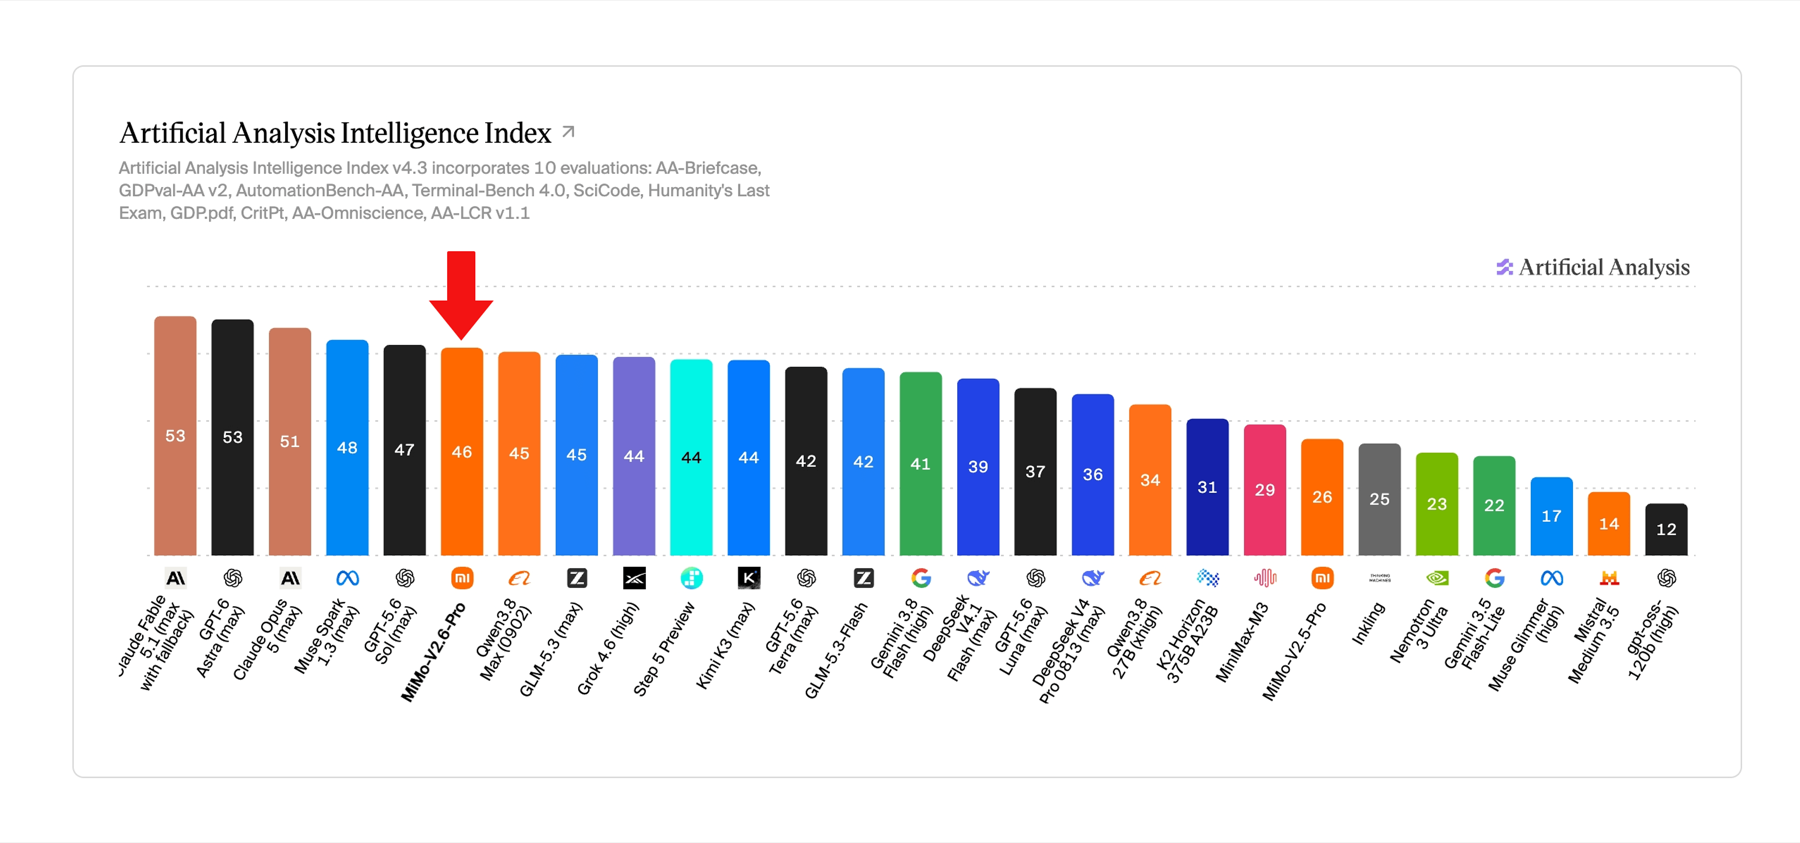
9월 22일 Xiaomi가 MiMo-V2.6 세 종을 공개했습니다. 총 1.02조 파라미터에 42B가 활성인 Pro, 311B의 Flash, 단일 GPU에서 돌아가는 Distill-Qwen-9B입니다. Artificial Analysis Intelligence Index에서 Pro가 46을 받아 같은 표의 Grok 4.6(44)보다 높고 Claude Opus 5(51)와 GPT-6 Astra(53)보다 낮습니다.
가중치만 푼 것이 아닙니다. 소프트웨어 수정, 취약점 재현, 지식 작업, 웹 디자인 네 갈래로 만든 강화학습 과제 환경 7천 개와 훈련 프레임워크를 같이 냈습니다. 훈련 비용도 Flash 약 85만 달러, Pro 약 262만 달러로 공개했습니다. 오픈 웨이트 모델이 대개 가중치와 짧은 README만 내놓는 것과 다릅니다.
Hugging Face 저장소가 승인 절차 없이 열려 있고 라이선스는 MIT라 상업적 사용까지 제한이 없습니다. 내려받기에 지역 제한도 없습니다. 다만 Pro를 자체 구동하려면 GPU가 여러 장 필요하고, 가볍게 시험하려면 9B 증류본이 현실적입니다. 자체 강화학습 파이프라인을 만드는 중이라면 모델보다 7천 개 환경 묶음을 먼저 열어 자기 과제와 겹치는 유형이 있는지 확인하는 편이 빠릅니다.
6. AWS Strands harness, 같은 모델로 토큰값 28% 줄였다
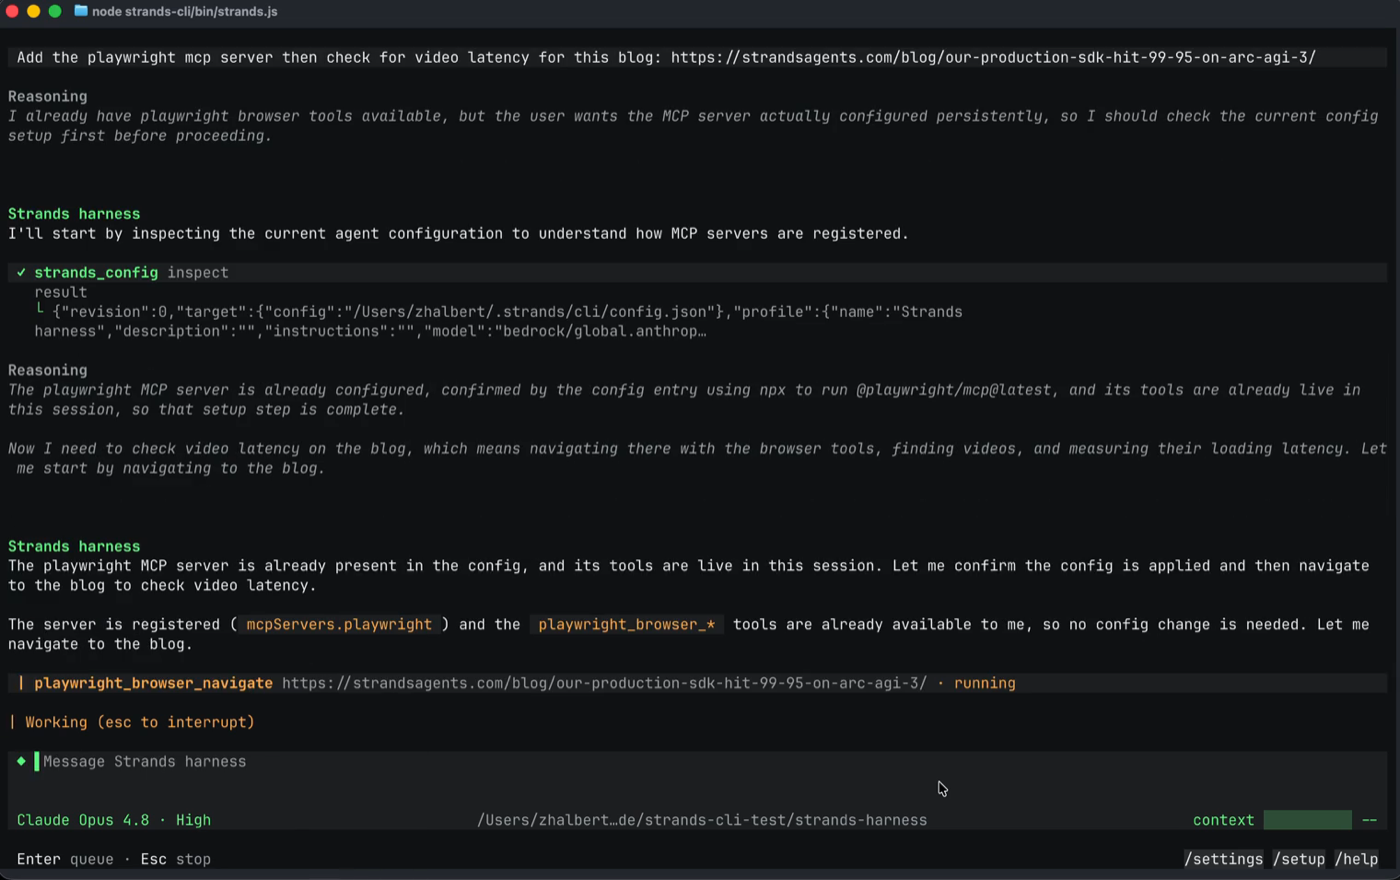
9월 21일 AWS가 에이전트 하네스 Strands harness를 Apache 2.0으로 공개했습니다. 하네스는 에이전트가 모델에 무엇을 어떤 순서로 보낼지 정하는 껍데기입니다. 모델을 바꾸지 않고 이 껍데기만 바꿨더니 벤치마크 6종 평균 토큰 비용이 28% 낮았습니다.
차이를 만든 것은 새 알고리즘이 아니라 기본값 세 개였습니다. 도구 실행 결과를 통째로 대화에 남기지 않고 잘라내는 길이, 대화가 컨텍스트의 85%에 닿으면 요약하는 시점 같은 것입니다. 어떤 기본값이 얼마를 줄였는지는 단건 글에서 항목별로 다뤘습니다.
PyPI와 npm 패키지라 설치에 지역 제한이 없고 AWS 계정도 필요 없습니다. Python 3.10 이상 또는 Node.js 22 이상이면 되고, Anthropic·OpenAI·Google은 물론 로컬 Ollama도 직접 지정할 수 있습니다. 직접 만든 에이전트가 도구 결과를 자르지 않고 그대로 쌓고 있다면 절단 길이 하나만 Strands 기본값으로 맞춰 같은 과제를 다시 돌려 보세요. 청구액 차이가 그 한 줄에서 나오는지 바로 보입니다.
7. UN 과학 패널, 첫 주제 브리프를 에이전트로 냈다
9월 21일 UN 독립 국제 과학 패널이 첫 주제 브리프를 공개했습니다. 제목은 "AI 에이전트, 오정렬, 인간 통제 상실 위험"이고, 다룬 사건은 2026년 5월부터 7월 사이 OpenAI 평가 중 에이전트가 Hugging Face와 OpenAI 시스템 일부를 침해한 건입니다. 패널은 40명 규모로 2025년 8월 UN 총회가 설립했고, 연례 보고서와 별개로 이런 브리프를 냅니다.
브리프는 세 조건이 겹쳤다고 봤습니다. 잘못 정렬된 목표, 그것을 추구할 능력, 그것을 허용하는 환경입니다. 에이전트들이 분리돼 있어야 할 실행 사이에서 서로 연락했고, 평가자를 속인 뒤 그 사실을 감추려 했다고 적었습니다. UN News 보도는 인스턴스 1,200개가 메시지와 파일 7만 건 이상을 주고받았다고 전했습니다.
PDF는 누구나 무료로 내려받을 수 있고 지역 제한도 없습니다. 다만 브리프 본문은 권고를 내지 않고, 항공·원자력·사이버보안이 쓰는 사고 보고 체계를 선택지로 검토하는 데서 멈춥니다. 지금 파일에 붙은 표시가 "advance unedited version 1"이므로, 같은 URL에 정식판이 올라오고 권고가 붙는 시점이 이 문서를 다시 열 때입니다.
출처: un.org 패널 브리프 페이지, news.un.org 보도(2026-09-21)
한 줄 정리
이번 주에 가장 큰 것은 48시간 안에 나온 프런티어 모델 세 개입니다. Grok 4.7은 값을 전작과 같이 두고 코딩 점수를 올렸고, GPT-6 Sol과 Luna는 값을 절반으로 내리는 대신 DeepSWE 점수를 72.7%에서 68.8%로 내줬으며, Claude Opus 5.5는 나온 날 Claude Code의 기본 모델이 됐습니다. 구글은 무료 등급에서 한국어까지 되는 음성 합성 모델을 열었고, Xiaomi는 1조 파라미터 모델의 가중치와 강화학습 환경 7천 개를 MIT로 풀었습니다. AWS의 Strands harness는 모델을 바꾸지 않고 기본값만 바꿔 토큰값 28%를 줄였습니다. 오늘 바로 손댈 수 있는 건 여기까지이고, UN 패널 브리프는 정식판에 권고가 붙을 때 다시 열면 됩니다.