27B 모델을 5.9GB로 압축한 Bonsai 2, SWE-bench는 80.6에서 60.8로
PrismML이 9월 17일 Qwen3.8 27B를 5.9GB로 줄인 Ternary Bonsai 2 27B를 Apache 2.0으로 공개했습니다. 벤치마크 20종 평균은 98.2%를 유지하지만 장시간 코딩 과제 점수는 4분의 3으로 내려갑니다.
- PrismML이 27B 모델을 5.9GB로 줄여 Apache 2.0으로 풀었습니다.
- 평균 98.2% 유지지만 SWE-bench는 80.6에서 60.8로 내려갑니다.
- 기본
llama.cpp와 Ollama로는 실행되지 않습니다.
노트북에서 큰 모델을 돌리려면 보통 두 가지를 포기해야 했습니다. 모델 크기를 줄이거나, 줄인 만큼 답변 품질이 떨어지는 것을 받아들이거나입니다. 캘리포니아 패서디나의 PrismML이 9월 17일 공개한 Ternary Bonsai 2 27B는 그 교환 비율을 다시 계산한 결과물입니다. Alibaba의 오픈 웨이트 모델 Qwen3.8 27B를 원본 53.8GB에서 5.9GB로, 약 9.3배 줄였습니다. 라이선스는 Apache 2.0이고 Hugging Face에서 누구나 무료로 내려받습니다.
발표문이 내세운 숫자는 98.2%입니다. 벤치마크 20종 평균 점수가 원본 85.4점에서 83.9점으로만 떨어졌다는 뜻입니다. Hacker News에서는 공개 당일 557점과 댓글 185개가 쌓였습니다. 다만 그 평균을 항목별로 뜯어보면, 어떤 작업을 맡길 생각이냐에 따라 답이 갈립니다.
전작보다 나아진 것과 이번에 빠진 것
PrismML은 7월 14일에 이미 1세대 Bonsai 27B를 냈습니다. 그때는 Qwen3.6 27B를 베이스로 써서 원본 대비 94.6%를 유지했습니다. 이번 2세대는 베이스를 Qwen3.8 27B로 바꾸고 유지율을 98.2%로 올렸습니다. 파일 크기는 그대로 두고 안에 담긴 모델만 더 좋아졌습니다.
압축 방식은 가중치 하나를 -1, 0, +1 세 값 중 하나로만 저장하는 삼진(ternary) 방식입니다. 보통 모델은 가중치 하나에 16비트를 쓰는데, 세 값만 쓰면 이론상 1.6비트면 됩니다. 여기에 그룹 단위 배율값을 FP16으로 따로 붙여 실제로는 가중치당 1.75비트가 들었습니다. 파일은 두 가지로 나옵니다.
| 포맷 | 크기 | 가중치당 비트 |
|---|---|---|
| PTQ1_0 | 5.95GB | 1.75비트 |
| PQ2_0 | 7.21GB | 2.13비트 |
| FP16 원본 | 53.8GB | 16비트 |
1세대에 있던 빌드 하나가 이번에는 없습니다. 7월 릴리스는 삼진 5.9GB 빌드와 함께 가중치를 두 값으로만 저장한 1비트 3.9GB 빌드를 냈고, 아이폰과 아이패드에서 돈다는 것이 그 빌드를 내세운 이유였습니다. Bonsai 2에는 삼진 빌드만 있습니다. 폰에서 돌릴 생각이라면 7월 1세대 1비트 빌드가 여전히 유일한 선택지입니다. 5.93GB에 비전 처리 부분까지 얹은 이번 모델은 같은 기기에 들어가지 않습니다.
98.2%는 평균값입니다
항목별로 보면 유지율이 76%까지 내려가는 구간이 있습니다. 발표문에 실린 PrismML 자체 측정치입니다.
| 항목 | Bonsai 2 | Qwen3.8 27B 원본 |
|---|---|---|
| 지시 따르기 | 82.66 | 81.25 |
| 수학 | 96.57 | 97.06 |
| 코딩 | 81.58 | 82.17 |
| 에이전트·도구 호출 | 77.57 | 79.74 |
| 지식·추론 | 83.95 | 86.66 |
| 비전 | 78.59 | 81.64 |
수학은 0.49점, 코딩은 0.59점 차이입니다. 지시 따르기는 오히려 원본보다 1.41점 높습니다. 여기까지만 보면 "거의 손실 없음"이라는 표현이 과장이 아닙니다.
평균과 전혀 다르게 움직이는 영역이 하나 있습니다. 여러 단계를 이어가며 도구를 반복 호출하는 과제입니다. 코드를 고치고, 테스트를 돌리고, 실패를 읽고, 다시 고치는 식의 작업이 여기 들어갑니다.
기준을 하나 더 대 보겠습니다. 같은 Terminal-Bench 2.1에서 DeepSeek V4.1 Flash는 90.6점을 받았습니다. 로컬에서 도는 5.9GB 모델의 52.8점은 클라우드 코딩 에이전트를 대체할 점수가 아닙니다.
그렇다고 압축 기법 자체가 실패한 것은 아닙니다. 같은 베이스 모델을 llama.cpp가 기본 제공하는 초저비트 방식으로 줄인 IQ2_XXS 빌드는 7.3GB를 쓰고도 집계 75.2점에 그칩니다. Bonsai 2는 5.93GB에 83.9점입니다. 더 작으면서 8.7점 높습니다. 학습 단계부터 압축을 감안해 만든 쪽이, 다 만든 모델을 내려받아 기계적으로 줄인 쪽보다 낫습니다.
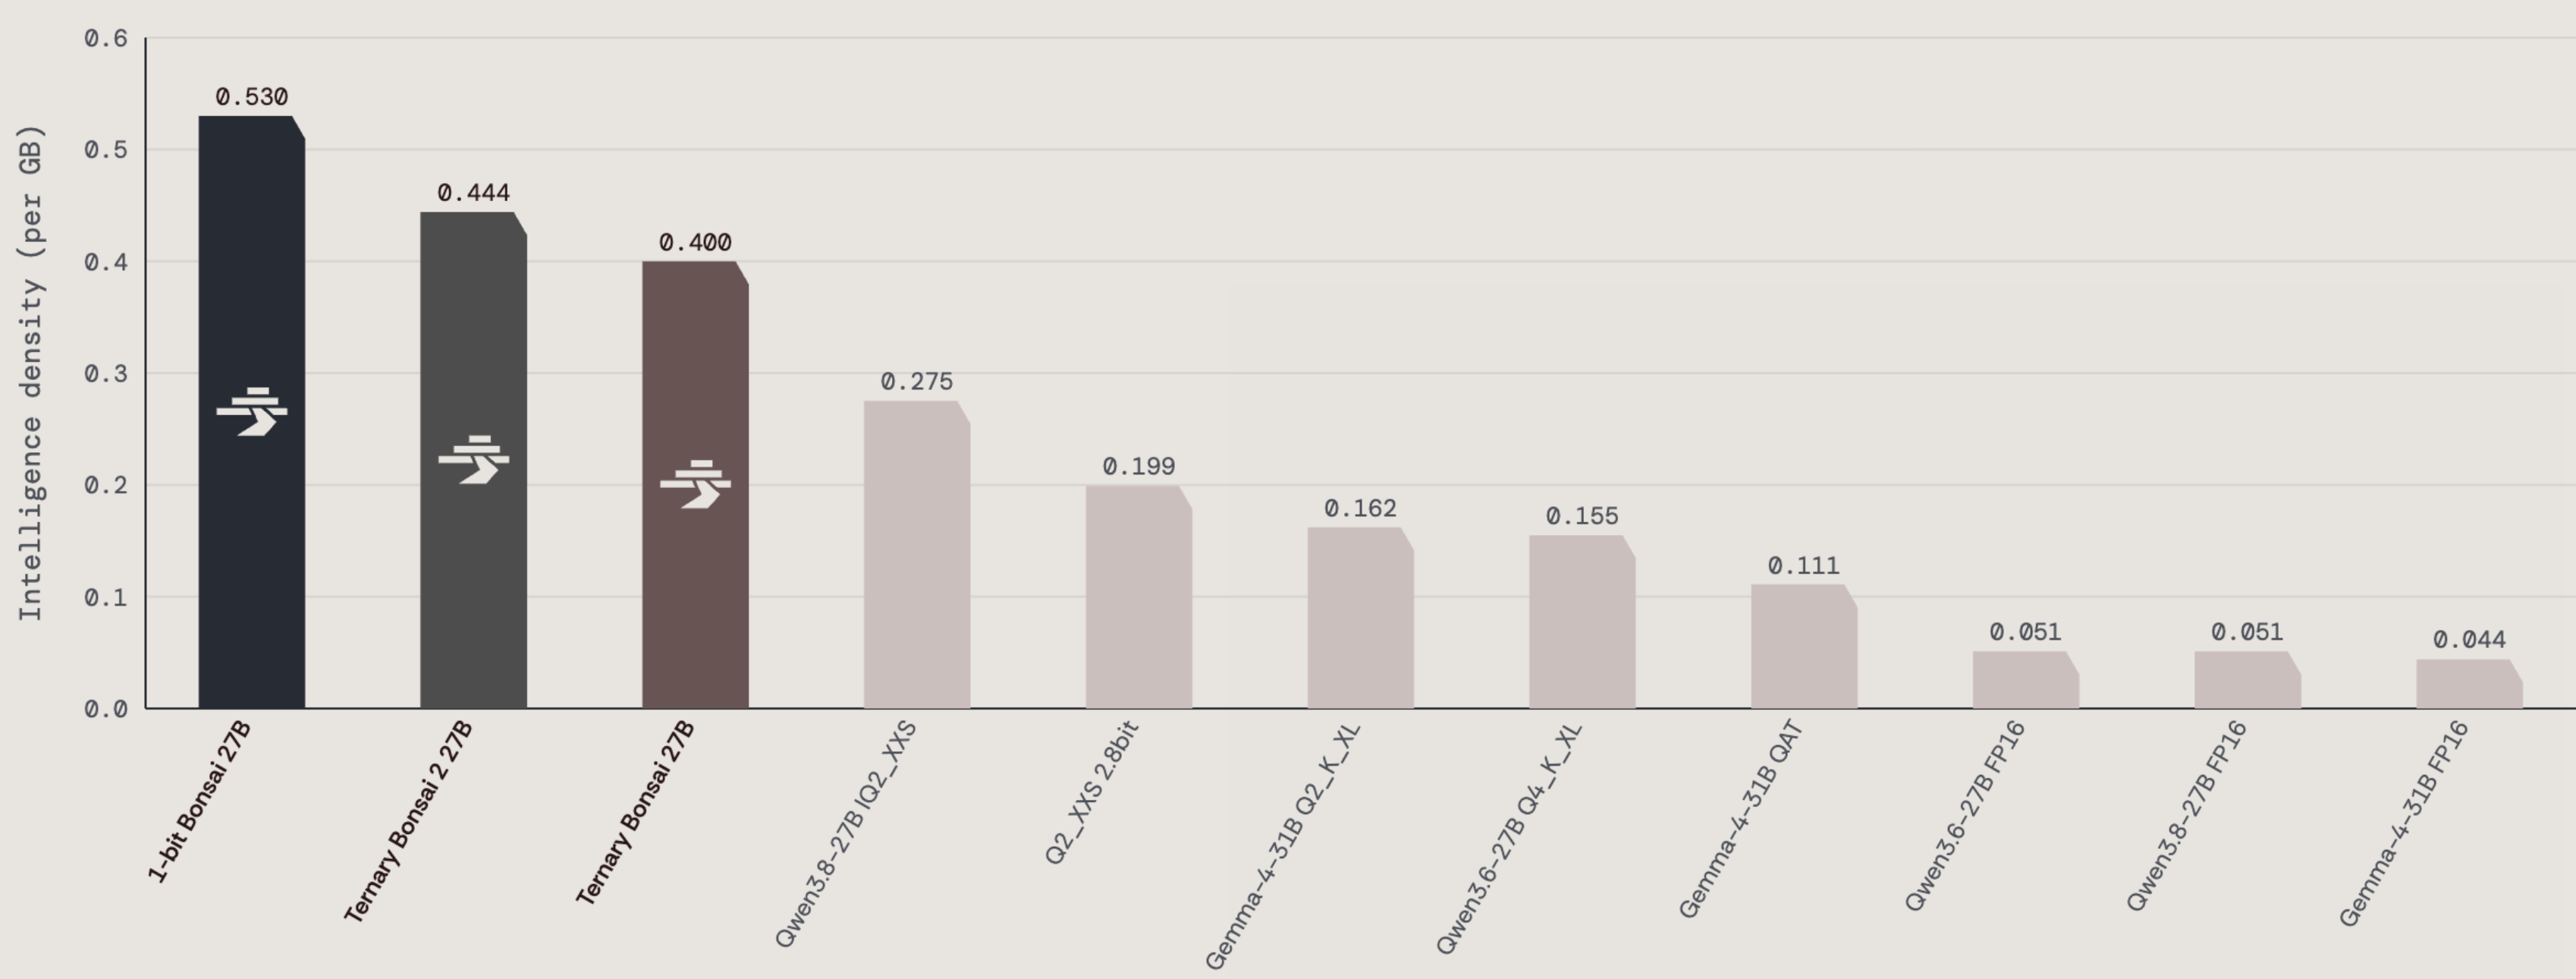
PrismML이 발표문에 함께 실은 그래프는 같은 점수를 몇 GB로 내는지를 자체 지표로 환산한 것입니다. Ternary Bonsai 2 27B가 0.444, 같은 베이스의 IQ2_XXS 빌드가 0.275, FP16 원본이 0.051입니다. 이 그래프에서 1위는 Bonsai 2가 아니라 7월에 나온 1비트 Bonsai 27B(0.530)입니다. 이번 릴리스에서 빠진 바로 그 빌드입니다.
한 가지 단서를 달아야 합니다. 98.2%는 PrismML이 자기 벤치마크 스위트를 자기 실행 환경에서 측정한 값이고, 아직 외부에서 재현한 곳이 없습니다. Hacker News에는 "장기 컨텍스트나 장시간 작업이 빠진 벤치마크 선정"이라는 지적이 올라왔습니다. 추론이 같은 자리를 맴돌다 출력 길이를 소진했다는 실행 보고와, 암기가 필요한 과제에서 원본 대비 열세라는 보고도 함께 있습니다.
지금 쓸 수 있나
내려받는 데는 아무 조건이 없습니다. 계정도, 승인도, 대기자 명단도 없고 한국에서도 제한 없이 받습니다. 진짜 관문은 실행 환경입니다.
| 실행 도구 | 상태 |
|---|---|
| 기본 llama.cpp | 실행 불가. PrismML 포크의 prism 브랜치나 사전 빌드 바이너리가 필요합니다 |
| Ollama | 0.34.2 기준 가져오기 실패. 모델 구조는 지원하지만 양자화 포맷을 못 읽습니다 |
| LM Studio | 커뮤니티가 만든 별도 런타임 필요. NVIDIA CUDA 한정입니다 |
| MLX (Apple) | 별도 빌드 제공 |
| AMD ROCm, Intel SYCL | 미지원 |
모델 카드의 문장이 분명합니다. "기본 llama.cpp는 이 파일들을 실행하지 않습니다." Hacker News 댓글에도 변경분을 상류 저장소에 반영하지 않은 것에 대한 불만이 반복해서 올라왔습니다. 이미 쓰는 로컬 모델 실행 환경을 그대로 두고 파일만 바꿔 끼우는 식으로는 안 됩니다.
속도는 PrismML 측정 기준 RTX 5090에서 초당 143토큰, Apple M5 Max에서 초당 46.8토큰입니다. Hacker News의 실사용 보고는 기기에 따라 더 넓게 퍼집니다. RTX 3070에서 초당 40.6토큰, RTX 3060에서 26.5토큰, M1 Pro에서 14.2토큰입니다. VRAM이 6GB인 카드에서는 65개 레이어 중 44개만 올라가 초당 0.67토큰까지 떨어졌습니다. 파일이 5.9GB라고 VRAM 6GB로 충분한 것이 아니라, 대화 내용을 담는 KV 캐시가 따로 메모리를 먹기 때문입니다.
이미 llama.cpp를 직접 빌드해 쓰고 있고 VRAM 8GB 이상 GPU나 Apple 실리콘 맥이 있다면, PrismML 포크를 받아 로컬 문서 요약이나 코드 설명처럼 한 번에 끝나는 작업부터 돌려 보면 됩니다. 이 모델이 원본에 가장 근접한 영역이 거기입니다. 반대로 로컬에서 코딩 에이전트를 돌릴 자리를 찾고 있었다면, SWE-bench 60.8점은 아직 클라우드 모델을 내릴 근거가 못 됩니다. 다음에 다시 볼 신호는 두 가지입니다. PrismML이 변경분을 llama.cpp 상류에 반영하는 시점, 그리고 1비트 Bonsai 2 빌드가 나와 폰과 8GB 기기로 내려오는 시점입니다.