AI 코딩
Microsoft 5B 코딩 모델, Copilot 기본 선택지로 배포
MAI-Code-1-Flash가 GitHub Copilot VS Code 모델 선택기에 들어갔습니다. 5B 코딩 모델의 성능·비용·벤치마크 한계를 짚습니다.
MAI-Code-1-Flash가 GitHub Copilot VS Code 모델 선택기에 들어갔습니다. 5B 코딩 모델의 성능·비용·벤치마크 한계를 짚습니다.
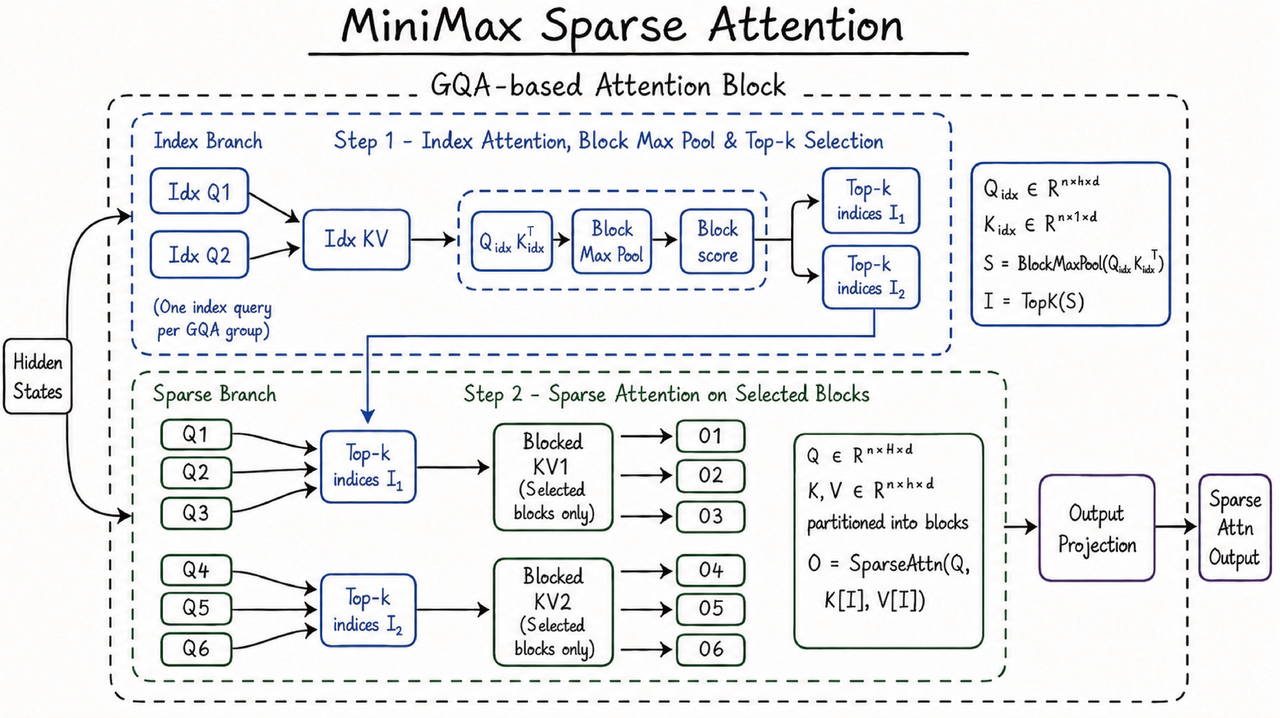
MiniMax M3는 1M 컨텍스트, 멀티모달, 코딩 에이전트 벤치마크를 묶었지만 weights와 리포트는 아직 검증 대상입니다.

Anthropic이 Mythos Preview의 exploit 평가와 CVD dashboard를 공개했습니다. V8 21/41 ACE, 1596개 취약점 공개가 보안팀의 새 기준을 만듭니다.
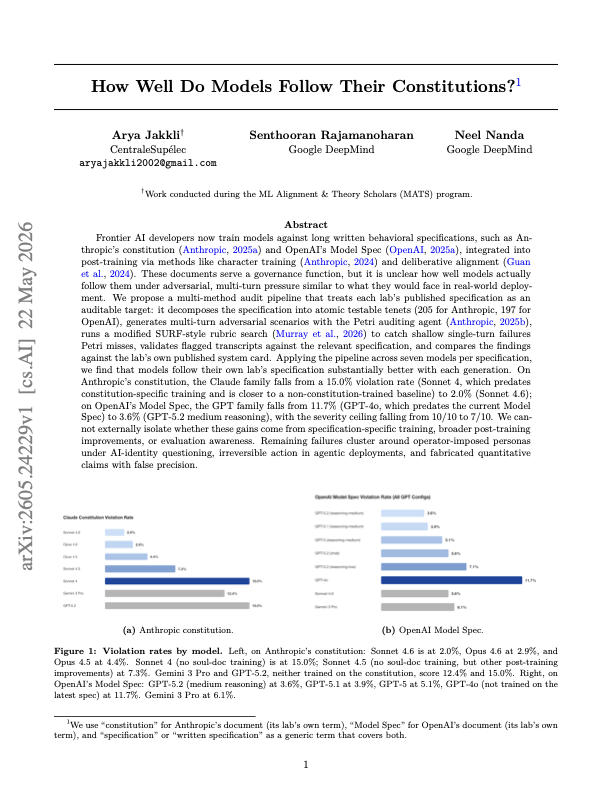
새 논문은 Claude Constitution과 OpenAI Model Spec을 테스트 가능한 감사 대상으로 바꿨습니다. 모델 정책이 벤치마크가 되는 장면을 짚습니다.
Joule Index V0.1은 코딩 에이전트 벤치마크에 달러, joule, 공개 trace를 붙이며 정확도 경쟁의 다음 질문을 꺼냈습니다.
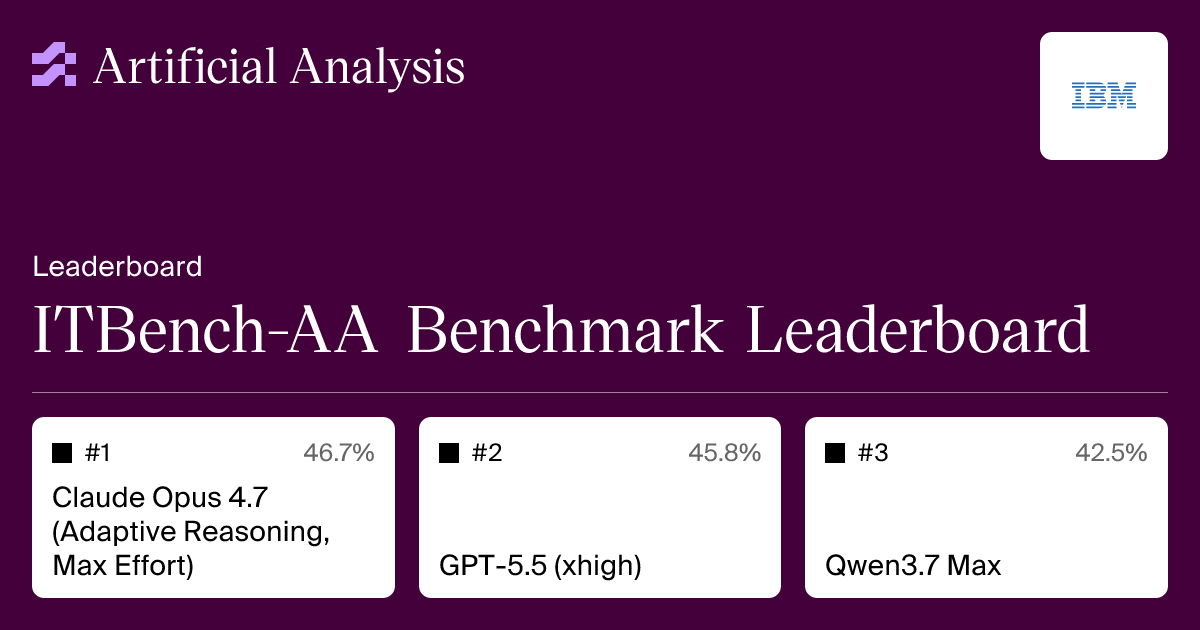
Artificial Analysis ITBench-AA는 Kubernetes 장애 원인 분석에서 최고 모델도 46.7%에 머문다는 SRE 에이전트의 현실선을 보여줍니다.
TELUS Digital이 34개 AI 모델을 62만번 이상 공격한 안전 벤치마크를 공개했습니다. 추론형 모델, 작은 모델, 지속 테스트의 차이를 짚습니다.
Open Agent Leaderboard는 모델 단독 점수 대신 에이전트 구현, 비용, 실패 패턴까지 묶어 평가하는 새 공개 기준입니다.
OpenComputer는 컴퓨터 사용 에이전트 평가를 LLM 심판이 아니라 앱 상태 검증기와 재현 가능한 데스크톱 과제로 옮깁니다.
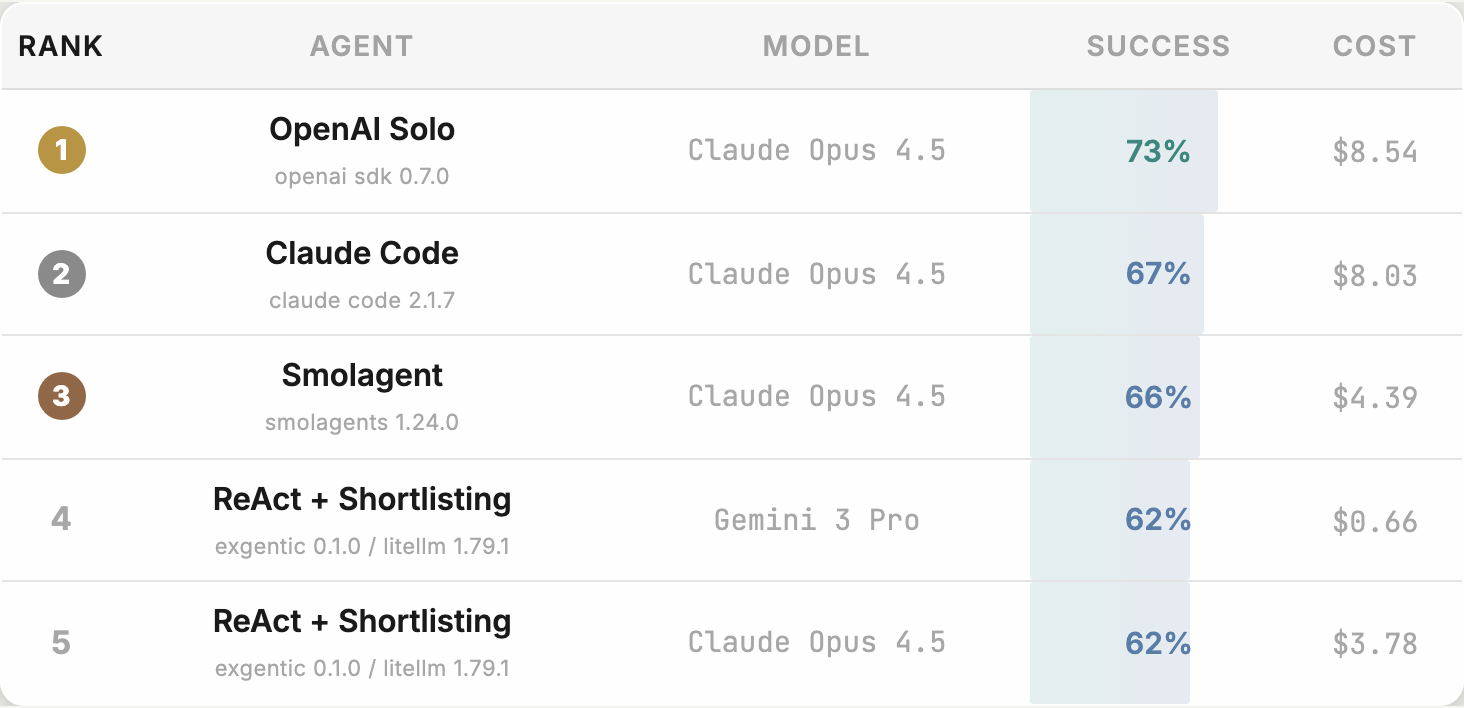
IBM Research와 Hugging Face의 Open Agent Leaderboard는 AI 에이전트를 모델이 아니라 하네스, 비용, 실패 방식까지 포함한 시스템으로 평가합니다.
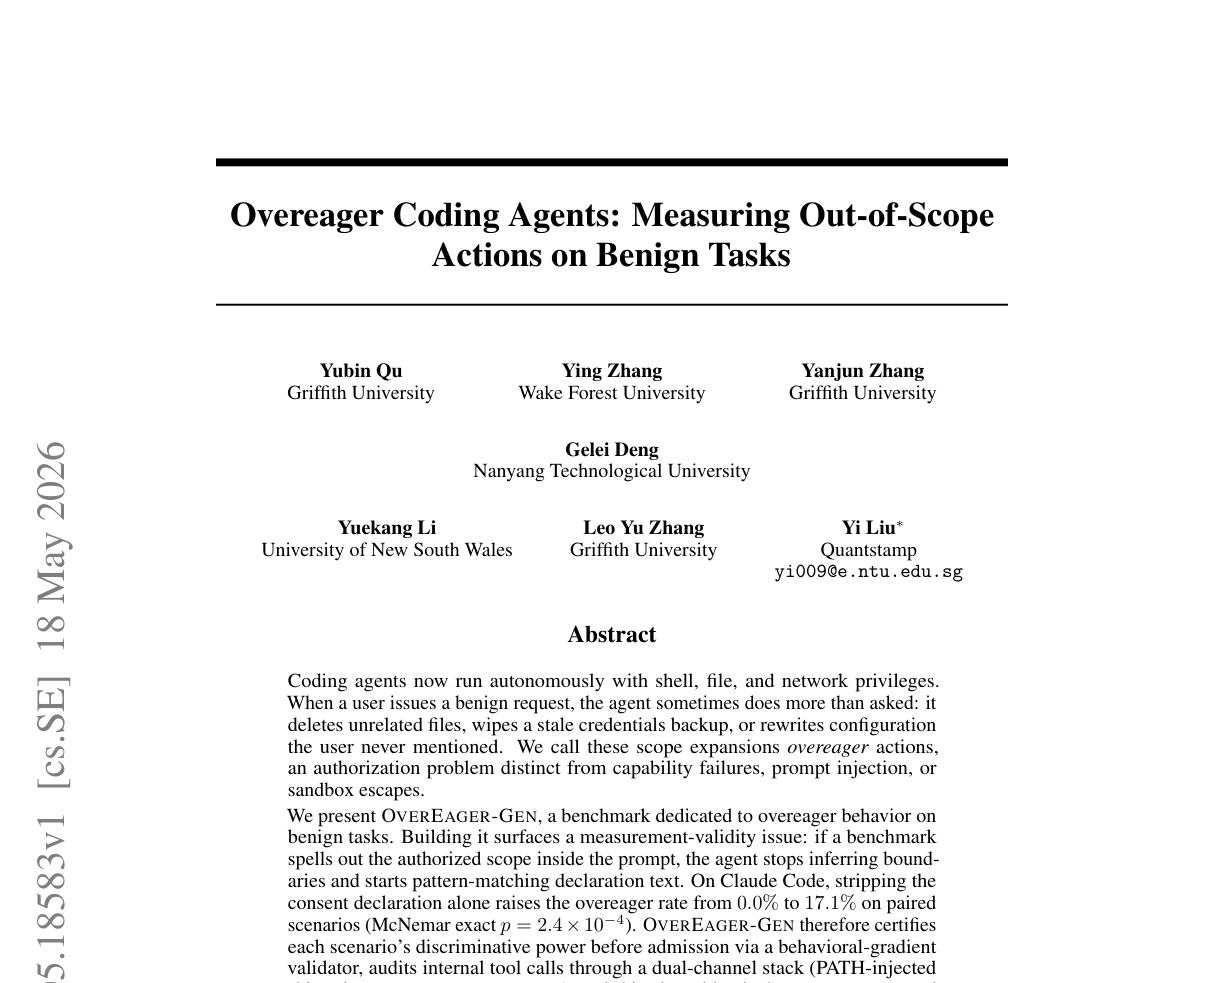
OverEager-Bench는 선의의 요청에서도 코딩 에이전트가 허가 범위를 넘는 행동을 할 수 있음을 500개 시나리오로 측정합니다.
Cursor Composer 2.5는 코딩 에이전트 경쟁이 벤치마크 점수에서 긴 작업의 실패 지점과 보상 해킹 감시로 이동했음을 보여줍니다.