AI 에이전트
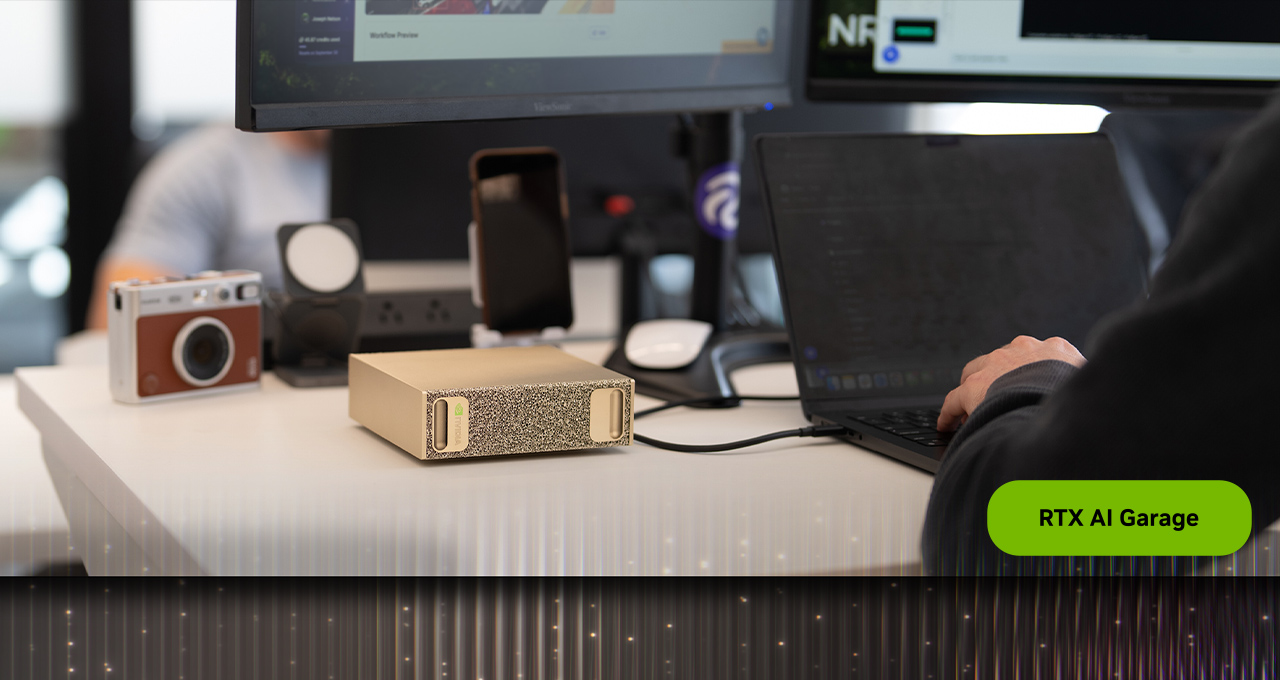
RTX Spark 공개, 120B LLM용 로컬 AI PC
NVIDIA와 Microsoft가 RTX Spark를 공개했습니다. 120B LLM, 128GB unified memory, OpenShell로 로컬 에이전트 PC를 겨냥합니다.
NVIDIA와 Microsoft가 RTX Spark를 공개했습니다. 120B LLM, 128GB unified memory, OpenShell로 로컬 에이전트 PC를 겨냥합니다.
NVIDIA CUDA 13.3은 CompileIQ와 CUDA Python 1.0으로 LLM 추론 비용의 낮은 계층인 커널과 컴파일러 병목을 겨냥합니다.
NVIDIA가 tri-mode diffusion LLM을 공개했습니다. AR, diffusion, self-speculation을 한 모델에서 전환하는 추론 실험입니다.
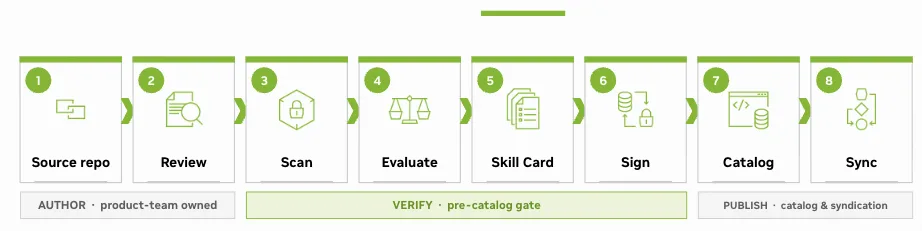
NVIDIA Verified Agent Skills는 에이전트 스킬을 스캔, 카드, 서명으로 관리하며 AI 에이전트 공급망의 새 검문소를 제시합니다.
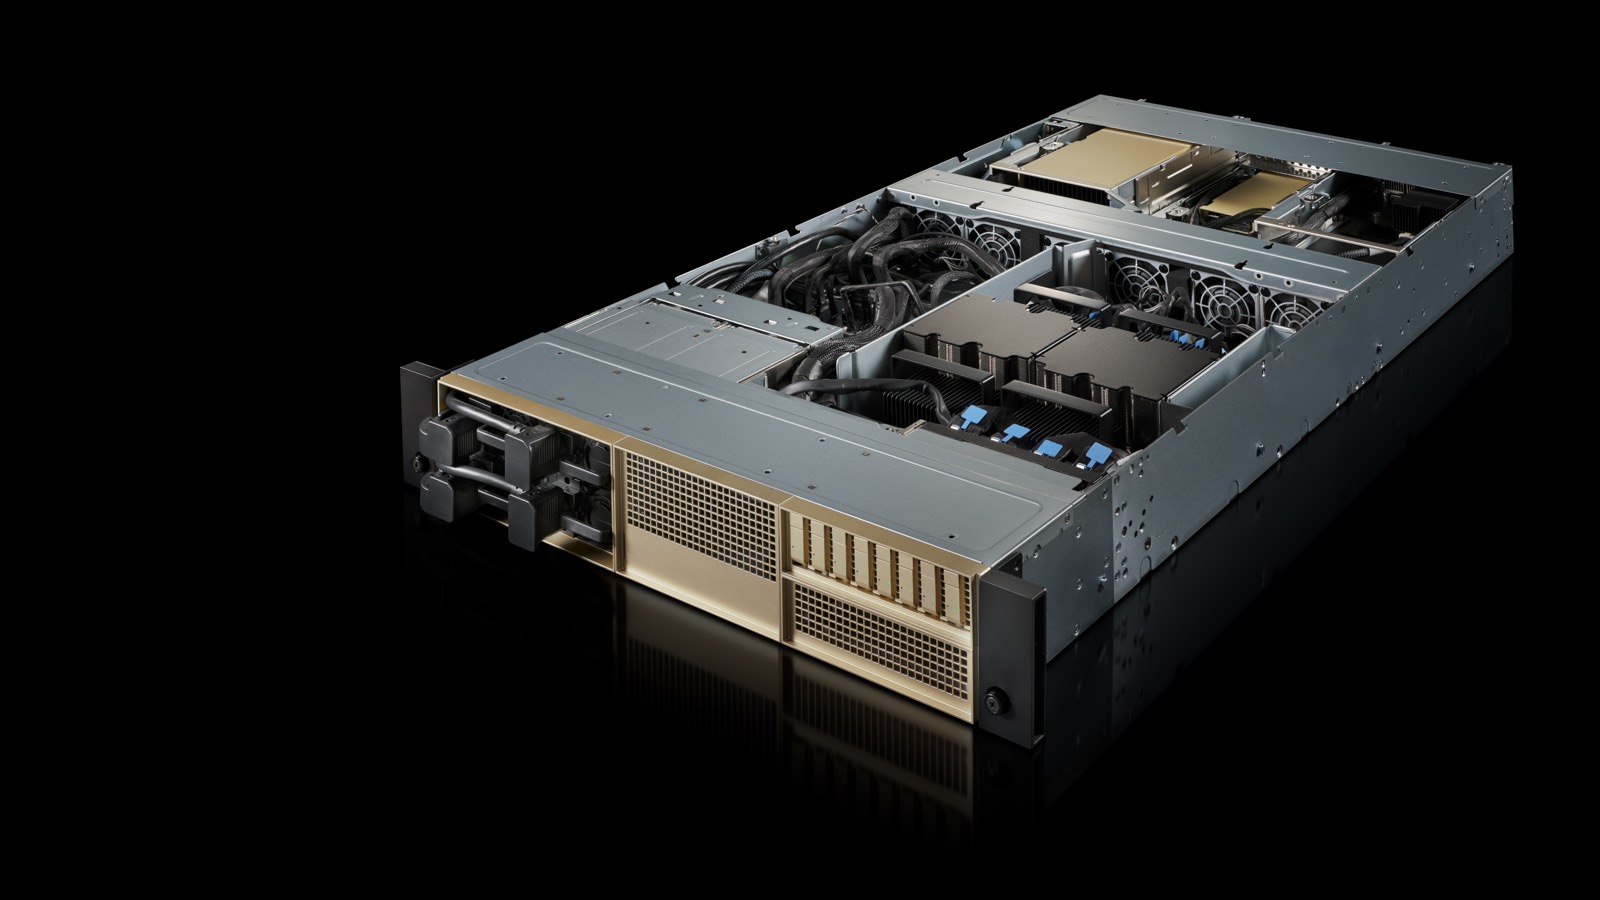
NVIDIA Vera CPU 첫 인도는 AI 에이전트 경쟁의 병목이 GPU 추론뿐 아니라 샌드박스, 툴 호출, RL 평가를 떠받치는 CPU로 이동했음을 보여줍니다.
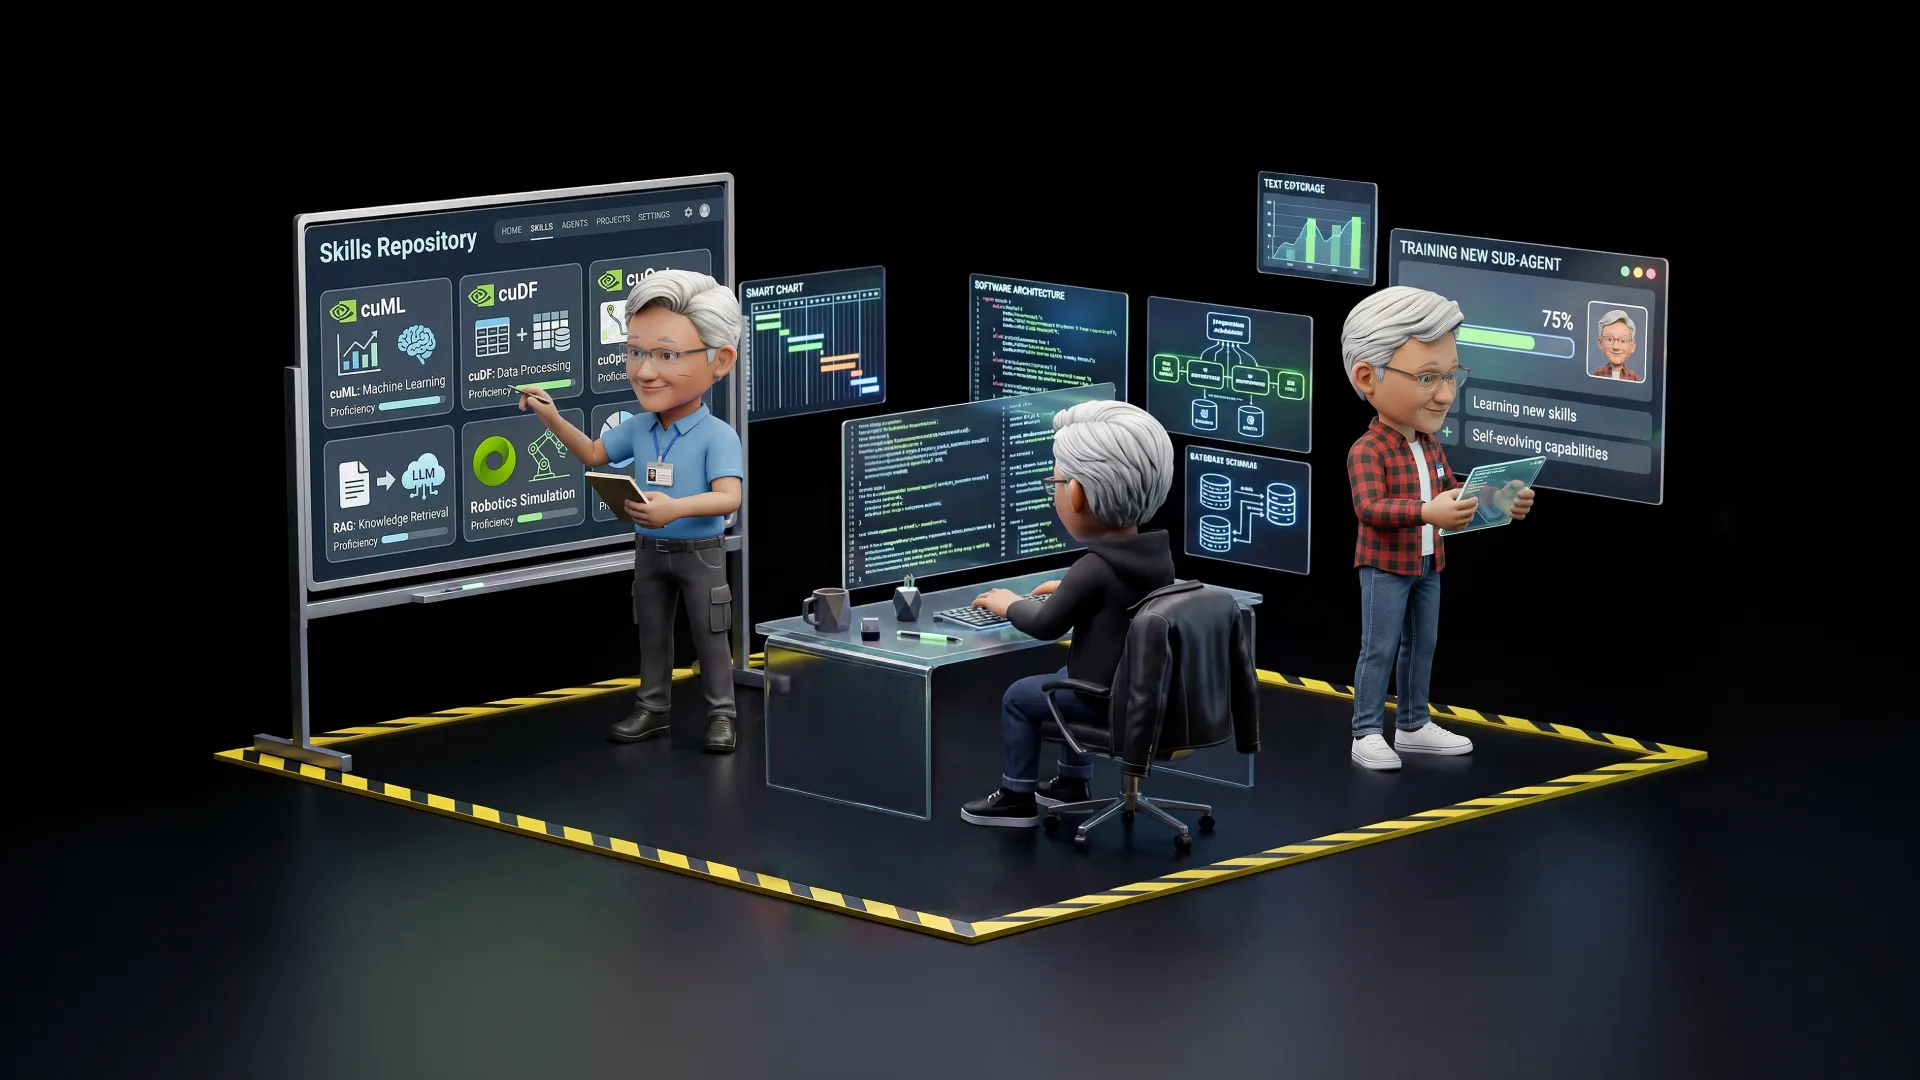
NVIDIA AI-Q agent skill은 Claude Code와 Codex가 기업 데이터 연구를 로컬 AI-Q 서버에 위임하게 만드는 새 실행 구조입니다.
NVIDIA SANA-WM은 2.6B 파라미터로 720p 60초 월드 모델을 주장합니다. 진짜 의미는 영상 품질보다 오픈 모델의 비용 구조입니다.
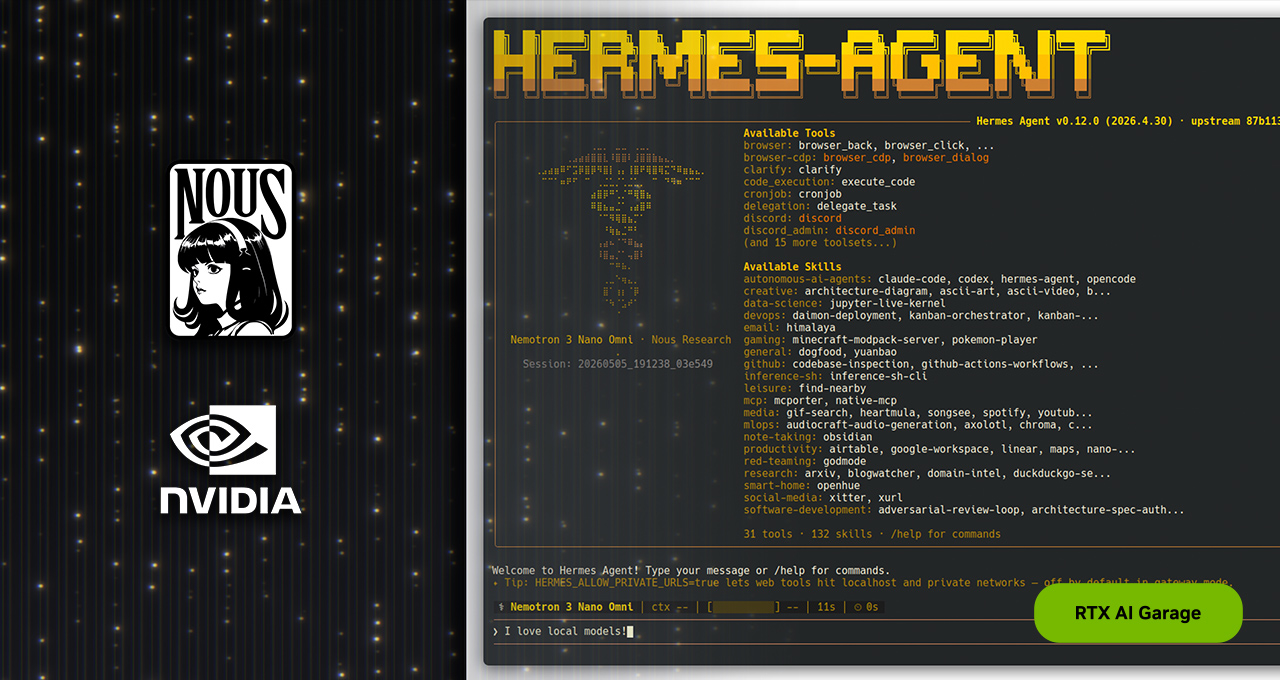
NVIDIA가 Hermes Agent를 RTX와 DGX Spark에 최적화하며 로컬 상시 실행 self-improving agent 경쟁을 밀고 있습니다.
NVIDIA와 Ineffable Intelligence의 협력은 모델 경쟁이 인간 데이터 이후의 RL 인프라 경쟁으로 이동하고 있음을 보여줍니다.
Nvidia가 Mamba-Transformer 하이브리드 MoE 아키텍처의 Nemotron 3 Super를 공개했습니다. 120B 파라미터 중 12B만 활성화하며, 에이전틱 AI의 context explosion 문제를 해결하는 새로운 아키텍처 패러다임입니다.
DeepMind 출신 창업자들의 Reflection AI가 매출 없이 $25B 밸류에이션을 받았습니다. Nvidia $800M, JPMorgan 국가안보 펀드까지 참여한 이 딜의 본질은 AI 기술이 아니라 지정학적 인프라 포지셔닝입니다.
DeepSeek이 V4 모델의 사전 접근을 Nvidia와 AMD에 거부하고 Huawei에 독점 제공했습니다. 1조 파라미터 모델이 중국산 칩에 최적화되며, 글로벌 AI 생태계의 분기가 현실이 되고 있습니다.