모델과 연구
Claude Opus 5.5 출시, Fable 5.1급 성능에 값은 60% 아래인 이유
Anthropic이 9월 22일 Claude Opus 5.5를 공개했습니다. 입력 100만 토큰 4달러로 Fable 5.1의 10달러보다 60% 싸고, Terminal-Bench 4.0은 Opus 5의 52.3%에서 66.4%로 올랐습니다.
Anthropic이 9월 22일 Claude Opus 5.5를 공개했습니다. 입력 100만 토큰 4달러로 Fable 5.1의 10달러보다 60% 싸고, Terminal-Bench 4.0은 Opus 5의 52.3%에서 66.4%로 올랐습니다.
PrismML이 9월 17일 Qwen3.8 27B를 5.9GB로 줄인 Ternary Bonsai 2 27B를 Apache 2.0으로 공개했습니다. 벤치마크 20종 평균은 98.2%를 유지하지만 장시간 코딩 과제 점수는 4분의 3으로 내려갑니다.
구글이 9월 15일 음성 모델 두 종을 냈습니다. 값싼 gemini-3.8-live는 종합 지수가 71.5%에서 76.0%로 올랐지만 도구를 쓰는 과제 완료율은 전작보다 낮습니다.
TypeSafe가 글 대신 선택지와 확률만 돌려주는 모델 Jev를 공개했습니다. 입력 100만 토큰 0.042달러에 출력은 무료지만, 자사 평가 정확도는 GPT-5.6 Luna와 비슷한 67%대로 Sol보다 약 6점 낮고 대기자 명단으로만 열립니다.
DeepSeek가 9월 10일 552B 오픈 웨이트 모델 V4.1 Flash를 공개하고 9월 14일 오후 1시(한국)부터 V4 Pro 요청을 이 모델로 넘깁니다. 에이전트 코딩 점수는 Pro보다 높고 출력값은 70% 싸지만 사실 지식 점수는 55.2에서 42.3으로 내려갑니다.
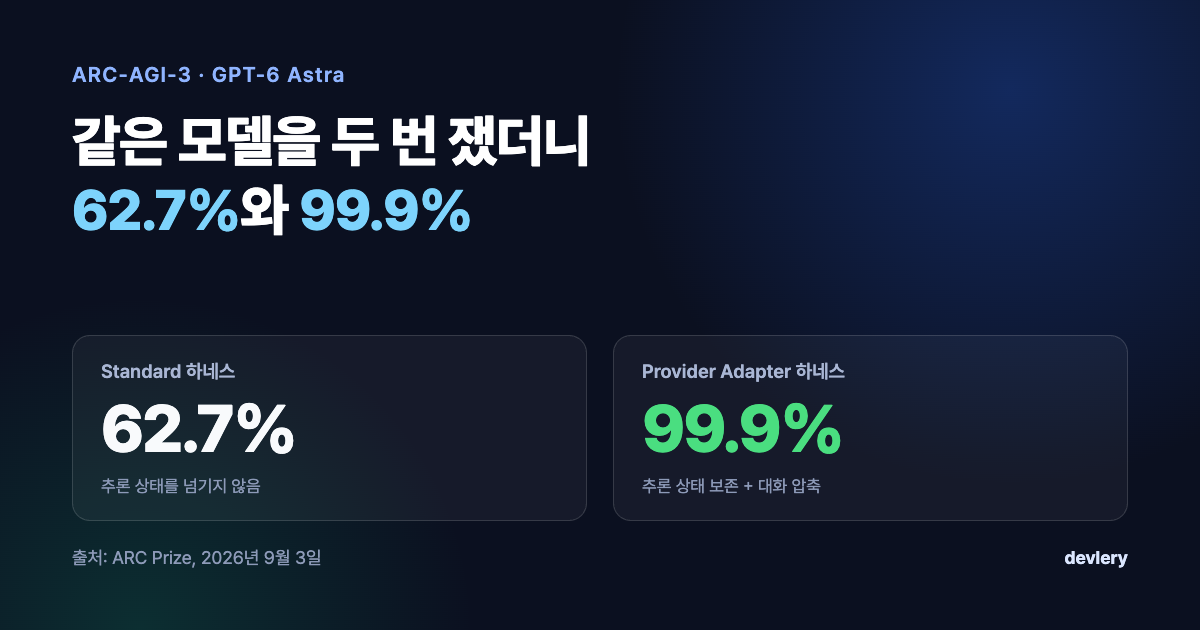
ARC Prize가 ARC-AGI-3에서 GPT-6 Astra를 두 조건으로 측정해 62.7%와 99.9%를 얻었습니다. 모델은 같고, 추론 상태를 다음 호출로 넘겼는지만 달랐습니다. 리더보드는 앞으로 두 점수를 함께 싣습니다.
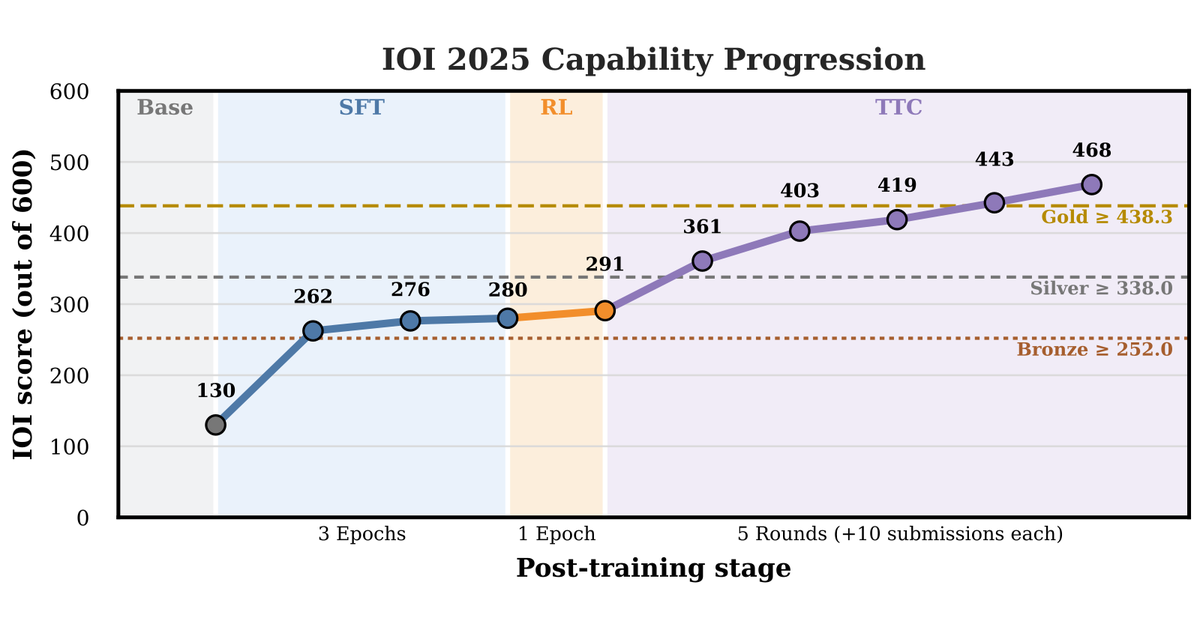
Nvidia Nemotron-3-Ultra-CC가 IOI 2026에서 535.4점을 받아 인간 최고 득점 498.27점을 넘었습니다. 논문 수치를 보면 점수의 대부분은 사후학습이 아니라 후보를 200개씩 다시 뽑는 테스트타임 루프에서 나왔습니다.
MBZUAI 산하 IFM이 9월 3일 K2 Horizon 6종을 Apache 2.0으로 공개했습니다. 7B가 SWE-bench Verified 70.6%로 Qwen3.5-9B를 앞섰지만 훈련 코드 저장소와 데이터셋 링크는 아직 닫혀 있습니다.
OpenAI가 9월 3일 GPT-6 Astra를 냈습니다. API 단가는 100만 토큰 10달러와 50달러로 GPT-5.6 Sol의 2.5배지만, 코딩에서는 Sol이 쓰던 토큰의 3분의 1만 씁니다. 독립 지수는 Sol과 같은 61점입니다.
Google이 9월 2일 Gemini 3.8 Flash를 공개했습니다. 단가는 3.7 Flash와 같은 100만 토큰당 0.75달러인데 DeepSWE는 65.3%에서 73.7%로 올랐고, 범용 에이전트 벤치마크는 19.1%로 Claude Opus 5의 51.8%에 못 미칩니다.
Anthropic이 9월 1일 Claude Fable 5.1과 Mythos 5.1을 공개했습니다. 에이전트 코딩은 Fable 5의 42.0%에서 55.8%로 올랐고, 대화 중간 effort 변경이 새로 열렸으며, 캐시 읽기 단가는 4분의 1이 됐습니다.
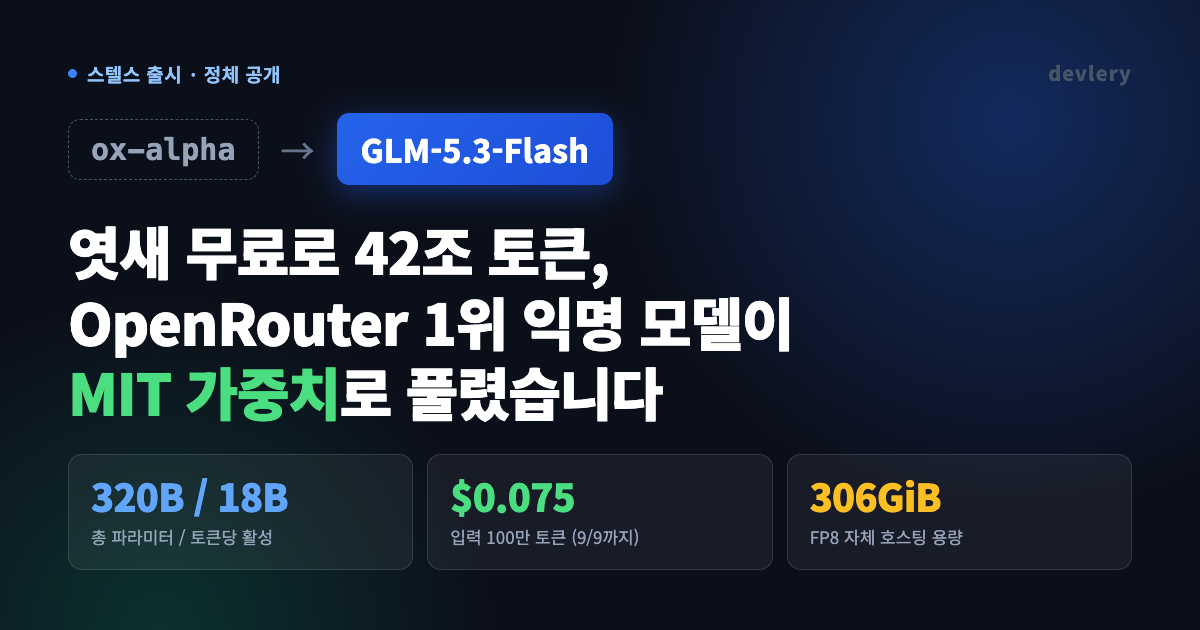
8월 20일 무료로 등장해 엿새 만에 OpenRouter 사용량 1위에 오른 익명 모델 ox-alpha의 정체가 GLM-5.3-Flash로 공개됐습니다. Zhipu가 같은 날 320B-A18B 가중치를 MIT로 풀었고 무료 기간은 끝났습니다.