ChatGPT와 Codex 글에 안 보이는 워터마크, EU는 자동이고 API는 기본 꺼짐
OpenAI가 2026년 10월 5일 텍스트 워터마크 textGrain을 공개했습니다. EU의 ChatGPT와 Codex에는 자동으로 들어가지만 API는 기본이 꺼짐이라 조직 설정에서 직접 켜야 합니다. 단어 25%를 바꾸면 탐지율은 17%로 떨어집니다.
- EU의 ChatGPT와 Codex 글에 안 보이는 워터마크가 들어갑니다.
- API는 기본이 꺼짐이라 조직 설정에서 직접 켜야 합니다.
- 단어 25%를 동의어로 바꾸면 탐지율은 17%로 떨어집니다.
OpenAI가 2026년 10월 5일 텍스트 워터마크 기술 textGrain을 공개했습니다. 원리는 이렇습니다. 모델이 글을 쓰면서 다음 단어를 고를 때, 비밀 키로 만든 아주 작은 편향을 거기 섞어 둡니다. 읽는 사람 눈에는 아무것도 보이지 않습니다. 같은 키를 가진 탐지기만 그 패턴이 우연보다 자주 나타나는지 계산할 수 있습니다. 숨은 문자나 보이지 않는 공백을 끼워 넣는 방식이 아니라서 다른 곳에 복사해 붙여넣어도 표식이 따라갑니다.
적용은 두 갈래로 나뉩니다. EU에서는 ChatGPT와 Codex 출력에 앞으로 몇 주에 걸쳐 자동으로 들어갑니다. 요금제는 가리지 않습니다. API는 반대입니다. 기본값이 꺼짐이어서 전 세계 어디서든 고객이 설정에서 직접 켜야 합니다.
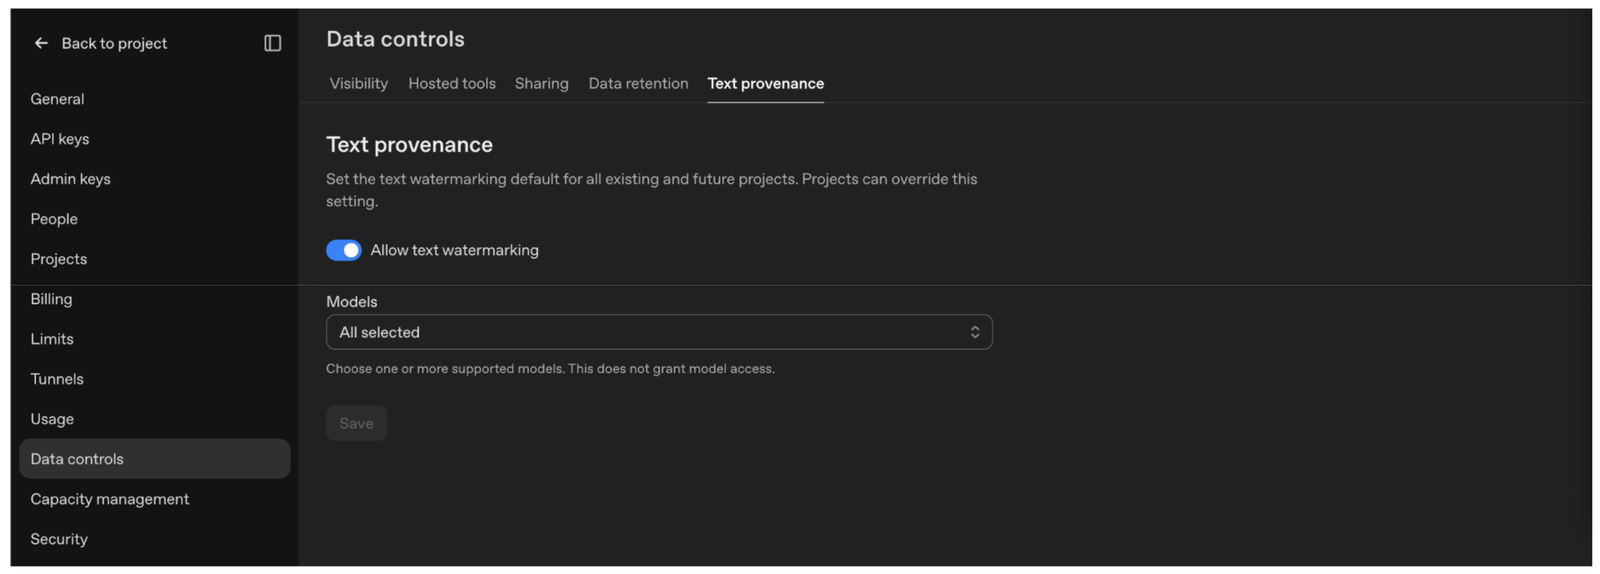
조직 설정의 Text provenance 탭. 여기서 켠 값이 모든 프로젝트의 기본값이 됩니다. 출처: OpenAI 헬프센터
스위치는 어디 있고, 왜 생겼나
OpenAI의 출처 표시는 지금까지 이미지와 오디오에만 붙어 있었습니다. C2PA 서명과 SynthID 워터마크를 한 묶음으로 발표한 2026년 5월 이후로 글은 빠져 있었는데, 이번에 텍스트가 들어왔습니다.
API를 쓴다면 켜는 자리는 두 군데입니다. 조직 전체 기본값은 조직 설정의 Data controls 아래 Text provenance 탭입니다. 프로젝트별로 덮어쓰려면 프로젝트 설정의 같은 이름 탭을 엽니다. Allow text watermarking을 켜고 모델을 고른 뒤 저장하면 끝입니다. 요청마다 파라미터를 붙이지 않아도 되고 응답마다 표시를 덧붙일 필요도 없습니다. OpenAI가 생성 단계에서 넣습니다. 지금은 일부 모델만 목록에 뜨고 레거시 모델은 몇 주에 걸쳐 추가한다고 밝혔습니다. 폐기가 임박한 gpt-image-1, gpt-image-1.5, sora-2는 대상에서 빠집니다.
이 스위치가 왜 지금 생겼는지는 날짜 두 개로 설명됩니다. EU AI법 제50조(2)는 생성형 AI 제공자에게 출력물을 기계가 읽을 수 있는 형태로 표시하라고 요구합니다. 2026년 8월 2일부터 적용되고 있습니다. 그 전에 시장에 나와 있던 시스템은 디지털 옴니버스(규정 2026/1744)로 4개월을 더 받았습니다. 그 기한이 2026년 12월 2일입니다.
여기서 표시 책임이 OpenAI에서 개발자 쪽으로 넘어옵니다. OpenAI 모델을 가져다 자기 제품으로 EU 사용자에게 글을 내보내는 쪽이라면, OpenAI가 ChatGPT에 자동으로 넣는 워터마크는 내 제품 출력과 아무 상관이 없습니다. API로 받은 텍스트에 표시를 넣는 일은 설정을 켜든 다른 방법을 쓰든 직접 해야 합니다.
켜면 얼마나 잡히나
탐지 성능은 OpenAI가 숫자로 공개했습니다. 잘 되는 쪽보다 안 되는 쪽이 더 또렷합니다. 기준은 오탐률 1%입니다. 심리학처럼 표현을 고를 여지가 넓은 글이면 400토큰짜리에서 약 95%, 200토큰짜리에서 약 80%를 잡아냅니다. 수학처럼 쓸 수 있는 말이 정해진 글에서는 "상당히 낮다"고만 적었고 수치는 차트로만 보여줬습니다.
400토큰 서술형 글
손대지 않았을 때
같은 글에서
단어 10% 치환
같은 글에서
단어 25% 치환
편집에 약합니다. 400토큰 글의 단어 10%를 동의어로 바꾸면 92%였던 탐지율이 66%로 내려갑니다. 25%를 바꾸면 17%만 남습니다. 번역이나 전면 재작성은 신호를 아예 지웁니다. OpenAI도 워터마크가 안 나왔다고 해서 사람이 썼다는 증거가 되지는 않는다고 못 박았습니다. 짧은 글, 편집된 글, 번역된 글, 워터마크 이전에 만든 글, 다른 회사 도구로 쓴 글이 모두 같은 결과를 냅니다.
언어별로도 고르지 않습니다. 영어 프롬프트 500개를 EU 나머지 23개 공용어로 번역해 재어 보니 스페인어가 69.0%로 가장 높고 루마니아어가 42.2%로 가장 낮았습니다. 24개 언어 가운데 70%를 넘긴 언어는 하나도 없습니다. OpenAI는 워터마크 강도를 조절하는 파라미터로 60% 아래 언어들을 끌어올렸습니다. 아래 차트에서 옅은 파란색이 그 상승분입니다.
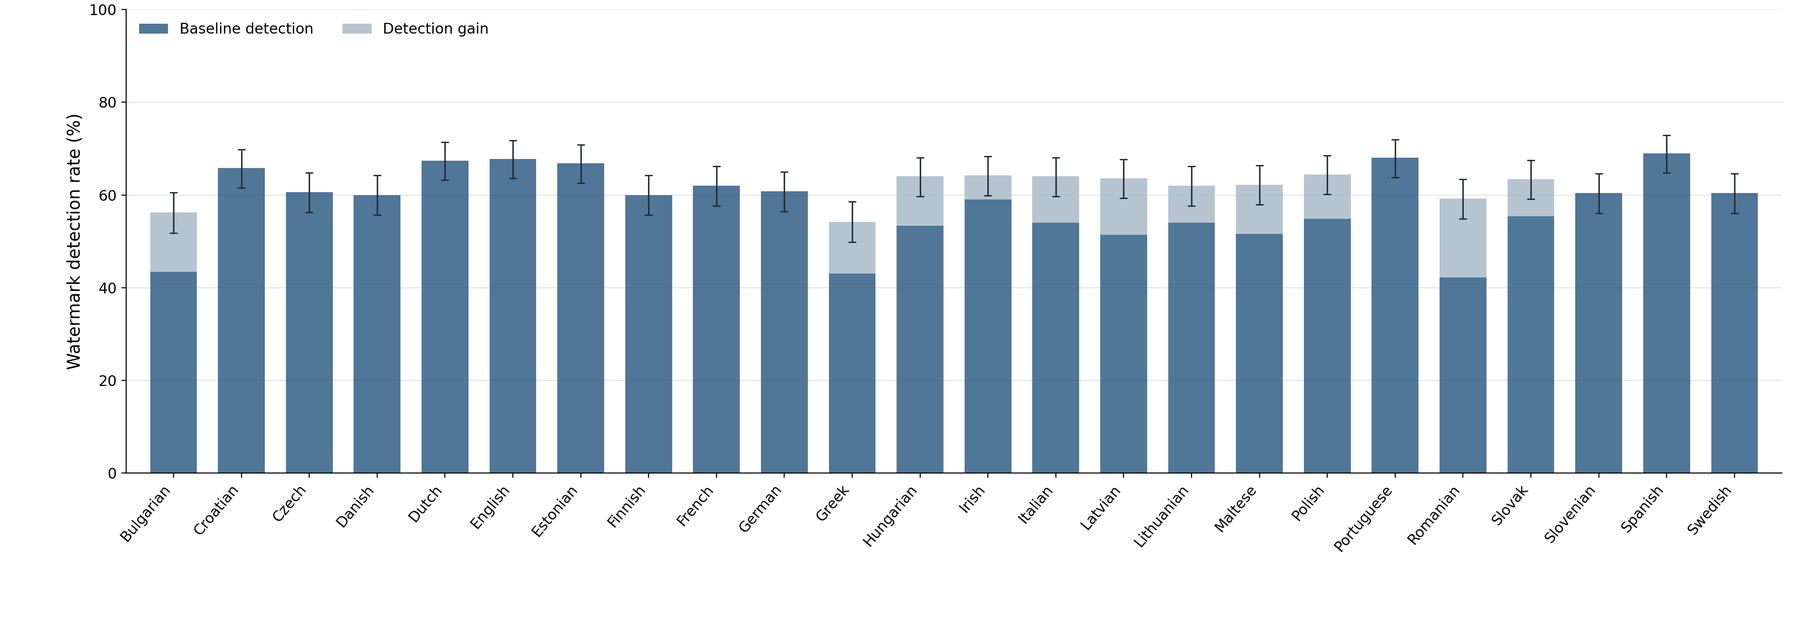
한국어는 EU 공용어가 아니라 이 평가에 들어 있지 않고, 따로 공개된 수치도 없습니다. 출처: OpenAI 헬프센터
품질 쪽 걱정은 상대적으로 적습니다. 최신 프런티어 모델 Astra로 워터마크를 켜고 끈 상태를 벤치마크 8종에서 비교했더니 DeepSWE v1.1은 72.80%에서 71.68%로 내려갔고 Terminal-Bench 4.0은 53.90%에서 56.06%로 올랐습니다. OpenAI는 이 정도 차이가 평가를 반복 실행할 때 늘 생기는 잡음 범위라고 설명했습니다. 속도 영향도 무시할 만하다고 적었습니다.
코드와 짧은 답은 애초에 빠진다
발표문에 Codex 이름이 들어갔다고 해서 에이전트가 써 준 코드에 워터마크가 박히는 것은 아닙니다. EU 실행 규약이 두 가지를 면제하기 때문입니다. 200토큰 미만 출력(영어로 약 150단어)과 코드 스니펫입니다.
면제가 아니었더라도 코드에는 신호가 잘 안 실립니다. 이 워터마크는 모델이 같은 내용을 여러 방식으로 쓸 수 있을 때만 표식을 실을 수 있습니다. OpenAI 헬프센터는 코드가 어려운 이유를 다음에 올 토큰의 그럴듯한 선택지가 일반 산문보다 적기 때문이라고 설명합니다. 수학 문제의 답, 사용자가 준 텍스트를 바꾸지 말고 그대로 내놓으라는 요청도 같은 이유로 신호가 거의 안 남습니다.
제품을 만드는 쪽이 먼저 셀 것은 출력 길이입니다. 내 서비스가 EU 사용자에게 내보내는 응답이 대체로 200토큰 아래라면, 설정을 켜도 규약이 요구하는 표시가 생기지 않습니다. 그 경우에는 화면에 보이는 AI 생성 안내가 따로 필요합니다. OpenAI도 기계가 읽는 표시는 눈에 보이는 라벨이나 배너를 대신하지 않는다고 문서에 적어 두었습니다.
켠 사람도 자기 글을 검사하지 못한다
워터마크를 켠다고 탐지기를 쓸 수 있는 것은 아닙니다. 둘은 완전히 분리돼 있습니다. 탐지기 신청은 10월 5일부터 받고 있는데, 자격은 텍스트 출처와 탐지 신뢰도, 사람들이 출처 결과를 어떻게 받아들이는지를 연구하는 학술·연구 기관으로 한정했습니다. 현재 파트너는 코넬대 John Thickstun, ETH 취리히의 Martin Vechev, 그리고 슬로바키아 KInIT 연구진입니다.
범위 밖으로 명시한 용도가 더 눈에 띕니다. 상업적 사기 방지와 인증·검증, 출처 분석을 묶어 되파는 서비스, 그리고 학생 과제의 AI 사용 확인이 모두 제외됐습니다. 탐지기를 가장 쓰고 싶어 할 쪽이 교육 현장인데 그쪽부터 막았습니다. 25% 치환에 17%까지 떨어지는 탐지율과 1% 오탐률을 보면 납득이 가는 선택입니다. 동시에 이 표식으로 지금 할 수 있는 일이 그만큼 좁습니다.
이미지·오디오 쪽은 다릅니다. 그쪽은 openai.com/verify와 Content Provenance API가 누구에게나 열려 있고 검사도 무료입니다. 텍스트만 심사를 거칩니다.
| 항목 | OpenAI | Anthropic |
|---|---|---|
| 기술 | 자체 개발 textGrain | Google SynthID-Text 변형 |
| 소비자 제품 적용 | EU만 자동 | 전 세계 자동 |
| API | 전 세계에서 켤 수 있고 기본은 꺼짐 | 제품 구분 없이 적용 |
| 탐지기 | 학술·연구 기관 심사 | 규제기관·언론·연구자 프라이빗 프리뷰 |
Anthropic은 8월 14일에 이미 같은 일을 했는데, 지역별로 범위를 나눌 안정적인 방법이 없다는 이유로 처음부터 전 세계에 적용했습니다. OpenAI는 EU가 요구하는 자리에만 넣고 나머지는 고객 선택으로 돌렸습니다. textGrain은 오픈소스로 공개할 계획이라고만 밝혔고 일정은 내놓지 않았습니다.
한국에서는 어떻게 되나
한국 ChatGPT와 Codex 사용자에게는 자동으로 들어가지 않습니다. 자동 적용은 EU 한정입니다. 반면 API 설정에는 지역 제한이 없습니다. 한국 계정으로도 오늘 조직 설정에서 켤 수 있습니다.
| 항목 | 내용 |
|---|---|
| 대상 | EU의 ChatGPT·Codex 사용자는 전 요금제 자동, 전 세계 API 고객은 설정에서 선택. 클라우드 경유 출력은 파트너별로 적용 중 |
| 요금제·가격 | 추가 비용 없음. 탐지기 검사도 현재 무료 |
| 한국 사용 | ChatGPT·Codex 자동 적용은 안 됨. API 설정은 오늘 켤 수 있음 |
| 필요 조건 | 조직 또는 프로젝트 설정에서 Text provenance 켜기. 탐지기는 별도 신청과 승인이 필요하고, 워터마크를 켰다고 접근권이 생기지 않음 |
국내 규제에도 비슷한 조항이 있습니다. 2026년 1월 22일 시행된 인공지능 기본법 제31조는 생성형 AI 사업자에게 결과물이 AI로 만들어졌다는 사실을 표시하도록 하고, 사람이 알아보는 방식과 기계가 읽는 형식 중 하나를 쓸 수 있게 했습니다. 다만 어떤 기계 판독 표시가 이 조항을 충족하는지는 OpenAI 문서가 답해 주지 않습니다. OpenAI 스스로도 각자의 법적 의무는 각자의 법무팀이 판단할 일이라고 적었습니다.
EU 사용자에게 글을 내보내는 제품을 운영한다면, 조직 설정의 Text provenance를 열기 전에 최근 한 주치 응답 로그에서 출력 토큰 길이의 중앙값부터 세어 보는 편이 빠릅니다. 200토큰을 넘는 응답이 대부분이면 설정 하나로 12월 2일 기한에 대응할 여지가 생깁니다. 그 아래라면 켜 봐야 규약이 요구하는 표시가 만들어지지 않으니 화면에 보이는 안내를 설계하는 일이 먼저입니다. 어느 쪽인지는 쿼리 한 번이면 나옵니다.