GitHub이 AI 코드 리뷰 벤치마크를 열었다, 1위 Copilot도 알려진 결함의 26%
GitHub이 10월 5일 공개한 ReviewBench는 공개 PR 219건으로 코드 리뷰 에이전트를 채점합니다. 1위 Copilot Code Review의 정밀도는 87.8%인데 재현율은 26.0%이고, 중대 결함만 보면 Codex가 81점으로 앞섭니다.
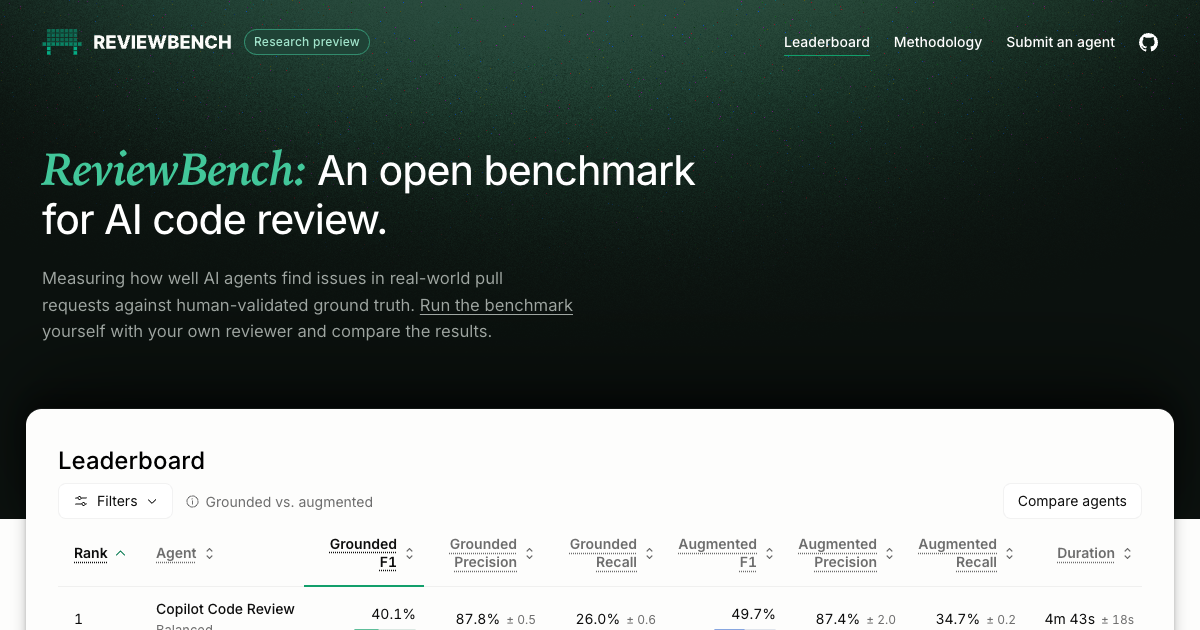
- GitHub이 공개 PR 219건으로 채점하는 ReviewBench를 열었습니다.
- 1위 Copilot은 지적의 87.8%가 맞지만 알려진 결함은 26.0%만 찾았습니다.
- 중대 결함만 보면 Codex가 81점, Copilot이 63점입니다.
GitHub이 10월 5일 ReviewBench를 공개했습니다. AI 코드 리뷰 봇이 실제 PR에서 결함을 얼마나 잡아내는지 재는 공개 시험입니다. 사람 리뷰어가 짚었을 법한 문제를 봇이 몇 개나 찾아내고 그중 몇 개가 헛다리였는지를 숫자로 내놓습니다.
공개 범위가 넓습니다. 공개 저장소 187곳에서 고른 PR 219건, 각 PR의 정답지, 채점 규칙서, 심판 모델 설정, 자기 에이전트를 직접 돌려보는 스크립트까지 전부 MIT 라이선스로 저장소에 올라와 있습니다. 언어는 19종이고 TypeScript가 68건으로 가장 많습니다. review-bench.ai에 리더보드가 함께 열렸습니다.
정밀도는 다 비슷하고, 재현율만 갈립니다
AI 코드 리뷰 도구는 Qodo가 7000만 달러를 받던 무렵부터 빠르게 늘었지만 서로를 같은 자로 잰 공개 숫자는 거의 없었습니다. 리더보드 기본 화면의 일곱 줄입니다. 2026년 10월 9일 조회 기준입니다.
| 순위 | 리뷰어 | 정밀도 | 재현율 | 실행일 |
|---|---|---|---|---|
| 1 | Copilot Code Review (Balanced) | 87.8% | 26.0% | 10월 1일 |
| 2 | Devin AI | 84.0% | 23.8% | 9월 28일 |
| 3 | Qodo | 85.3% | 22.1% | 9월 28일 |
| 4 | Codex (GPT-5.6 Sol, Max) | 86.0% | 18.5% | 10월 8일 |
| 5 | Cubic | 85.5% | 16.3% | 6월 29일 |
| 6 | Greptile | 86.1% | 16.2% | 6월 16일 |
| 7 | Cursor | 87.7% | 9.6% | 9월 27일 |
두 숫자부터 풀어 씁니다. 정밀도는 봇이 한 지적 중 진짜 문제였던 비율입니다. 높을수록 헛소리가 적습니다. 재현율은 그 PR에 이미 알려진 진짜 문제 중 봇이 찾아낸 비율입니다. 높을수록 빠뜨리는 게 적습니다.
정밀도는 일곱 도구가 84.0%에서 87.8% 사이에 다 몰려 있습니다. 가장 높은 곳과 낮은 곳의 차이가 4%p가 안 됩니다. 재현율은 1위 26.0%에서 7위 9.6%까지 세 배 가까이 벌어집니다. 리더보드 전체 28개 항목 중 최저는 Codex를 GPT-5.6 Terra의 Low 설정으로 돌린 5.7%입니다.
지금의 AI 코드 리뷰어는 말을 아끼는 쪽으로 맞춰져 있습니다. 입을 열면 대체로 맞지만 알려진 문제 네 건 중 세 건은 그냥 지나갑니다. 1위도 예외가 아닙니다. 리더보드에서 가장 먼저 챙길 내용이 이 한 줄입니다.
리더보드에는 Augmented 정밀도와 Augmented 재현율 열도 함께 있고 이쪽 숫자가 더 후합니다. Copilot의 Augmented 재현율은 34.7%입니다. 정답지에 없던 지적이라도 심판이 맞다고 보면 점수에 얹어 주는 방식이라 그렇습니다. 그런데 이 열로 도구끼리 순위를 매기면 안 된다고 방법론 문서에 적혀 있습니다. 에이전트가 새 지적을 많이 쏟아낼수록 분모가 함께 늘어나, 같은 실력이어도 점수가 올라가기 때문입니다. 도구 간 비교에 쓰라고 지정된 값은 앞 표의 재현율입니다.
총점 1위가 중대 결함 1위는 아닙니다
같은 리더보드를 결함 심각도별로 쪼개면 순위가 뒤집힙니다. 아래는 심각도별 F1 점수로, 정밀도와 재현율을 합쳐 하나로 만든 값입니다.
| 리뷰어 | 중대 | 보통 | 경미 |
|---|---|---|---|
| Codex (GPT-5.6 Sol, Max) | 81 | 61 | 25 |
| Copilot Code Review (Balanced) | 63 | 60 | 38 |
| Devin AI | 50 | 40 | 17 |
| Qodo | 45 | 48 | 26 |
| Cubic | 41 | 43 | 37 |
| Greptile | 36 | 37 | 30 |
총점 4위인 Codex가 중대 결함에서는 81점으로 1위고, 총점 1위 Copilot Code Review는 63점입니다. 대신 경미한 결함에서는 Copilot이 38점, Codex가 25점으로 뒤집힙니다. Copilot이 총점에서 앞선 이유는 중대 결함을 더 잘 잡아서가 아니라 경미한 결함까지 고루 집어서입니다.
결함 종류별로 봐도 갈립니다. 중대와 보통 결함만 놓고 잰 재현율에서, Codex는 정확성 50점과 안정성 49점으로 Copilot의 43점과 37점을 앞섭니다. 반대로 Copilot은 테스트 누락 54점과 유지보수성 23점으로 Codex의 26점과 8점을 크게 앞섭니다. 테스트 코드가 빠졌는지 봐주길 바란다면 Copilot, 로직이 틀렸는지 봐주길 바란다면 Codex입니다.
리뷰 봇을 고를 때 총점 순위 한 줄만 보면 이 차이가 통째로 지워집니다. 고를 기준은 순위가 아니라 내 저장소에서 놓치면 가장 아픈 결함이 무엇인가입니다.
이 숫자를 얼마나 믿을까
ReviewBench의 재현율은 "알려진 결함 중 몇 개를 찾았나"입니다. 그러니 정답지에 무엇이 들어 있는지가 숫자의 뜻을 정합니다.
저장소의 정답지 파일 219개를 직접 집계해 봤습니다. 전체 지적 4,632건 중 진짜 결함으로 분류된 것이 2,623건인데, 그 출처는 이렇습니다.
review-bench/ReviewBench 저장소 golden/*.json 219개 파일에서 tp_fp가 tp인 항목의 producer 필드 집계
정답지의 98%는 LLM 리뷰어가 쓴 지적이고, 사람 리뷰 코멘트에서 온 것은 39건뿐입니다. 사람이 PR에 남긴 코멘트 191건 중 152건은 범위 밖 관찰이나 사소한 지적으로 분류돼 정답에서 빠졌습니다. 발표문이 말하는 "사람이 검증한 정답지"는 사람이 지적을 썼다는 뜻이 아니라 분류기가 붙인 라벨을 사람이 감사했다는 뜻입니다. 그 감사에서 사람과 분류기의 TP 판정 일치율이 96.6%였고, 분류기가 잘못 붙인 47건을 사람이 고쳤습니다.
정답지가 어려운 문제만 모은 것도 아닙니다. 진짜 결함 2,623건을 난도별로 보면 쉬움이 1,311건, 보통이 1,073건이고 어려움은 239건(9.1%)뿐입니다. 심각도도 경미가 1,551건으로 절반을 넘습니다. 쉬운 쪽으로 기운 정답지에서 나온 숫자가 1위 26.0%입니다.
또 하나. 정답지 2,623건 중 1,185건(45.2%)은 ccr:로 표시된 생산자가 만들었습니다. GitHub은 발표문에서 Copilot code review를 CCR로 줄여 씁니다. 리더보드 1위 제품이 정답지의 45%를 만든 셈입니다.
GitHub이 이를 숨기지는 않습니다. 방법론 문서 8장에 생산자 편향과 분류기 의존이 적혀 있습니다. 원문은 이렇습니다.
분류기 프롬프트는 우리 워킹그룹의 취향을 담고 있으며, 다른 팀이 같은 방법론으로 분류기를 다르게 설정하면 같은 에이전트에 대해 다른 점수가 나올 수 있습니다.
리더보드 하단 고지도 마찬가지입니다. 최초 항목은 ReviewBench 팀이 각 벤더 제품을 직접 돌려 만들었고 벤더는 검증하지 않았으며, 결과가 "여러분의 코드에서의 성능을 예측하지 못할 수 있다"고 적혀 있습니다. 표의 실행일도 그래서 중요합니다. Cubic은 6월 29일, Greptile은 6월 16일 제품으로 잰 점수이고, 1위 Copilot은 10월 1일 제품입니다.
다른 공개 기준과 대조하면 순위가 달라집니다. Martian의 Code Review Bench는 실제 공개 PR에서 봇의 제안이 코드 변경으로 이어졌는지를 추적합니다. 최근 한 달 13,274건을 채점한 온라인 리더보드에서 GitHub Copilot은 5위입니다.
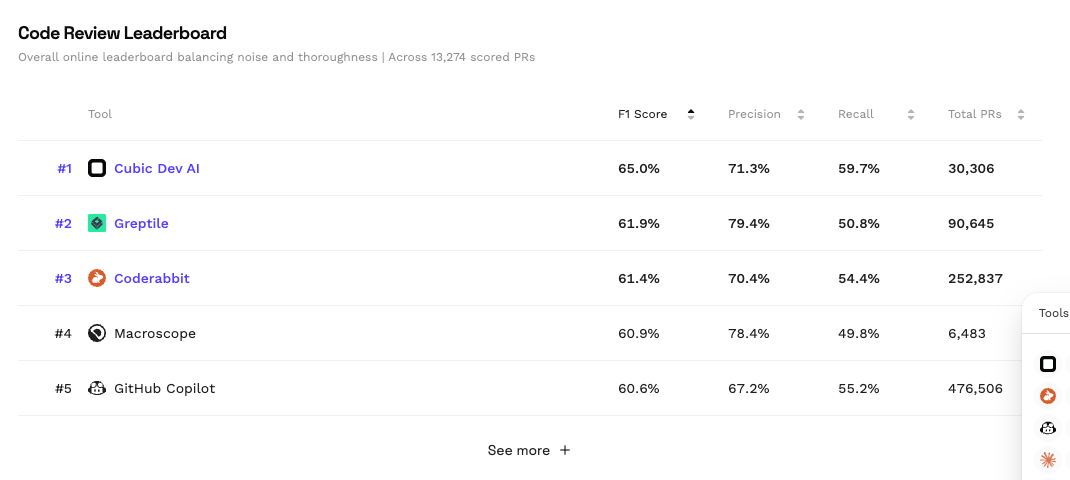
찾기 어려운 버그 50건으로 따로 잰 오프라인 리더보드에서도 Copilot은 5위(F2 58.0%)이고 1위는 Qodo Deep(65.1%)입니다. 반대로 ReviewBench에서 5위와 6위였던 Cubic과 Greptile은 Martian 온라인에서 1위와 2위입니다. 두 벤치마크는 애초에 다른 것을 잽니다. ReviewBench는 고정된 PR 219건에서 정답지와 대조하고, Martian은 수만 건의 실제 PR에서 개발자가 그 제안을 받아들였는지를 봅니다. 벤더가 자기 방식으로 잰 점수와 중립 조건의 점수가 벌어지는 일은 모델 벤치마크에서 이미 겪은 그대로입니다.
지금 직접 돌려볼 수 있나
방법은 둘입니다. 저장소를 받아 로컬에서 돌리는 쪽은 아무 자격도 필요 없고, 리더보드에 이름을 올리는 쪽은 제출 절차를 거칩니다.
| 항목 | 내용 |
|---|---|
| 대상 | 누구나. 데이터셋, 정답지, 채점 규칙서, 심판 프롬프트, 실행 스크립트가 MIT 라이선스 |
| 가격 | 데이터셋 무료. 튜닝과 테스트 실행은 본인 모델 키와 컴퓨트로 자비 부담. 리더보드 최종 제출 때의 공식 심판 비용만 ReviewBench가 부담 |
| 한국 사용 가능 | 가능. 지역 제한 고지 없음 |
| 로컬 실행 조건 | Docker, git, jq |
| 리더보드 등재 조건 | 에이전트 컨테이너를 GHCR에 digest로 고정해 올리고 review-bench.ai/submit에서 GitHub 계정으로 등록, 유지보수자 병합 대기 |
| 코퍼스 기여 | 불가. 새 PR 제출을 받지 않음 |
로컬 실행은 README의 세 줄이 전부입니다.
git clone https://github.com/review-bench/ReviewBench && cd ReviewBench
scripts/try-agent.sh my-reviewer:dev -e MY_API_KEY             # 테스트 세트 25건
scripts/try-agent.sh my-reviewer:dev --set full -e MY_API_KEY  # 전체 219건
어댑터는 PR 하나를 읽고 findings 파일 하나를 쓰면 됩니다. README에는 어떤 오픈소스 리뷰어가 약 90줄짜리 어댑터로 연결했다고 적혀 있습니다. 다만 try-agent.sh는 에이전트가 끝까지 돌아 올바른 형식의 결과를 내는지만 확인하고 점수는 매기지 않습니다. 점수는 npm run judge로 본인 모델 키를 써서 따로 내야 합니다.
사내 PR에 리뷰 봇을 이미 연결해 둔 팀이라면 테스트 세트 25건에 먼저 돌려 심각도별 성적부터 보면 됩니다. 중대 결함 쪽 점수가 낮게 나오면, 총점이 어떻든 그 봇을 믿고 사람 리뷰를 줄이면 안 됩니다.