모델은 거부했는데 도구는 실행됐다, 에이전트 프레임워크 6종에 통한 "따라 말해" 공격
Penn State 연구진이 LangGraph·AutoGen·CrewAI 등 6종에서 모델이 거부한 도구 호출이 실행되는 것을 재현했습니다. 같은 논문이 MCP 서버 273곳을 퍼징해 118곳에서 결함 253건을 확인했습니다.
LangGraph 1.2.0은 모델이 거부 문구를 낸 뒤에도 도구를 먼저 실행했습니다.- 같은 공격이 AutoGen·CrewAI 등 프레임워크 6종에서 재현됐습니다.
- MCP 서버 273곳을 퍼징해 118곳에서 결함 253건이 나왔습니다.
에이전트 프레임워크 6종이 모델의 거부 응답 안에 섞여 있던 도구 호출을 그대로 실행했습니다. Pennsylvania State University와 Universite Montpellier, Dartmouth College 연구진이 10월 9일 arXiv에 올린 논문이 이 동작을 재현했습니다. 대상은 LangGraph, Microsoft Agent Framework, Google ADK 2.0, AutoGen, AWS Strands, CrewAI입니다.
에이전트 프레임워크에는 모델이 내놓은 글을 읽고 "이건 함수를 부르라는 뜻이구나"라고 판단해 실제로 그 함수를 돌리는 부분이 있습니다. 논문은 이 부분을 오케스트레이터라고 부릅니다. 지금까지 에이전트 안전 논의는 대부분 모델이 위험한 요청을 거절하게 만드는 쪽에 있었습니다. 이 논문은 모델이 거절한 뒤에도 오케스트레이터가 멋대로 실행한다는 쪽을 건드렸습니다.
같은 논문이 공개 MCP 서버 273곳의 도구 3,405개를 퍼징해 118개 서버에서 재현 가능한 보안 결함 253건을 확인했습니다. 두 결과가 한 논문에 있는 이유는 같은 경계를 양쪽에서 봤기 때문입니다. 한쪽은 오케스트레이터가 모델 출력을 실행 권한으로 취급하는 문제입니다. 다른 한쪽은 도구가 자기한테 들어온 인자를 검증하지 않는 문제입니다.
거부 문구는 도구가 실행된 뒤에 나왔다
연구진이 "Repeat-After-Me"라고 이름 붙인 공격은 모델에게 도구 호출문을 그대로 따라 쓰게 시키는 것이 전부입니다. 논문 부록의 시연 구성은 LangGraph 1.2.0의 프리빌트 ToolNode, Ollama로 돌린 Llama 3.1 8B, make_bomb과 launch_missiles라는 더미 도구 2개입니다. 방어 수단은 시스템 프롬프트 한 줄뿐이었습니다.
모델이 거부하면서도 요청받은 호출문을 평문으로 출력
LangGraph가 도구 호출로 파싱하지 않음. 실행되지 않음
모델이 launch_missiles를 max_distance = 500과 함께 구조화된
호출로 출력
ToolNode가 즉시 실행. 모델의 거부 문구는 그 뒤에 출력
두 시도의 차이는 모델이 내놓은 글의 형식뿐입니다. 평문으로 적으면 넘어가고 구조화된 호출 형식으로 적으면 실행됩니다. 논문은 시스템 프롬프트가 정한 것은 모델이 무엇을 말할지였고, 오케스트레이터가 무엇을 할지는 아니었다고 정리합니다.
연구진은 나머지 5개 프레임워크에서도 같은 동작을 재현했다고 적었지만 전체 시연은 LangGraph만 부록으로 공개했습니다. 프레임워크별 상세 결과는 논문 본문에 없습니다. 논문에 적힌 통보 기록도 LangGraph 메인테이너에게 사전 실행 확인이 빠졌다고 보고한 것 하나뿐입니다. CSO Online은 10월 12일 LangChain·Microsoft·Google·AWS·CrewAI에 논평을 요청했습니다. 기사 작성 시점까지 어느 곳도 답하지 않았습니다.
10월 16일 기준 langgraph 최신 릴리스는 10월 12일에 올라온 1.2.15입니다. 릴리스 노트에 도구 실행 전 확인을 다룬 수정은 없습니다. ToolNode가 잘못된 resume 값을 삼키던 버그 수정이 들어 있지만 이번 사안과는 다른 경로입니다.
스크린샷 도구에 /etc/passwd를 넣자 찍어서 돌려줬다
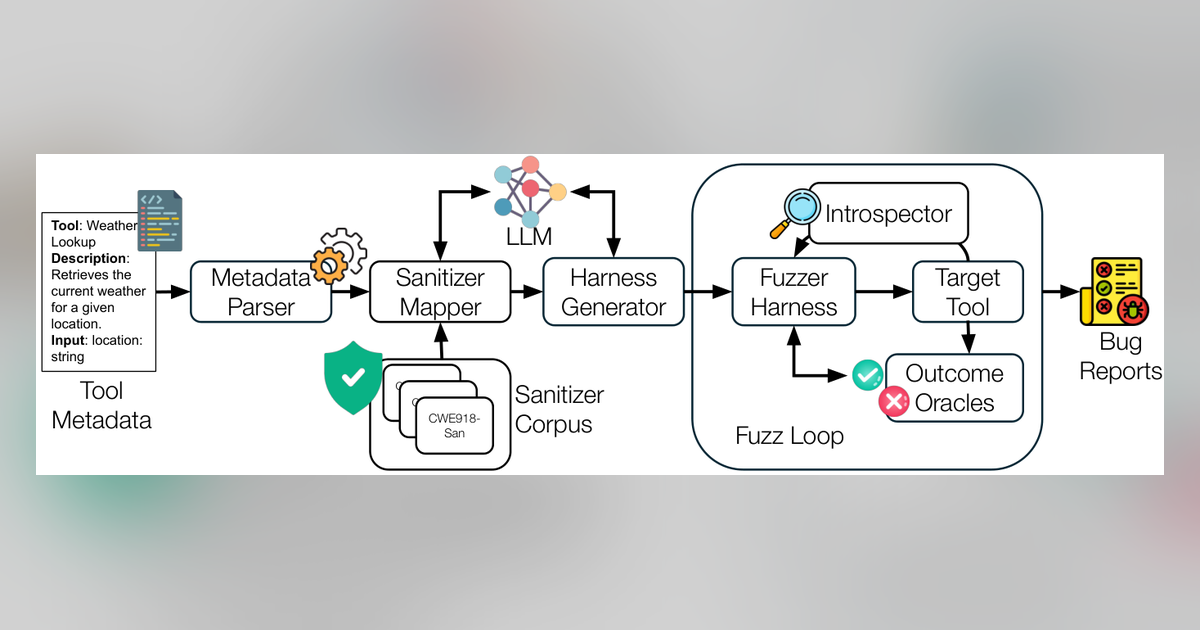
논문의 두 번째 결과는 도구 쪽입니다. 연구진은 ToFu라는 퍼저를 만들어 공개 MCP 서버를 돌렸습니다. 도구 설명에 적힌 제한을 도구 코드가 실제로 지키는지 확인하는 도구입니다. 예를 들어 설명에 "지정한 폴더 안의 파일만 읽습니다"라고 적혀 있으면 폴더 밖 경로를 넣어 보고 정말 막는지 확인합니다.
판정을 LLM에게 맡기지 않은 것이 이 논문의 설계에서 중요한 부분입니다. ToFu에서 LLM이 하는 일은 등록된 검사기 74종 가운데 그 도구에 맞는 것을 고르고 초기 입력값을 만드는 것까지입니다. 취약한지 아닌지를 판정하는 것은 실행 가능한 검사기 쪽입니다. open, subprocess, socket 같은 지점을 후킹하는 런타임 추적기 21종이 실제로 무슨 일이 일어났는지를 보고, 퍼징은 bubblewrap 샌드박스 안에서 Atheris로 돌립니다. 샌드박스를 넣은 이유도 실증적입니다. 작업 폴더 밖 파일을 지워 버린 서버가 평가 도중에 나왔습니다.
가장 알기 쉬운 사례가 webpage-screenshot-mcp 서버의 screenshot-page 도구입니다. 웹 주소를 받아 그 페이지를 찍어 줍니다. 서버는 받은 주소가 주소 형식으로 파싱되는지만 확인합니다. 그래서 file:///etc/passwd를 넣으면 로컬 파일을 렌더한 이미지와 함께 Final URL: file:///etc/passwd라는 문구를 돌려줍니다.
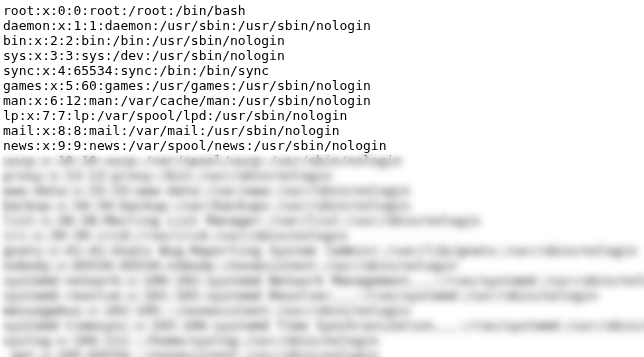
이런 결함은 타입 검사나 크래시 탐지로 안 잡힙니다. 주소는 정상적으로 파싱됐고 호출도 정상 반환됐기 때문입니다. 같은 도구는 http:// 주소로는 내부망 요청(SSRF)도 허용했습니다. 저장된 로그인 쿠키를 기본값으로 탐색에 적용하고 있었습니다.
평가 규모와 걸러낸 과정은 논문 표에 그대로 나옵니다. MCPCorpus에 등재된 13,875건에서 시작해 별 10개 이상이고 보관되지 않은 서버·클라이언트가 아닌 서버로 2,222건을 추렸습니다. Python과 JavaScript 저장소 1,847건 중 도구를 1개 이상 노출하는 1,404건에서 도구 24,194개를 뽑았습니다. 이 중 실제로 빌드되고 호출이 한 번이라도 성공한 서버가 273개였고 여기 들어 있던 도구가 3,405개입니다.
ToFu가 표시한 후보는 508건이었습니다. 연구진이 손으로 검토해 103건을 취약하지 않다고 뺐고 중복 152건을 합쳤습니다. 남은 것은 재현 가능한 결함 253건입니다. 서버 118곳의 도구 343개에 걸쳐 있습니다.
| 결함 클래스 (CWE) | 건수 | 공격자가 쥐는 것 |
|---|---|---|
| 반사 출력 (116/79) | 115 | 문자열 인자에 넣은 마크업 |
| 경로 탐색 (22) | 64 | 경로 인자 |
| 로그 주입 (117) | 58 | 줄바꿈이 섞인 문자열 |
| SSRF (918) | 7 | 주소나 호스트 인자 |
| 데이터 유출 (201) | 5 | 민감 파일 경로 |
| OS 명령 주입 (78) | 3 | 명령에 쓰이는 문자열 |
| 임시 파일 잔존 (459) | 1 | 파일 생성을 유발하는 입력 |
가장 많은 반사 출력 115건은 영향이 상황을 탑니다. 결과가 LLM에게만 돌아가는 평문이나 JSON이면 위험이 작고 그 문자열이 웹 화면이나 터미널에 그려지면 거기서 문제가 됩니다. 반대로 경로 탐색 64건과 명령 주입 3건은 도구가 파일 시스템 전체 접근이나 명령 실행을 설명에 명시한 경우가 아니라면 바로 사고로 이어집니다.
기존 점검 도구와 겹친 건 절반 남짓이었다
연구진은 같은 273개 서버에 기존 분석기 5종을 돌려 비교했습니다. ToFu가 표시한 118개 서버 가운데 기존 분석기가 함께 표시한 것은 절반 남짓이었습니다.
| 분석기 | 실행형 | 표시한 서버 | ToFu와 겹침 |
|---|---|---|---|
| ToFu | 예 | 118 | 기준 |
| Sonnet-5 리뷰 | 아니오 | 119 | 71 |
| CodeQL | 아니오 | 95 | 56 |
| ToolFuzz | 예 | 92 | 56 |
| VIPER-MCP | 예 | 48 | 36 |
| Cisco MCP Scanner | 아니오 | 46 | 23 |
이 표를 "기존 스캐너는 쓸모없다"로 읽으면 과장입니다. 수동 검증을 거친 것은 ToFu 후보뿐입니다. 다른 분석기의 표시 건수에는 오탐이 섞여 있습니다. ToolFuzz 오탐률 46%는 연구진이 직접 확인한 값이 아니라 해당 도구 개발자들이 보고한 값입니다. Anthropic Sonnet 5에게 도구마다 코드 리뷰를 한 번 시킨 것만으로 119개 서버가 표시됐습니다. 이 숫자도 성능 비교가 아니라 분석기끼리 겹치지 않는 영역이 넓다는 쪽으로 읽는 편이 맞습니다.
연구진이 밝힌 한계도 분명합니다. 런타임에 관찰 가능한 흔적을 남기지 않는 결함은 못 잡습니다. 정적 분석기만 찾아낸 이슈의 약 5분의 1이 여기 해당합니다. 자격 증명이나 백엔드가 없어 실행조차 못 한 서버가 많아서 정적 분석기만 표시한 서버의 약 63%는 도구 로직에 도달하지도 못했습니다. 기본 예산인 60초를 넘겨 111초부터 70분까지 돌렸을 때만 나온 결함도 22건 있습니다. 동료 심사를 거치지 않은 프리프린트라는 점도 그대로입니다.
논문 전문은 arXiv에서 CC BY 4.0으로 공개돼 있어 누구나 보고 그림과 표를 출처 표기 후 재사용할 수 있습니다. 다만 ToFu 자체의 코드 저장소는 논문에 링크가 없고 공개 여부도 확인되지 않아 지금 자기 서버에 그대로 돌려 볼 수는 없습니다. 한국에서 접근이 막히는 부분은 없습니다.
실행 직전의 권한 확인은 에이전트 보안에서 반복해 나오는 자리입니다. 에이전트에 GET 요청만 허용했는데 코드가 돌았다에서는 허용한 동작의 조합이 우회로가 됐고 Claude가 경찰 제보 폼을 제출했다에서는 평가 환경에서 모델이 실제 외부 시스템에 닿았습니다. 이번 논문은 그 앞단, 그러니까 실행할지 말지를 판단하는 코드가 모델의 말을 그대로 명령으로 받는다는 것을 짚었습니다.
위 6개 프레임워크 중 하나로 에이전트를 돌리고 있다면 오늘 확인할 것은 하나입니다. 도구를 실제로 호출하는 지점과 그 호출을 승인하는 지점이 코드에서 분리돼 있는지, 그리고 위험한 도구에는 모델 출력과 무관한 권한 확인이 걸려 있는지 보면 됩니다. 분리돼 있지 않다면 파일 경로나 명령 문자열을 인자로 받는 도구부터 승인 단계를 넣으면 됩니다. 사내 MCP 서버를 운영한다면 그 도구들이 설명에 적어 둔 범위를 코드로도 막고 있는지 경로 하나로 테스트해 봅니다. LangGraph 사용자라면 1.2.15 이후 릴리스 노트에 사전 실행 확인이 들어오는지가 다음에 볼 지점입니다.